








files.walk() 和 files.list() 的核心区别在于遍历范围:files.list() 仅返回指定目录下的直接子项(扁平结构),而 files.walk() 会递归遍历该目录及其所有子目录(树状结构)。在实现文件搜索或批量处理时,若只需处理当前层级的文件应使用 list();若需深入子目录查找内容则必须使用 walk()。两者均返回 stream<path></path>,但 walk() 涉及深层 io 操作,需注意资源释放。
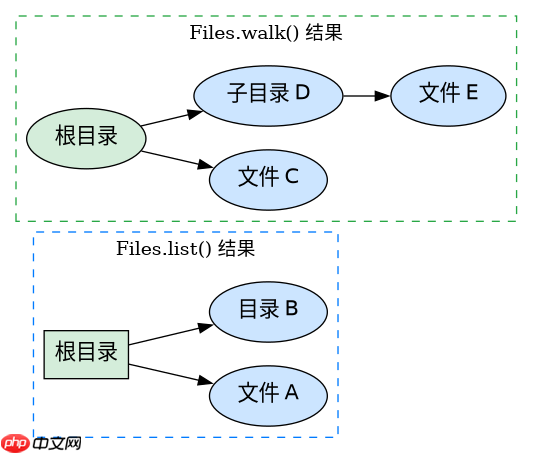
Files.list() 的扁平遍历行为
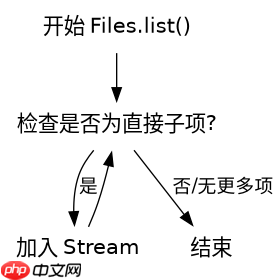
Files.list() 方法严格限制在单一层级内工作,它不会进入任何子文件夹。调用该方法时,流中只包含目标路径下的直接子文件和子目录对象。这种设计适用于只需要获取当前目录列表的场景,例如生成目录索引或清理当前文件夹下的临时文件。由于不涉及递归,其性能开销相对较小且逻辑简单。
import java.nio.file.*;
import java.util.stream.Stream;

public class ListDemo {
    public static void main(String[] args) throws Exception {
        Path dir = Paths.get("./test_dir");
        // 仅列出直接子项
        try (Stream<Path> stream = Files.list(dir)) {
            stream.forEach(p -> System.out.println(p.getFileName()));
        }
    }
}
Files.walk() 的递归遍历行为
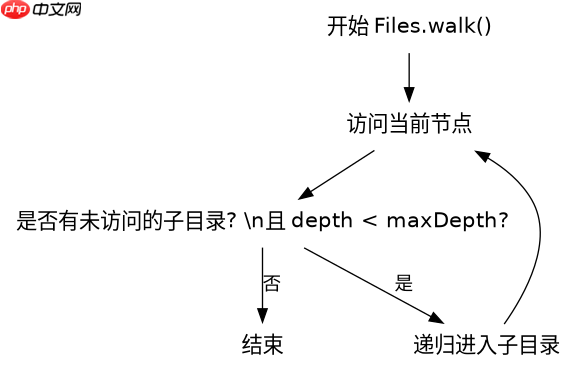
Files.walk() 方法执行深度优先或广度优先的递归遍历,能够访问指定目录下的所有嵌套子目录和文件。默认情况下,它会遍历整个子树结构。这对于需要全局搜索特定文件、统计所有子目录大小或进行全量备份的任务至关重要。需要注意的是,walk() 可能会抛出 AccessDeniedException 如果权限不足,且必须通过 try-with-resources 确保流被正确关闭以释放系统资源。

立即学习“Java免费学习笔记(深入)”;
import java.nio.file.*;
import java.util.stream.Stream;

public class WalkDemo {
    public static void main(String[] args) throws Exception {
        Path dir = Paths.get("./test_dir");
        // 递归遍历所有层级
        try (Stream<Path> stream = Files.walk(dir, 10)) {
            stream.filter(Files::isRegularFile)
                  .forEach(p -> System.out.println(p));
        }
    }
}
基于 maxDepth 参数控制 Files.walk() 的遍历深度
在使用 Files.walk() 时,可以通过传入 maxDepth 参数来精确控制递归的深度,从而模拟类似 list() 的行为或限制遍历范围。当 maxDepth 设置为 0 时,Files.walk() 的行为与 Files.list() 完全一致,仅返回根目录本身;当设置为 1 时,返回根目录及其直接子项。这一特性使得开发者可以在不切换 API 的情况下,灵活调整遍历粒度,避免不必要的深层 IO 消耗。


















