








在 java 字节流与字符流中,pushbackinputstream 用于实现“回退”功能,允许程序将已读取的字节重新推回流中以便后续再次读取。具体做法是实例化 pushbackinputstream 并包裹目标输入流,调用其 unread() 方法即可将字节或字节数组放回缓冲区。这样做通常用于处理需要预读(lookahead)的场景,例如解析文本时判断下一个字符类型后决定解析策略。
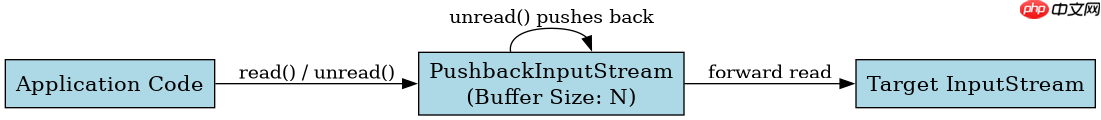
PushbackInputStream 如何包装字节流并执行回退操作?
要使用 PushbackInputStream,只需将其构造函数中的参数设为待包装的 InputStream 对象。默认缓冲区大小为 1 字节,也可指定更大容量以支持多字节回退。调用 unread(byte[] b) 会将整个数组按逆序放入缓冲区,而 unread(int b) 则只放入单个字节。当后续调用 read() 时,会优先从缓冲区取出数据,而非直接访问底层流。
import java.io.*;

public class PushbackExample {
    public static void main(String[] args) throws IOException {
        // 模拟一个包含 "AB" 的字节流
        ByteArrayInputStream bais = new ByteArrayInputStream("AB".getBytes());

        // 包装为 PushbackInputStream,设置缓冲大小为 2
        PushbackInputStream pbis = new PushbackInputStream(bais, 2);

        // 读取第一个字节 'A'
        int firstByte = pbis.read();
        System.out.println("Read: " + (char)firstByte); // 输出 A

        // 将 'A' 推回流中
        pbis.unread(firstByte);

        // 再次读取,应该还是 'A'
        int secondByte = pbis.read();
        System.out.println("Re-read: " + (char)secondByte); // 输出 A

        // 继续读取,得到 'B'
        int thirdByte = pbis.read();
        System.out.println("Next: " + (char)thirdByte); // 输出 B
    }
}
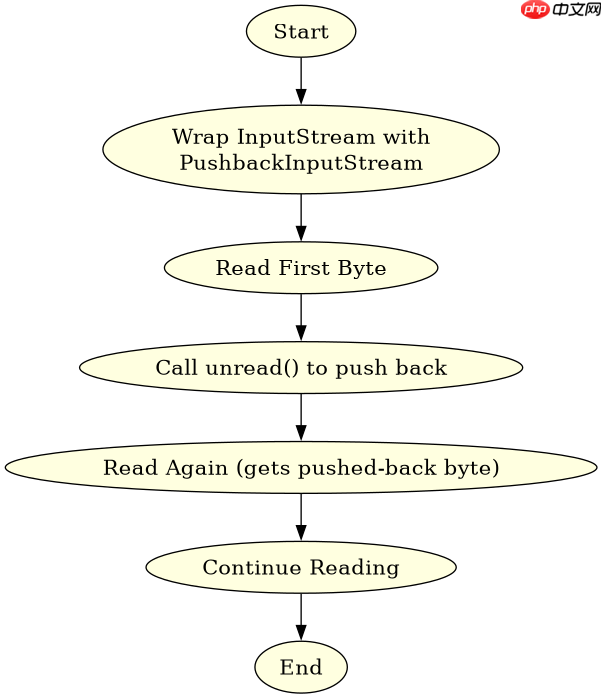
上述代码展示了基本用法:先读一个字节,再将其推回,随后再次读取确认回退生效。预期结果为依次打印 A、A、B。这验证了 unread() 确实改变了后续 read() 的行为。注意,PushbackInputStream 仅适用于字节流,若需字符级回退应使用 PushbackReader。
立即学习“Java免费学习笔记(深入)”;

为什么选择 PushbackInputStream 而不是手动缓存?
相比手动维护缓冲区或使用 ByteArrayInputStream 预加载全部内容,PushbackInputStream 提供了轻量级的回退机制,特别适合流式数据处理场景。它不会一次性加载所有数据到内存,而是按需读取并支持局部回退,从而节省内存开销。此外,它自动管理缓冲区状态,开发者无需关心索引移动或边界检查。
import java.io.*;

public class StreamComparison {
    public static void main(String[] args) throws IOException {
        String data = "Hello World";
        ByteArrayInputStream bais = new ByteArrayInputStream(data.getBytes());

        // 方式一:使用 PushbackInputStream
        PushbackInputStream pbis = new PushbackInputStream(bais);
        int ch = pbis.read();
        if (ch == 'H') {
            pbis.unread(ch); // 回退
            System.out.println("Pushback: read again -> " + (char)pbis.read());
        }

        // 重置流
        bais.reset();

        // 方式二:手动缓存(伪代码逻辑)
        // byte[] buffer = new byte[1];
        // bais.read(buffer);
        // if (buffer[0] == 'H') {
        //     // 需要额外逻辑来“回退”,比如保存位置或复制数据
        // }
    }
}
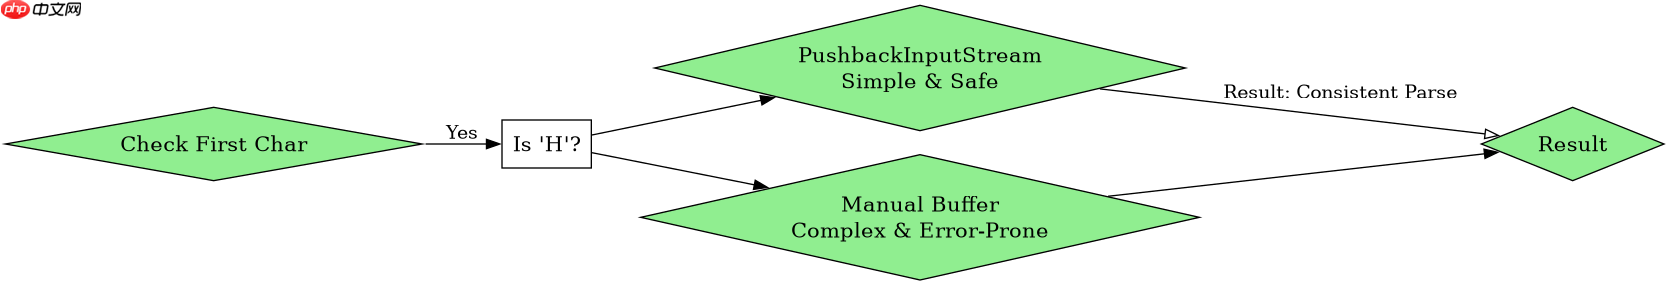
通过对比可见,PushbackInputStream 简化了回退逻辑,避免了手动管理读取位置和缓冲区的复杂性。在示例中,当检测到首字符为 'H' 时,可安全回退并重新读取,确保后续解析一致性。而手动方式需自行处理状态同步,易出错且代码冗长。因此,在需要简单预读和回退的场景下,PushbackInputStream 是更优选择。
如果回退的字节数超过缓冲区大小会发生什么?
当尝试回退的字节数超过 PushbackInputStream 初始化时指定的缓冲区大小时,会抛出 IOException。例如,若创建时设置缓冲大小为 1,但调用 unread(new byte[]{1, 2}) 试图回退两个字节,系统将拒绝该操作并报错。这是为了防止缓冲区溢出导致数据损坏或不可预测行为。开发者应在调用 unread() 前确保回退内容长度不超过缓冲区容量,或通过捕获异常进行容错处理。


















