








php强制下载文件时出现乱码,通常是因为http响应头中的`content-type`或`content-disposition`字段未正确设置为utf-8编码,或者文件内容本身包含非ascii字符(如中文文件名)时未进行url编码。解决此问题的核心做法是:在输出二进制流前,显式设置`header('content-type: application/octet-stream')`,并将`content-disposition`中的文件名使用`rawurlencode()`处理,同时确保php脚本文件的保存编码与输出编码一致(推荐utf-8),且不要输出任何bom头或非预期空白字符。

Content-Disposition中中文文件名导致浏览器解析错误
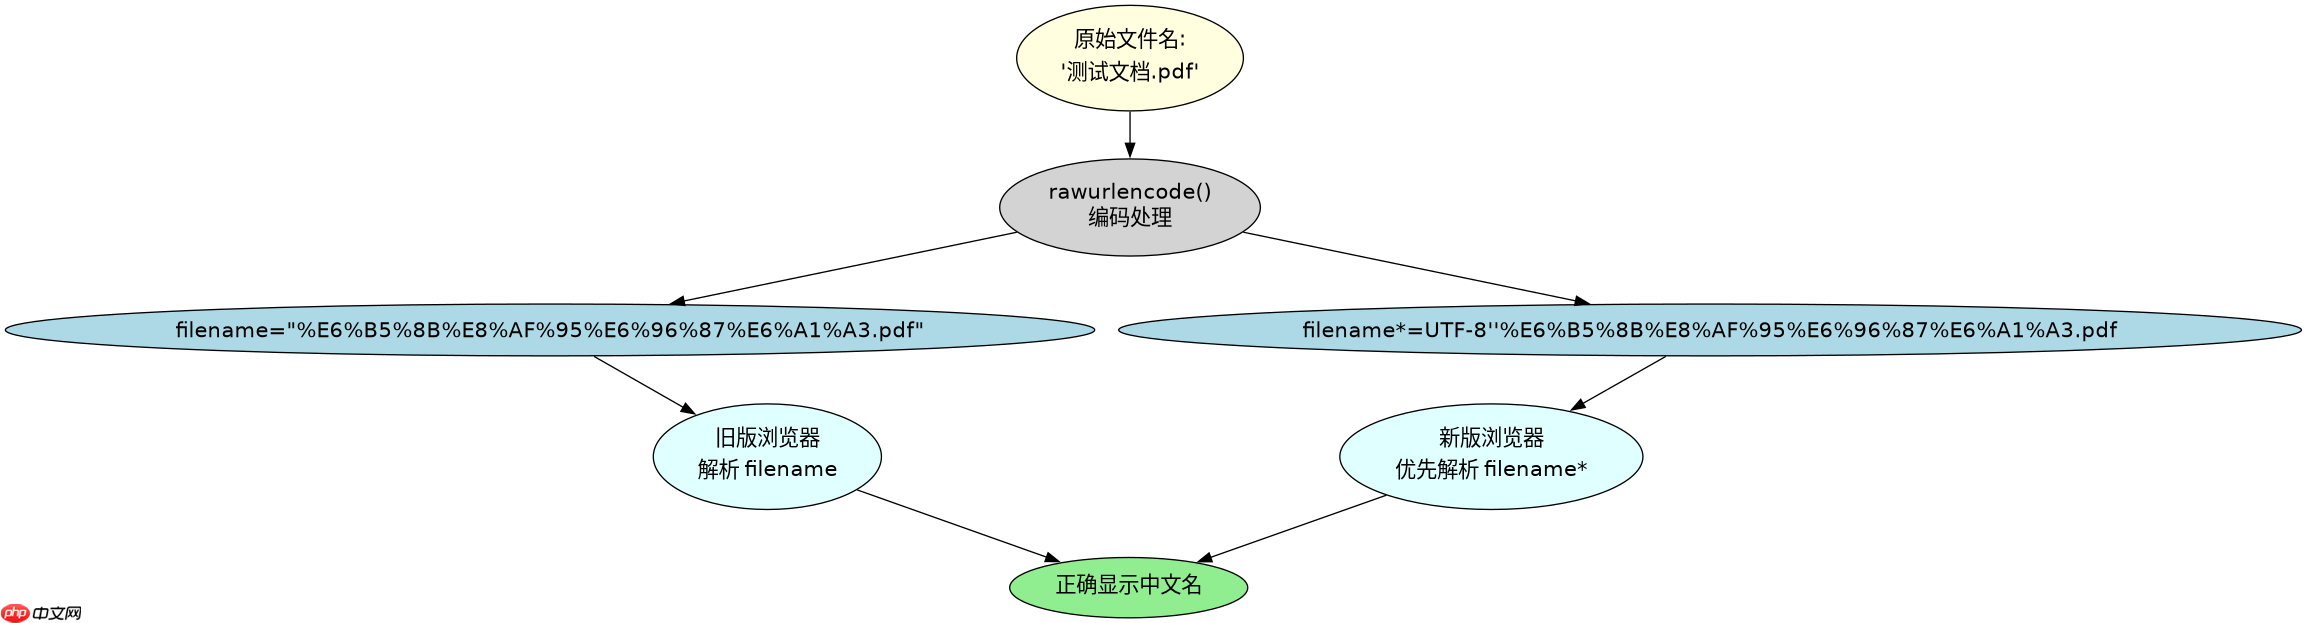
当文件名包含中文等非ASCII字符时,如果直接将其放入`Content-Disposition`头部的`filename`参数中,浏览器可能无法正确解码,从而显示乱码或截断文件名。这是因为HTTP/1.1标准对Header中的字符集有严格限制,而不同浏览器对非ASCII字符的处理策略不一致。正确的做法是使用RFC 6266定义的`filename*`参数,或者对所有文件名进行URL编码后放入`filename`参数。
<?php
// 假设 $filePath 是服务器上的实际文件路径
$filePath = '/path/to/your/file.pdf';
$fileName = '测试文档.pdf'; // 包含中文的文件名

if (file_exists($filePath)) {
    // 1. 设置 MIME 类型
    header('Content-Type: application/octet-stream');

    // 2. 处理文件名编码
    // 方法一:通用兼容方式,使用 rawurlencode
    $encodedName = rawurlencode($fileName);
    header("Content-Disposition: attachment; filename=\"{$encodedName}\"; filename*=UTF-8''{$encodedName}");

    // 3. 设置文件大小
    header('Content-Length: ' . filesize($filePath));

    // 4. 清除缓冲区并输出文件
    ob_clean();
    flush();
    readfile($filePath);
    exit;
} else {
    http_response_code(404);
    echo 'File not found';
}
?>
上述代码首先检查文件是否存在,然后设置标准的二进制流类型。关键在于`Content-Disposition`头的构造,它同时提供了`filename`和`filename*`两个属性。`filename`使用了`rawurlencode()`对中文进行了编码,确保所有浏览器都能识别;`filename*`则明确指定了UTF-8编码,供现代浏览器优先使用。最后通过`readfile`直接输出文件内容,避免了手动读取带来的内存问题。
立即学习“PHP免费学习笔记(深入)”;

输出缓冲或BOM头干扰导致下载文件损坏或乱码
即使Header设置正确,如果PHP脚本在发送Header之前输出了任何内容(包括空格、换行、警告信息或UTF-8 BOM头),都会导致Header发送失败或内容被污染。这会导致浏览器将HTML错误页面当作文件下载,或者下载的文件头部包含额外的字节,从而造成文件损坏或打开时显示乱码。必须确保在调用`header()`函数之前没有任何输出,并在输出文件流前清理缓冲区。

<?php
// 确保没有BOM头,文件保存为无BOM的UTF-8
// 这里模拟一个可能的错误场景对比

function download_with_error() {
    // 错误示范:在header前输出了一行日志或空格
    echo "Starting download..."; // 这行会导致header失效
    header('Content-Type: application/pdf');
    readfile('test.pdf');
}

function download_correct() {
    // 正确做法:先清理缓冲区,再发header
    if (ob_get_level()) {
        ob_end_clean();
    }

    header('Content-Type: application/octet-stream');
    header('Content-Disposition: attachment; filename="clean_file.txt"');
    header('Cache-Control: no-cache, must-revalidate');

    echo "This is a clean text file.";
}

// 执行正确版本
download_correct();
?>
在正确的实现中,我们首先检查并清空输出缓冲区(`ob_end_clean()`),以消除任何潜在的预输出。接着设置`Cache-Control`头以防止浏览器缓存导致的内容混淆。对于纯文本或特定格式文件,直接`echo`内容即可。关键在于顺序:必须先处理所有逻辑判断和缓冲区清理,再发送任何Header,最后才是数据输出。如果在调试过程中发现乱码,应检查编辑器是否自动添加了BOM,或在代码开头加入`ob_clean()`强制清除。
基于`readfile`返回值为0时的具体排查
当使用`readfile()`函数下载文件时,如果返回值为0或false,但文件明明存在,这通常意味着文件权限不足或路径错误,而非单纯的编码问题。在这种情况下,浏览器可能接收到空内容或错误页面,进而表现为“下载失败”或“乱码”。需要具体检查`file_exists()`和`is_readable()`的结果,并确保Web服务器进程(如www-data或nginx用户)拥有该文件的读取权限。



















