








php强制下载文件内容被截断通常是因为输出缓冲未正确清理或二进制数据在传输过程中被意外编码。解决这个问题的核心做法是:在发送文件内容前,使用 ob_clean() 和 flush() 清除所有缓冲区残留,设置正确的 content-type 为 application/octet-stream,并使用 readfile() 直接读取并输出文件流,避免手动拼接字符串导致的数据丢失。

为什么常规输出方式会导致文件截断?
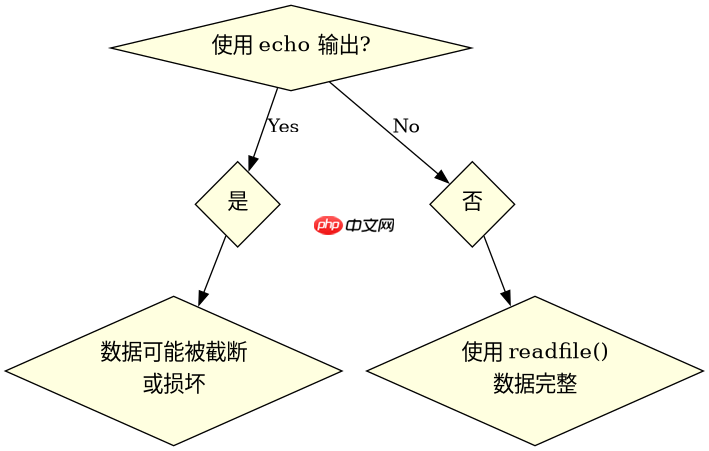
常规使用 echo 或 print 输出文件内容时,如果中间插入了 HTML 标签、空格或调试信息,或者服务器开启了 Gzip 压缩,都会破坏二进制数据的完整性。此外,PHP 的输出缓冲机制可能会将数据分块发送,若未正确处理,会导致接收端认为连接提前关闭。通过对比发现,直接使用 readfile() 配合严格的头部设置能绕过大部分缓冲问题。
header('Content-Description: File Transfer');
header('Content-Type: application/octet-stream');
header('Content-Disposition: attachment; filename="example.zip"');
header('Expires: 0');
header('Cache-Control: must-revalidate');
header('Pragma: public');
header('Content-Length: ' . filesize('example.zip'));
ob_clean();
flush();
readfile('example.zip');
上述代码中,Content-Length 必须准确匹配文件大小,否则浏览器可能等待更多数据直到超时。 ob_clean() 确保没有之前的 HTML 输出混入二进制流。运行此代码后,下载的文件将是完整且未被截断的原始文件。
立即学习“PHP免费学习笔记(深入)”;

如何处理大文件以避免内存溢出导致的截断?
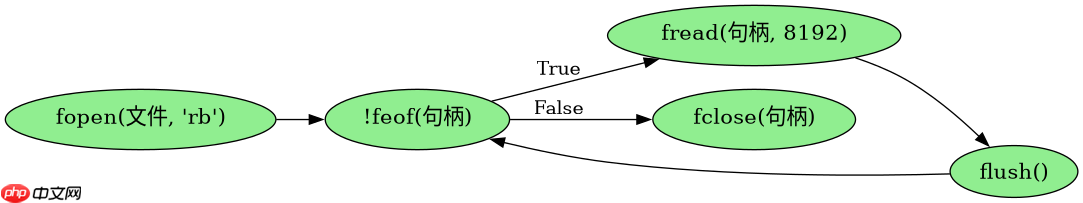
对于大文件,一次性加载到内存或使用某些流式处理库可能导致内存耗尽,进而引发截断。最佳实践是使用分块读取的方式,每次只读取一小部分(如 8KB)并立即输出。这种方法不仅节省内存,还能提高大文件下载的稳定性。与一次性读取相比,分块读取需要手动控制循环和缓冲区刷新。
$handle = fopen('large_file.bin', 'rb');
if ($handle) {
    while (!feof($handle)) {
        echo fread($handle, 8192);
        flush();
    }
    fclose($handle);
}
在这个示例中,fopen 以只读二进制模式打开文件,fread 每次读取 8192 字节。 flush() 强制将当前缓冲区内容发送到客户端,防止因缓冲区满而阻塞。这种方式适用于任何大小的文件,特别是那些超过 PHP 内存限制的文件。确保服务器配置允许长运行脚本,并检查 max_execution_time 是否足够。
当文件名包含特殊字符时如何确保下载正常?
如果文件名中包含非 ASCII 字符(如中文),浏览器可能无法正确解析 Content-Disposition 头,导致下载失败或文件名乱码。解决方案是使用 RFC 5987 标准编码文件名,即在 filename*=UTF-8''... 格式中提供 UTF-8 编码的文件名。这比传统的 filename=... 更可靠,尤其针对现代浏览器。


















