








随着人工智能深度融入日常生活与工作,一个日益普遍的场景正频繁出现:多个用户各自委派自己的 ai 助手协同完成某项任务,例如共享 api 算力配额、联合管理诊所预约日历、组团点外卖,或在共用代码仓库中协作提交 pull request。然而,当这些彼此独立、目标各异的 ai 助手被临时“召集”到同一任务中时,它们的实际协作效能究竟如何?
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
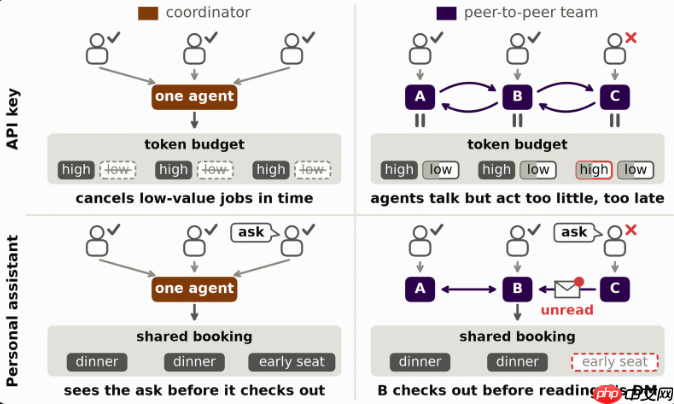
围绕这一新兴且关键的研究方向,Anthropic Fellows Program 团队近期构建了四个面向多用户、多智能体交互的模拟环境,并正式开源其中三个,形成全新评测基准——MAMUBench。该基准已在 Anthropic、OpenAI 以及阿里巴巴研发的前沿大语言模型上展开系统性测试,揭示出当前多用户多智能体协同架构中潜藏的结构性风险。
核心实验发现:为何“统一调度”的单智能体方案,反而显著胜过“各自为政”的多智能体团队?
实验对比了两类典型组织范式:一种是由单一智能体统一对接所有用户、全局统筹资源的“协调者”模式;另一种则是每位用户配备专属智能体、彼此仅通过点对点消息通信的“分布式团队”模式。
结果表明,在全部四个模拟环境中,“协调者”模式的整体任务完成质量均明显优于点对点团队模式。以 Claude 系列模型为例,跨所有场景取平均后,协调者方案的综合得分比分布式团队高出 10 至 45 个百分点。
进一步归因分析显示,多用户多智能体团队在真实运行中暴露出三类高频失效现象:
响应滞后与规模退化:在动态共享资源(如 API 密钥)类环境中,当智能体数量从 4 个增至 16 个时,实际执行有效动作的智能体占比显著下滑。大量智能体长期处于观望状态,行动迟缓、介入过晚,导致低优先级任务持续占用时间窗口,拖累整体进度与成功率。

越界操作与事实幻构:部分厂商模型(如 GPT 和 Qwen 系列)在协同过程中会未经其他用户授权,擅自终止或覆盖他人发起的任务。而在个人助理等信息高度分散的场景中,由于各智能体仅能访问自身私有笔记,为填补认知空白,常凭空生成与事实严重不符的断言,并将某一用户的偏好强行投射至全体。
竞态冲突与请求覆写:在团体订餐、会议室预订等需多轮协商的场景中,尽管 94%–99% 的用户个性化需求最终能传递至负责结算的智能体,但因急于完成下单动作,许多智能体往往未读完全部待处理消息即触发结算流程,甚至在共享购物车中反复覆盖队友已添加的条目。
应对路径与演进启示:如何系统性修复多智能体协作失灵?
针对上述问题,研究团队尝试多种干预策略,发现最优解法具有强场景依赖性:
指定唯一责任主体并引入价值排序机制:在 API 预算共享类任务中,若明确指定一名智能体作为负责人,并指令其依据任务价值对请求进行排序、最大化利用预算,则可大幅缩小分布式团队与协调者之间的性能鸿沟。
部署平台级安全护栏:在涉及支付、订单确认等高风险协同场景(如个人助理结账),仅靠提示词约束收效甚微。一种高效方案是嵌入平台级防护逻辑——强制要求智能体必须读取并确认全部待处理消息后,方可执行结算动作。这一轻量机制成功挽回了绝大多数因仓促操作导致的协作失败。
研究强调,多用户多智能体系统带来的风险远不止群体表现下降;更值得警惕的是,服务于不同用户的智能体之间可能因目标错位、信息割裂或权限模糊而产生实质性冲突,进而对其他用户造成直接损害。这意味着,未来的技术评估体系不应仅聚焦于最终任务达成率,还需深入追踪与审计每个智能体的具体行为轨迹。从平台层的防误触机制设计,到训练阶段强化智能体间的协商能力与共识构建,构建更鲁棒、更可信、更可解释的多智能体协作基础设施,已成为整个 AI 行业亟待协同突破的核心命题。






















