








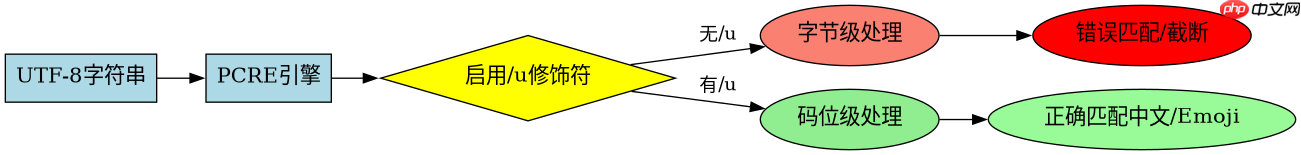
php正则的u修饰符用于启用utf-8模式,确保正则引擎将字符串视为utf-8编码的多字节字符序列,从而正确处理中文和emoji等超出ascii范围的字符。在使用/u修饰符时,.、[a-z]等元字符会匹配完整的unicode码位而非单个字节,避免中文乱码或匹配截断问题。例如,匹配中文字符应使用/[\x{4e00}-\x{9fa5}]/u,匹配emoji需结合unicode范围或属性类如/\p{emoji}/u。
如何正确匹配中文字符串?
匹配中文字符串时,必须使用/u修饰符配合Unicode范围表达式,否则preg_match可能因多字节截断导致错误结果。核心做法是定义包含CJK统一表意字符范围的字符类,并在正则末尾添加u标志。
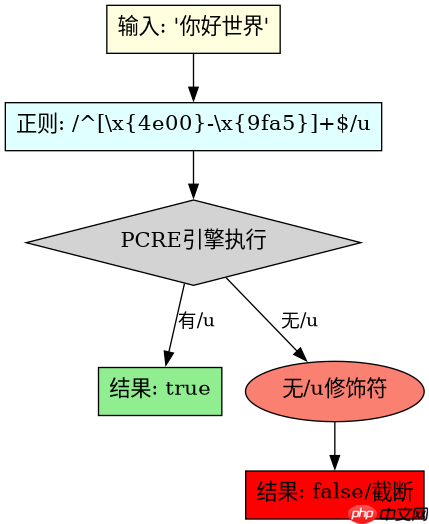
$pattern = '/^[\x{4e00}-\x{9fa5}]+$/u';
$subject = '你好世界';
if (preg_match($pattern, $subject)) {
    echo "匹配成功";
}上述代码中,\x{4e00}-\x{9fa5}覆盖了基本汉字区,u修饰符使PCRE引擎以UTF-8方式解析。若去掉u,.或[a-z]可能只匹配单字节,导致中文被拆分为多个部分而匹配失败。实际运行中,输入'你好世界'会返回true,而输入'hello'则返回false。
立即学习“PHP免费学习笔记(深入)”;

如何正确匹配Emoji表情符号?
匹配Emoji需依赖Unicode属性类\p{Emoji}或显式范围,并同样需要/u修饰符支持。由于Emoji由多个码点组成(如组合序列),建议使用\X(Unicode扩展图形簇)或\p{Emoji}进行整体匹配。
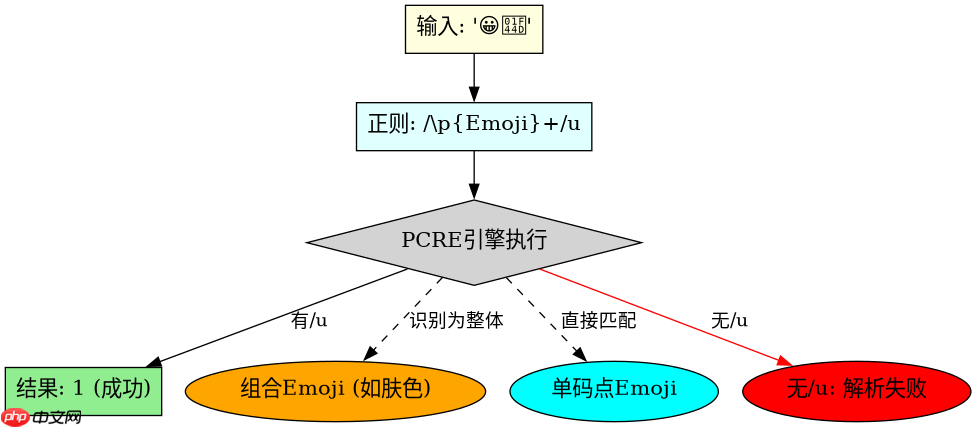
$pattern = '/\p{Emoji}+/u';
$subject = '??';
if (preg_match($pattern, $subject)) {
    echo "匹配成功";
}该示例中,\p{Emoji}匹配所有Emoji字符,u修饰符确保引擎按UTF-8处理多字节序列。输入'??'时,preg_match返回1,表示成功匹配整个Emoji序列。若未加u,部分Emoji可能被识别为非法字节序列而匹配失败。注意:某些复杂Emoji(如肤色修饰符)属于组合序列,\p{Emoji}能正确将其视为一个单元。
当输入包含混合中英文和Emoji时,正则如何行为?
当输入同时包含中文、英文和Emoji时,/u修饰符确保各类型字符均按完整Unicode码位处理,不会发生字节级截断。例如,正则/[\w\p{Emoji}]+/u可匹配混合内容,其中\w匹配字母数字及下划线,\p{Emoji}匹配Emoji,u保障UTF-8语义。
$pattern = '/^[\w\p{Emoji}]+$/u';
$subject = '你好?world';
var_dump(preg_match($pattern, $subject)); // 输出: int(1)此例中,'你好?world'被完整匹配,返回1。若移除u,\p{Emoji}可能无法正确解析多字节Emoji,导致匹配失败或部分匹配。验证显示:\w在u模式下仍仅匹配ASCII字母数字,中文和Emoji需显式用\p{...}或范围表达。因此,混合内容匹配需明确指定各类字符的Unicode类别,并始终启用u修饰符。


















