








规划数据库服务器内存的核心在于平衡操作系统开销、数据库内部缓存需求以及应用程序的连接消耗。直接的做法是依据业务负载类型(oltp或olap)和预期并发量,将物理内存的70%-80%分配给数据库实例,剩余部分留给操作系统和其他服务。这种分配方式能确保数据库在内存中持有尽可能多的热数据,减少磁盘i/o。
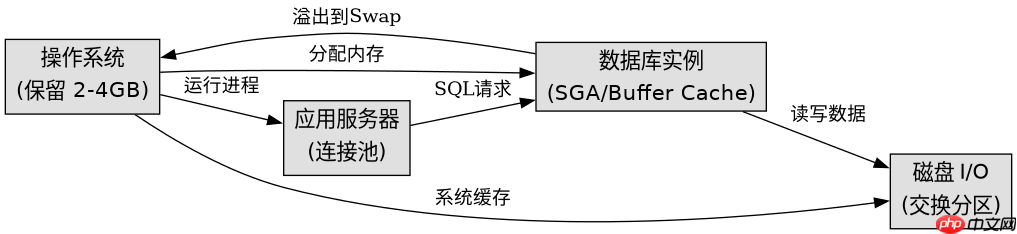
内存结构划分原则
不同数据库引擎对内存的管理机制不同,但总体逻辑一致。以Oracle为例,主要涉及系统全局区(SGA)和程序全局区(PGA)。SGA是共享内存区域,用于存储数据字典缓存、重做日志缓冲区等;PGA则是每个服务器进程私有的内存空间,用于排序、哈希连接等操作。MySQL则主要依赖InnoDB缓冲池(Buffer Pool)来缓存数据和索引。
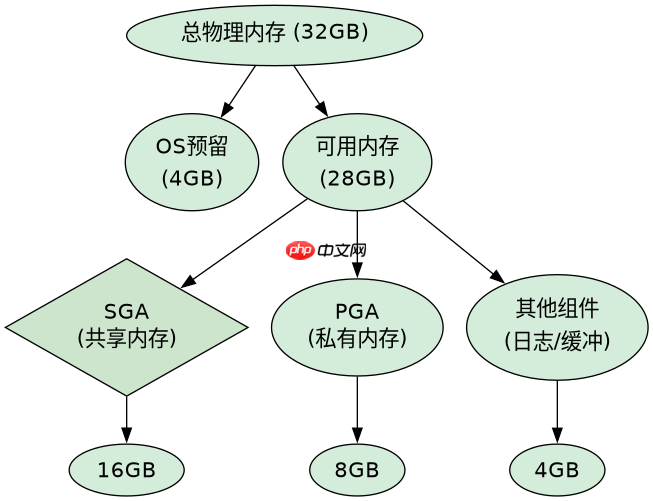
在实际操作中,需要避免“全给数据库”的误区。操作系统本身需要内存来管理文件缓存、网络栈和内核线程。如果数据库占用了过多内存导致系统频繁使用Swap交换分区,性能会急剧下降。一般建议保留2-4GB给操作系统,具体数值取决于系统复杂度和后台进程数量。对于大型OLAP系统,由于涉及大量排序和聚合操作,PGA的需求会显著增加,需相应调整比例。

动态调整与监控策略
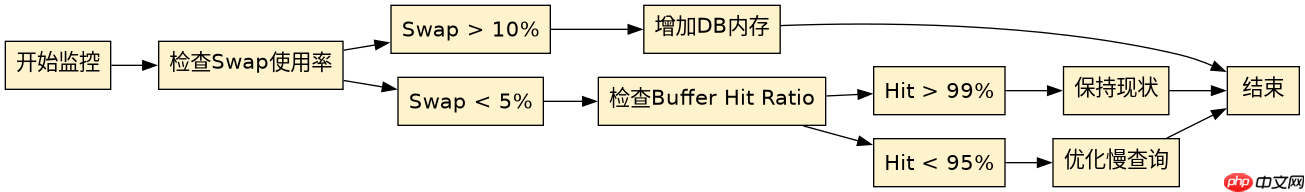
静态规划往往无法应对突发流量或长期增长,因此建立基于指标的动态调整流程至关重要。通过监控Swap使用率和缓冲命中率,可以判断当前内存配置是否合理。当Swap使用率持续高于阈值时,表明物理内存不足,需扩容或优化;当缓冲命中率低于标准时,说明热点数据无法完全驻留内存,同样需要增加内存或优化SQL。
# 模拟监控脚本:检查内存状态并输出建议
import psutil
import os

def check_memory_health():
    # 获取系统内存信息
    mem = psutil.virtual_memory()
    swap = psutil.swap_memory()

    # 定义阈值
    SWAP_WARN_THRESHOLD = 0.10  # 10%
    HIT_RATIO_TARGET = 0.95     # 95%

    print(f"总内存: {mem.total / (1024**3):.2f} GB")
    print(f"已用内存: {mem.used / (1024**3):.2f} GB")
    print(f"Swap使用率: {swap.percent}%")

    # 逻辑判断
    if swap.percent > SWAP_WARN_THRESHOLD:
        return "警告: Swap使用率过高,建议增加物理内存或优化内存泄漏"
    elif mem.percent > 85:
        return "注意: 物理内存使用率高,但未触发Swap,可观察趋势"
    else:
        return "正常: 内存资源充足"

if __name__ == "__main__":
    status = check_memory_health()
    print(status)
上述Python脚本展示了如何获取系统级内存指标。在实际生产环境中,应结合数据库特定的视图(如Oracle的V$PGASTAT或MySQL的SHOW ENGINE INNODB STATUS)进行综合判断。该脚本仅作为基础参考,实际部署时需集成到监控平台(如Prometheus+Grafana)以实现自动化告警。通过定期运行此类检查,运维团队可以提前发现内存瓶颈,避免在生产高峰期出现性能抖动。
特定场景下的内存调优
针对高并发短事务场景,连接数激增会导致PGA内存迅速耗尽。此时,单纯增加总内存可能效果有限,因为每个新连接都会占用固定的PGA配额。解决思路是限制最大连接数,或使用连接池复用连接。例如,在PostgreSQL中,可通过调整max_connections参数并结合pgbouncer中间件,将应用层的连接压力转移到少数几个后端连接上,从而稳定内存占用。同时,检查是否有未提交的事务长时间持有锁和内存,及时清理僵尸会话也是关键步骤。

















