








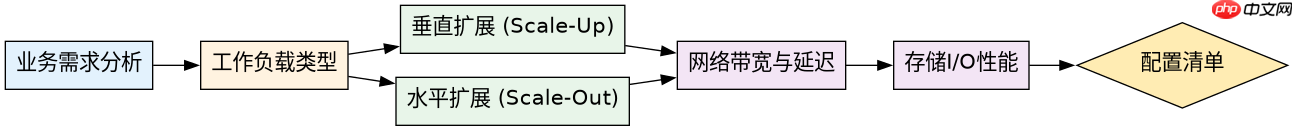
评估企业级服务器配置并非简单的硬件堆砌,而是基于业务负载特征进行资源匹配的过程。直接做法是明确当前及未来三年的业务增长预期,确定计算、存储和网络的核心瓶颈点,随后根据瓶颈选择对应的硬件指标。
核心组件评估逻辑
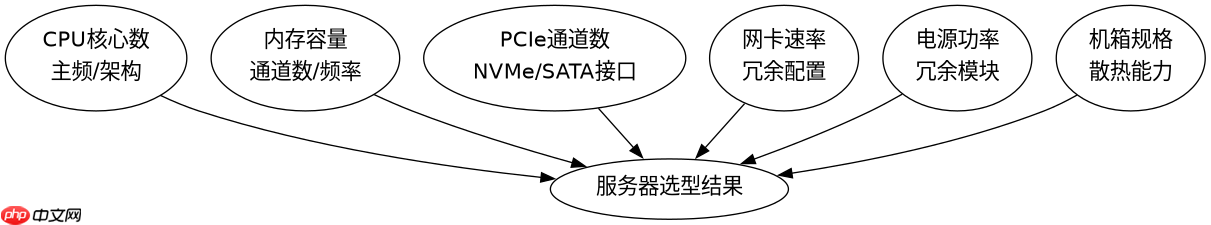
服务器选型的核心在于理解各组件对业务的影响权重。对于数据库或大型单体应用,CPU的主频和单核性能往往比核心数更重要;而对于虚拟化平台或微服务集群,核心数和内存容量则是关键指标。PCIe通道的数量直接决定了能接入多少高速存储设备(如NVMe SSD),这影响了数据吞吐的上限。网络方面,万兆(10GbE)及以上带宽已成为现代分布式系统的标配,用于处理节点间的数据同步。电源和机箱的冗余设计则保障了物理层面的可用性,避免单点故障导致的服务中断。
在实际操作中,建议采用基准测试工具(如sysbench、iperf3)对候选硬件进行压力测试。例如,通过sysbench测试CPU的多线程处理能力,通过dd命令测试磁盘的顺序读写速度。这些测试数据能帮助判断硬件是否满足预期的吞吐量要求。同时,需关注厂商的保修政策和技术支持响应时间,这在企业环境中与硬件性能同等重要。
Kubernetes集群节点配置示例
以下Python脚本模拟了一个简单的服务器配置推荐器,它根据输入的业务类型(web、database、compute)和预估并发量,输出推荐的CPU核心数、内存大小和网络带宽。该程序展示了如何将抽象的业务需求转化为具体的硬件参数。
# server_config_recommender.py
import sys

def recommend_config(workload_type, concurrent_users):
    """
    根据工作负载类型和并发用户数推荐服务器配置
    :param workload_type: str, 'web', 'database', or 'compute'
    :param concurrent_users: int, 预估并发连接数
    :return: dict, 包含推荐的CPU, RAM, Network配置
    """
    config = {}

    if workload_type == 'web':
        # Web服务通常受限于IO和上下文切换,中等核心数即可
        cpu_cores = max(8, concurrent_users // 100)
        ram_gb = max(16, concurrent_users * 0.05)
        network_gbps = 10
    elif workload_type == 'database':
        # 数据库依赖内存缓存和高IOPS,高内存和大核心数
        cpu_cores = max(16, concurrent_users // 50)
        ram_gb = max(64, concurrent_users * 0.2)
        network_gbps = 25
    elif workload_type == 'compute':
        # 计算密集型任务需要大量核心
        cpu_cores = max(32, concurrent_users * 2)
        ram_gb = max(32, concurrent_users * 0.1)
        network_gbps = 10
    else:
        raise ValueError("Unknown workload type")

    config['cpu_cores'] = cpu_cores
    config['ram_gb'] = ram_gb
    config['network_gbps'] = network_gbps
    return config

if __name__ == '__main__':
    # 示例:一个拥有500并发用户的Web应用
    workload = 'web'
    users = 500
    result = recommend_config(workload, users)
    print(f"Recommended Config for {workload} ({users} users):")
    print(f"CPU Cores: {result['cpu_cores']}")
    print(f"RAM (GB): {result['ram_gb']}")
    print(f"Network (Gbps): {result['network_gbps']}")
运行方法:保存上述代码为server_config_recommender.py,然后在终端执行python server_config_recommender.py。预期结果是输出针对500并发Web用户的推荐配置:CPU核心数至少8核,内存至少16GB,网络带宽10Gbps。这个脚本提供了一个基础的量化参考,实际部署时还需结合具体框架(如Nginx、MySQL版本)的特性进行调整。
多节点集群的网络拓扑优化
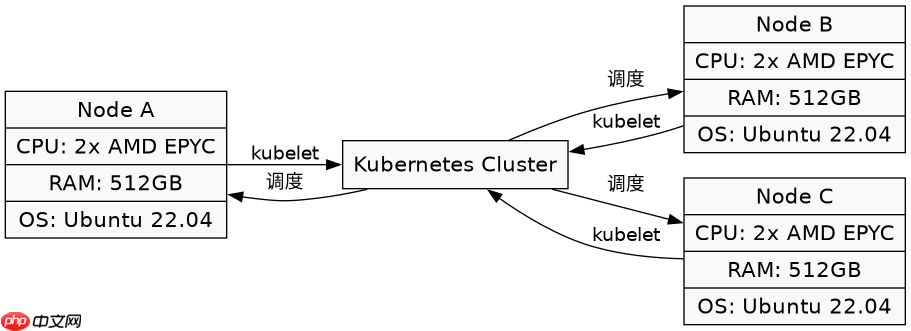
当服务器从单机扩展到集群时,网络拓扑成为新的评估重点。以Kubernetes集群为例,三个节点(Node A, B, C)组成一个小型集群。在这种架构下,节点间的通信延迟直接影响Pod调度和数据一致性。如果业务涉及高频的状态同步(如分布式锁或实时数据流),则需要确保节点间处于同一低延迟局域网内,并启用RDMA或高性能交换机。此外,管理流量(API Server通信)和数据流量(Pod间通信)建议在物理或逻辑上隔离,以避免相互干扰。对于这种多节点场景,评估的重点不再是单个节点的峰值性能,而是集群整体的协同效率和容错能力。
















