








服务器存储空间规划的核心在于平衡业务增长、数据价值与成本限制。直接的做法是建立一套基于时间维度的容量预测模型,结合当前的存储使用率和历史增长趋势,推导出未来的资源需求。
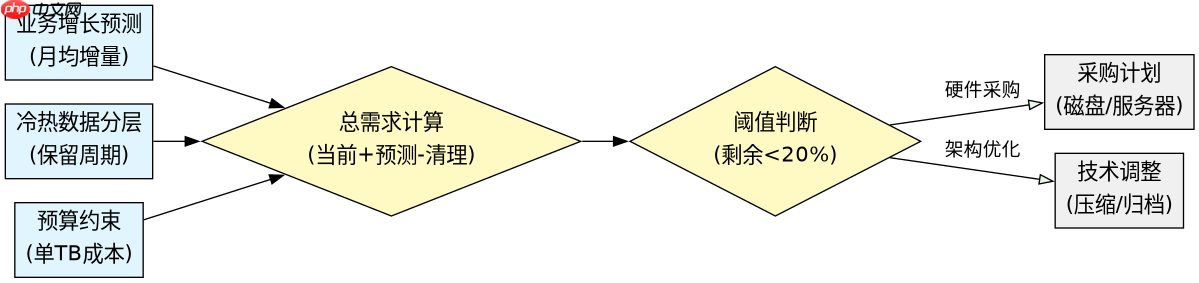
核心影响因素与建模逻辑
容量规划不是简单的线性外推,需要拆解为三个关键变量:业务增长带来的数据增量、数据留存策略决定的生命周期,以及存储成本设定的预算边界。业务增长通常表现为用户数或交易量的上升,直接驱动写入数据的增加。数据留存策略则决定了数据在系统中停留的时间,例如日志可能只保留30天,而财务记录需保留7年。成本上限限制了可采购的硬件规模,迫使团队在性能与价格之间做权衡。
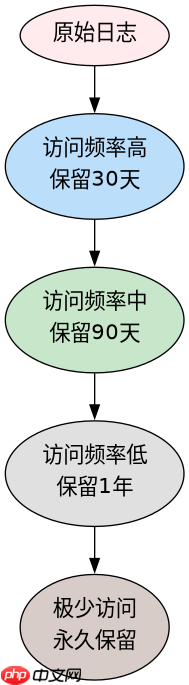
为了优化成本,现代架构常采用分层存储策略。热数据存储在高性能介质如SSD上,满足低延迟访问;温数据迁移至HDD,降低单位容量成本;冷数据则归档至对象存储或磁带库,实现长期低成本保存。这种分层不仅降低了总体拥有成本(TCO),还提高了存储资源的利用率。在建模时,需分别估算各层的数据量变化,再汇总得到总需求。
自动化监控与扩容执行
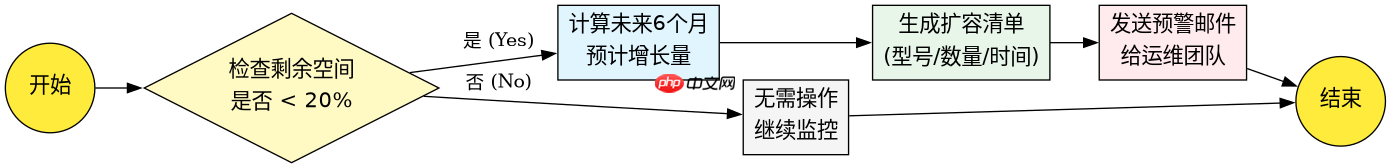
当手动计算难以应对动态变化的业务场景时,可以通过脚本实现自动化的容量监控与预警。以下Python代码演示了一个简化的容量检查流程,它模拟了从获取当前使用率到触发预警的逻辑。
# 假设这是一个模拟的存储监控系统
import time

class StorageMonitor:
    def __init__(self, total_capacity_gb, used_capacity_gb):
        self.total = total_capacity_gb
        self.used = used_capacity_gb
        self.warning_threshold = 0.8  # 80% 使用率触发预警

    def get_usage_rate(self):
        return self.used / self.total

    def check_and_alert(self):
        rate = self.get_usage_rate()
        if rate > self.warning_threshold:
            remaining = self.total - self.used
            print(f"[ALERT] 存储空间不足!剩余 {remaining:.2f} GB")
            print("[ACTION] 已生成扩容工单,请联系运维团队")
            return True
        else:
            print(f"[OK] 当前使用率 {rate*100:.1f}%,状态正常")
            return False

# 模拟运行:初始使用率为 75%
monitor = StorageMonitor(total_capacity_gb=1000, used_capacity_gb=750)
monitor.check_and_alert()

# 模拟业务增长后,使用率上升至 85%
monitor.used = 850
monitor.check_and_alert()
该程序定义了StorageMonitor类,封装了总容量、已用容量和阈值。check_and_alert方法实时计算使用率,若超过80%,则输出告警信息并模拟生成工单。运行此脚本,首先会显示“状态正常”,随后在模拟数据增长后,触发“存储空间不足”的告警。这体现了自动化监控在早期发现风险中的作用,确保团队有足够时间进行硬件采购或架构调整。
极端场景下的应急处理
当遭遇突发流量高峰或数据泄露导致异常写入时,常规规划可能失效。此时需启用应急机制,如临时扩展云存储实例、启用数据压缩算法减少占用,或暂时关闭非核心业务的日志记录。这些措施虽不能替代长期规划,但能有效防止服务中断。关键在于提前制定应急预案,并在演练中验证其有效性,确保在真实危机中能迅速响应。















