


社区开发者近期借助开源项目,成功解除了nvidia rtx 20、30、40系列显卡中部分被屏蔽的ai计算性能。该方案不涉及任何硬件改动,也无需刷写新版本vbios,而是通过在软件层移除针对特定tensor core操作的限制,从而激活显卡本就具备但出厂时被禁用的计算吞吐能力。
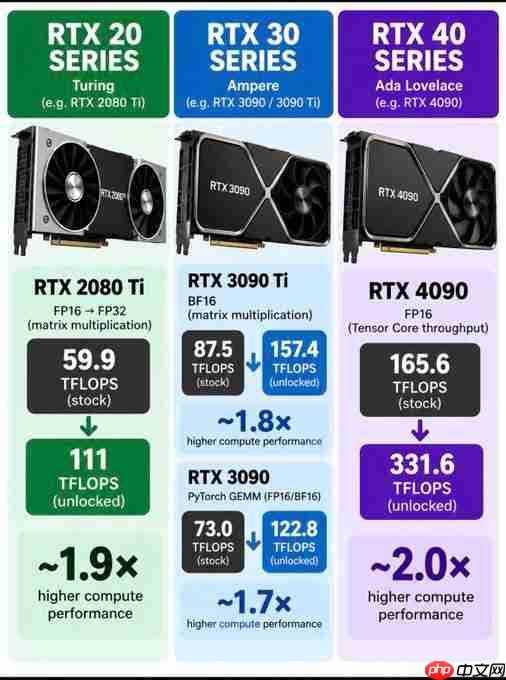
实际测试结果表明:RTX 4090在FP16 Tensor Core吞吐量测试中,由165.6 TFLOPS跃升至331.6 TFLOPS,几乎实现翻倍;RTX 3090 Ti的BF16性能从87.5 TFLOPS提升至157.4 TFLOPS;RTX 2080 Ti在FP16转FP32相关测试中,由59.9 TFLOPS增至111 TFLOPS;RTX 3090在PyTorch GEMM基准测试中,亦从73.0 TFLOPS提升至122.8 TFLOPS。
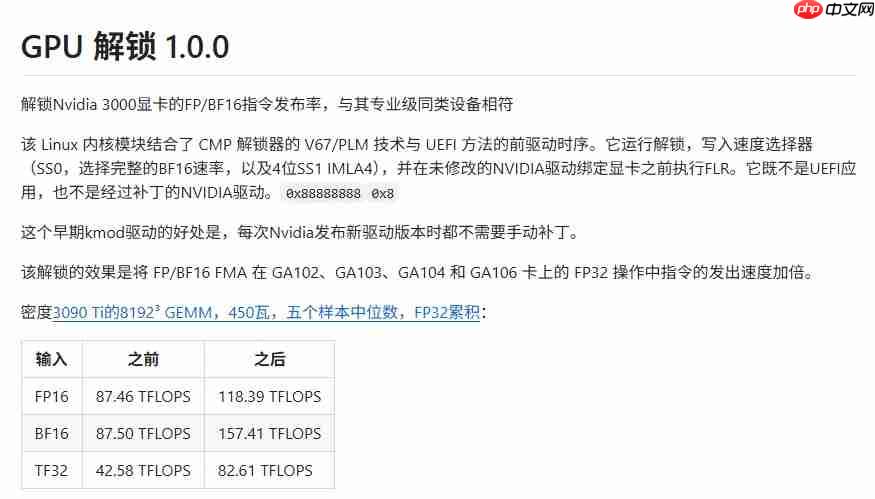
上述性能增益主要体现在AI训练与推理、大规模矩阵乘法及高负载科学计算等场景中。在本地运行大语言模型、AI图像生成以及数值模拟等任务时,已有用户在ComfyUI和vLLM等框架中实测到吞吐量明显改善。不过,由于大模型解码阶段常受限于显存带宽,token生成速率未必随计算能力同步增长。
至于游戏表现,目前尚无可靠证据显示此类解锁可直接提升帧率或增强DLSS效果。NVIDIA对消费级GPU施加的限制集中于特定张量指令路径,而这些路径与主流游戏渲染管线的执行逻辑并不高度重叠。















