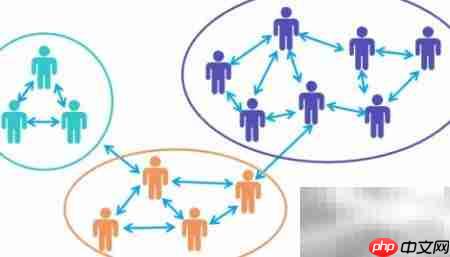
聚类是依据特定准则(如距离或相似性度量)将数据对象集合划分为若干个子集(即簇)的过程,其核心目标是确保同一簇内样本高度相似,而不同簇之间差异显著。换言之,聚类追求“簇内紧凑、簇间分离”,从而揭示数据内在的自然分组结构与分布规律。
1、 聚类分析的主要流程环节
2、 数据预处理:涵盖变量类型识别、特征筛选、标准化/归一化处理,以及异常值检测与清理。
3、 构建合适的相似性或距离度量函数(如欧氏距离、余弦相似度、Jaccard系数等),以客观刻画数据点间的关联强度。
4、 执行分组操作:依据所选算法(如K-Means、DBSCAN或层次聚类)将样本动态聚合为多个簇。
5、 对最终聚类结果开展质量评估,常用指标包括轮廓系数、Calinski-Harabasz指数、Davies-Bouldin指数等,用于衡量簇内凝聚性与簇间分离度。
6、 聚类不依赖类别标签,分类则必须基于已标注样本。
7、 聚类属于无监督学习范式,其本质是让算法从原始数据中自主发现潜在模式与结构。整个过程无需人工提供类别定义或训练标签,仅依靠数据自身的分布特性与特征关系完成自动分群,强调对数据本征结构的探索而非预测任务。
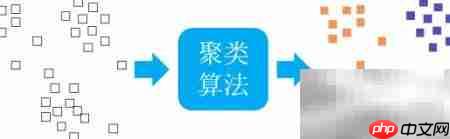
8、 分类致力于解决“该样本属于哪一类”的判定问题,要求预先明确类别体系并提供带标签的训练集。模型通过拟合这些标注样本来提取判别规则,进而对新样本进行归属推断,因此属于典型的监督学习任务。
9、 聚类技术已在多行业场景中实现深度落地与价值转化。
10、 帮助企业识别差异化客户细分市场,并结合购买频次、客单价、品类偏好等维度刻画各群体行为画像。
11、 面向区域经济数据,对城镇居民人均可支配收入、恩格尔系数、教育支出等指标进行聚类,辅助制定差异化民生政策。
12、 挖掘社交平台用户互动网络中的社区结构,识别兴趣共同体、意见领袖集群及信息传播路径。
13、 在生物信息学中支撑物种系统发育分析、蛋白质功能聚类及基因表达谱分型,助力理解进化关系与调控机制。
14、 针对电商平台用户浏览、加购、收藏、下单等全链路行为日志开展聚类,提炼高价值用户群共性特征,驱动个性化推荐、精准营销与会员生命周期管理。
15、 筛选出车险历史赔付率偏高、出险频率异常的投保人群体,为风险定价、核保策略优化与反欺诈模型构建提供数据支撑。