


excel里的标准差函数,作用是算出一组数据和平均值之间的离散程度。平时做表格最常用的是 stdev.s,语法是 =stdev.s(数字区域);如果你手里的这组数据已经覆盖了全部统计对象,就用 stdev.p。
先搞懂标准差的实际含义
标准差越小,整组数据越集中;数值越大,数据之间的差距就越明显。平时看成绩、销量、库存波动的稳定性,都能用它来评估。操作前先确认要计算的都是同类型数据,别把姓名、分类文字、空白备注也一起选进去。
输入 STDEV.S 函数
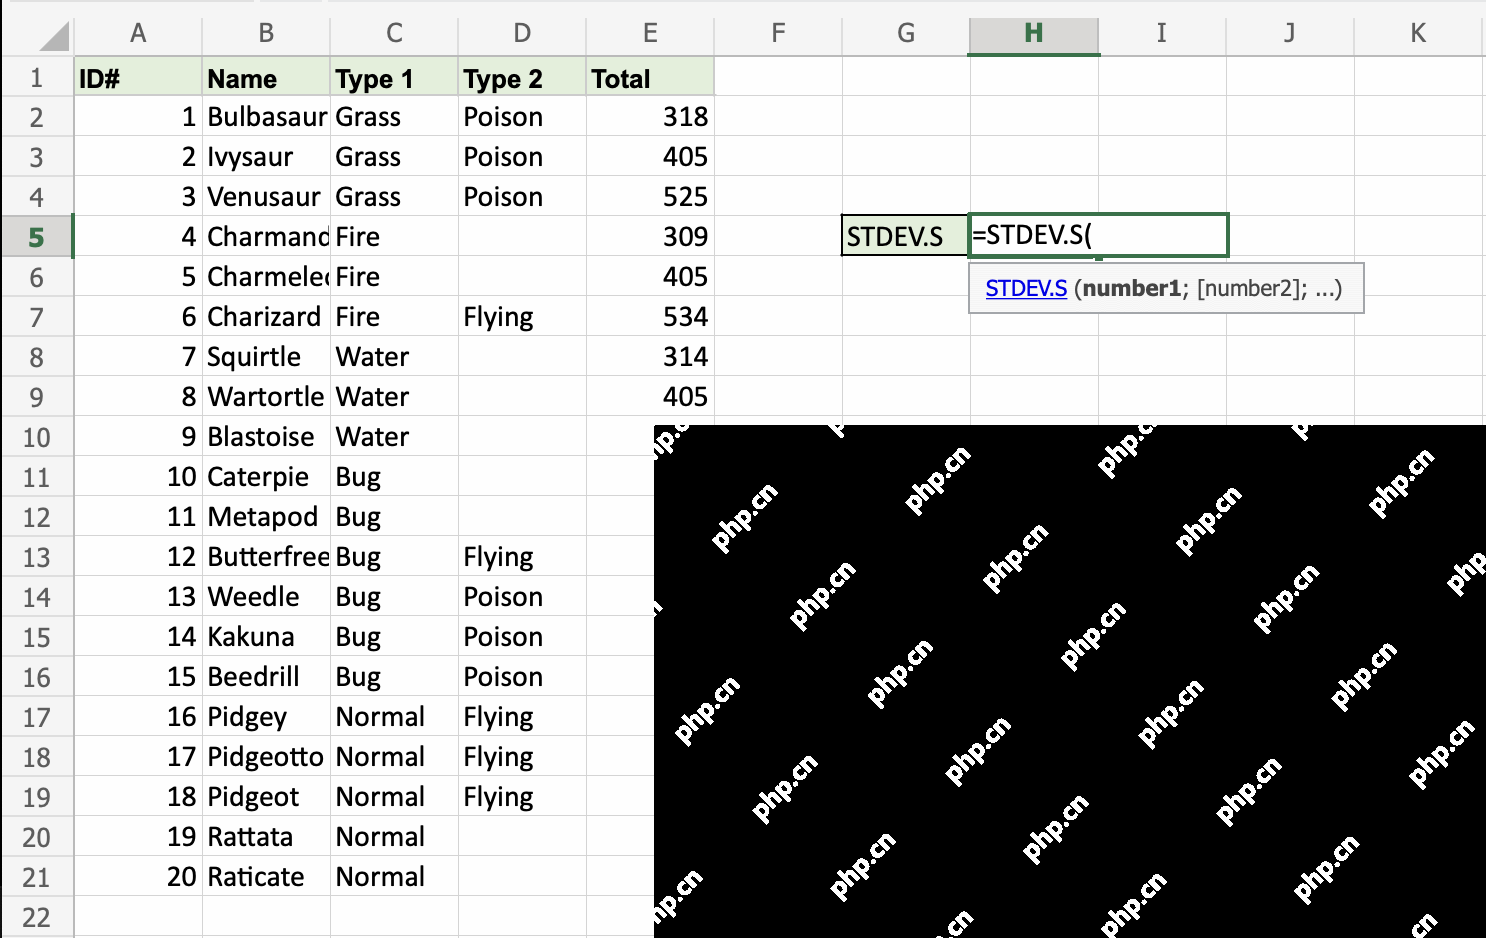
找个空白单元格,直接输入 =STDEV.S(。Excel会自动弹出函数提示,参数里的 number1 就是第一个要计算的数字区域,后面的 number2 还可以追加其他区域;如果只有一整列连续数据,填一个区域就够了。
选择要参与计算的数字区域
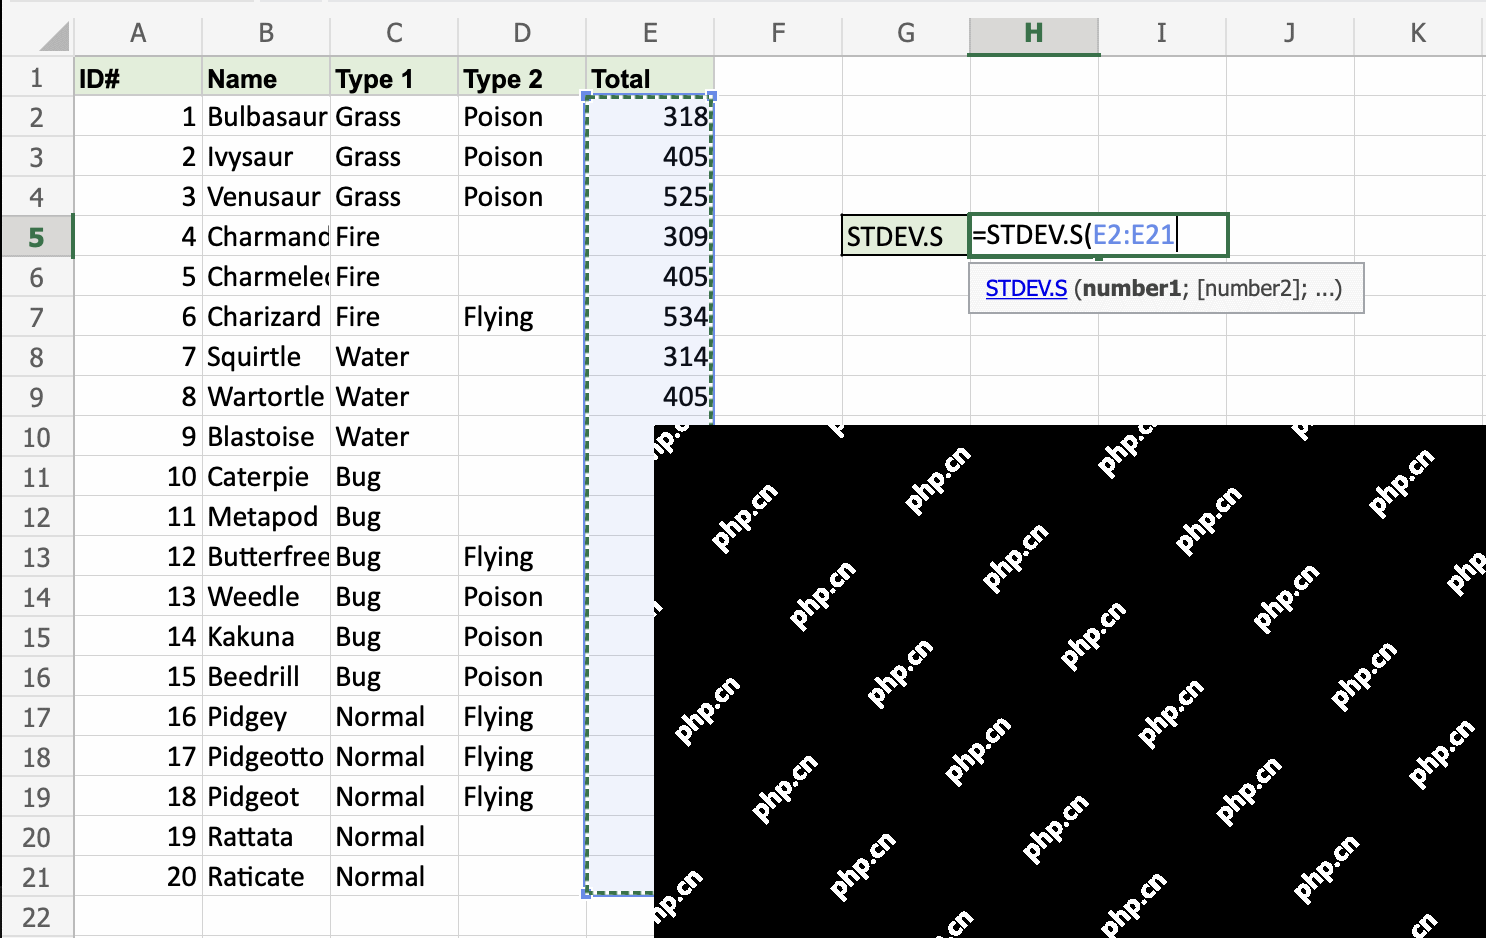
接着用鼠标拖选要算标准差的数字列,比如销售额、考试分数、样本检测值所在的整片区域。选区内最好只有数字,文字表头不用放到函数参数里;要是碰到明显偏离的异常值,先确认是不是有效数据,再决定要不要保留进计算范围。

将 PySpark .show() 输出转为 Tab 分隔文本,方便粘贴 Excel。触发词:pyspark、数据转excel、表格整理、venus数据、show输出、复制到excel、数据格式化。
按回车得到样本标准差结果
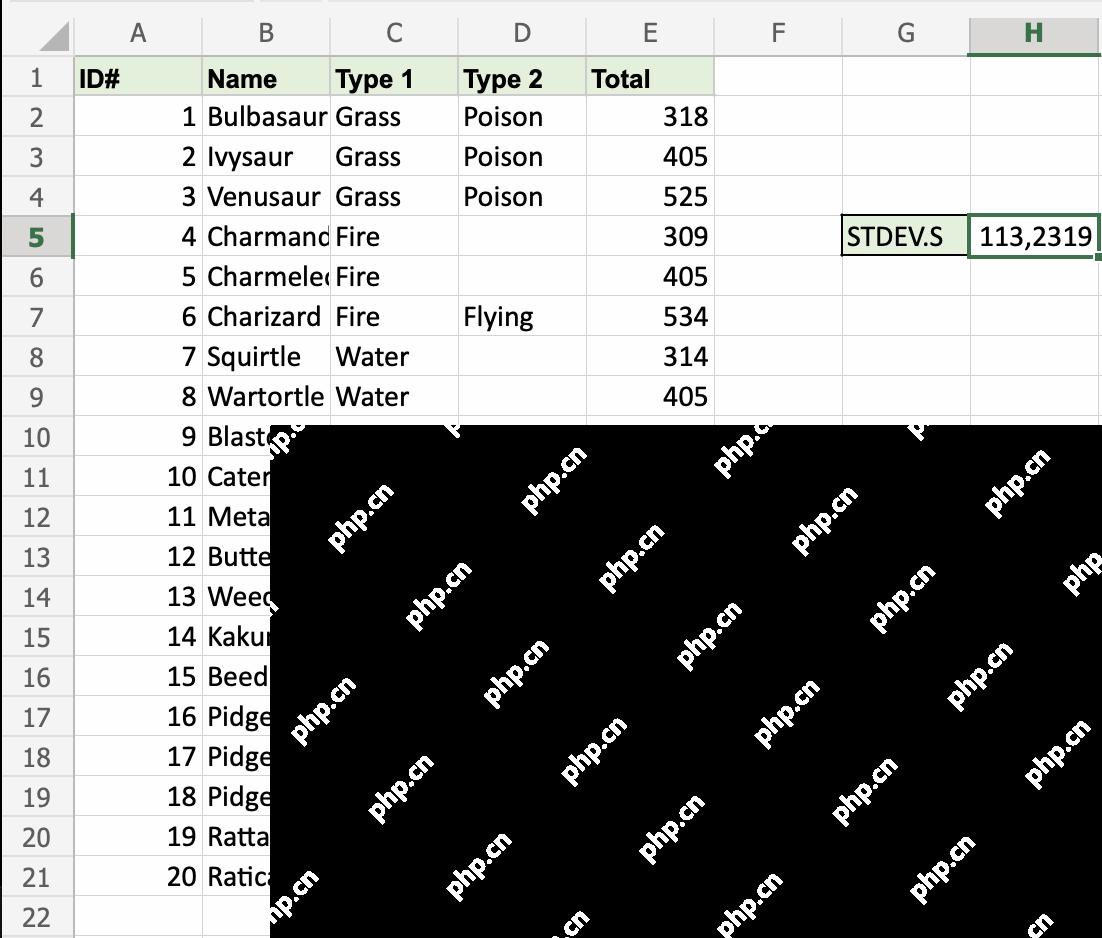
选完区域补个右括号,按回车就行。单元格里跳出来的数就是样本标准差。这个值既不是平均数,也不是最大值减最小值的差,代表的是整组数据围绕平均值上下波动的幅度。
STDEV.S 和 STDEV.P 这样选就不会错
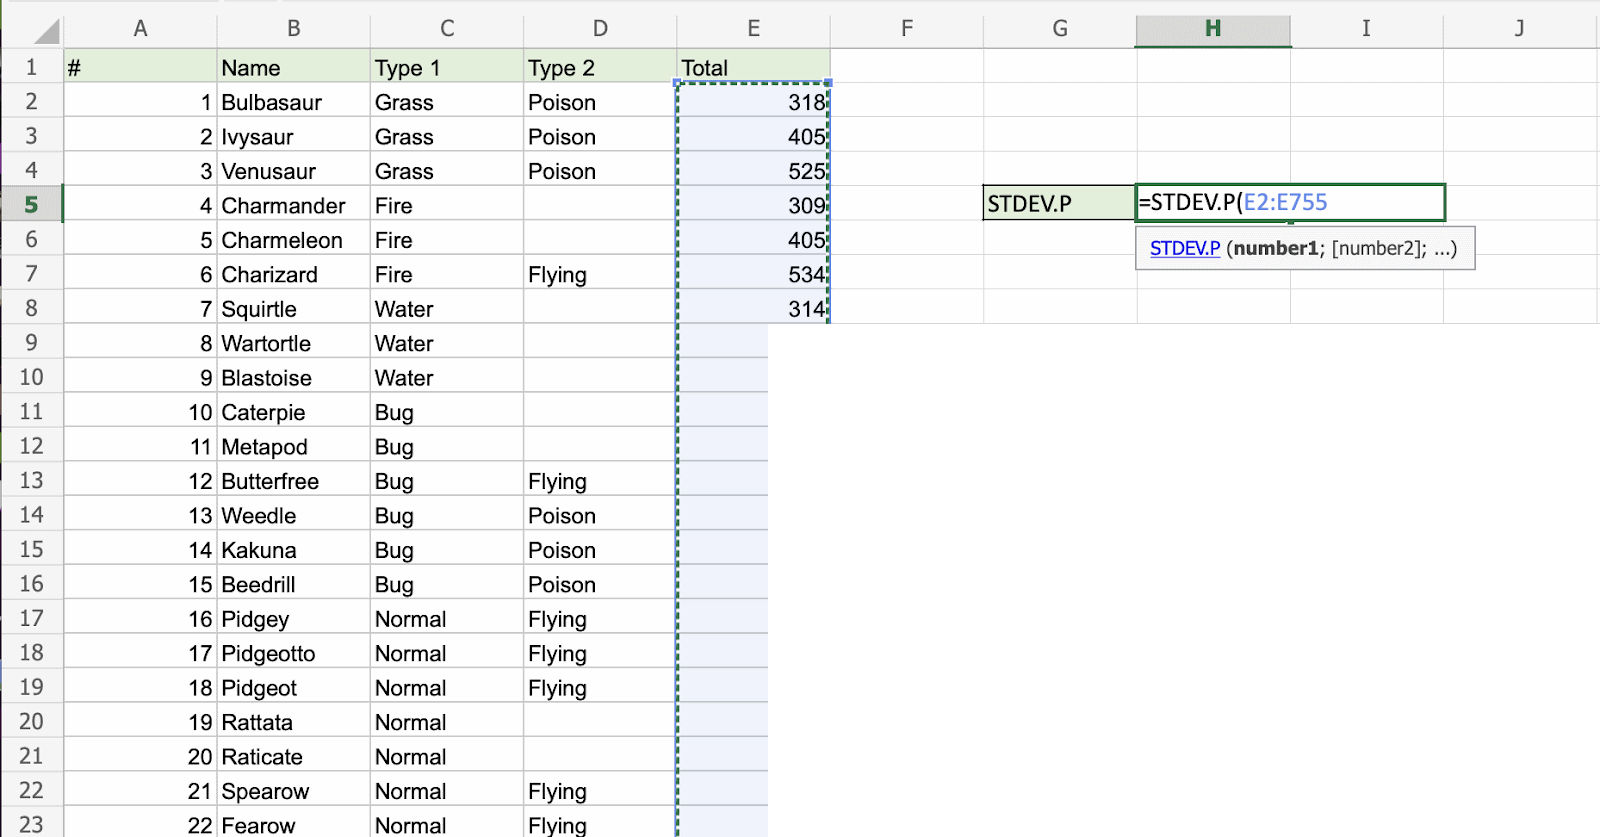
操作时先选择函数口径:如果你的数据只是抽样出来的一部分,比如从大量订单里抽出一小部分、从一批学生里取部分成绩,就输入 STDEV.S。要是你手里的数据已经是全部统计范围,比如一个班所有学生的成绩、当天全部门店的所有销量,就用 STDEV.P。两个函数写法差不了多少,核心区别就是你算的是抽样样本,还是全部总体。
算完最好在结果旁边备注好“样本标准差”或“总体标准差”,后面回头复查的时候不会搞混口径。后续只要你修改了数据区域里的内容,标准差结果会自动同步更新;如果要把最终结果定死,把结果单元格复制一下,单独粘贴为值就可以。










