


商汤科技正式推出并全面开源“日日新sensenova-vision”——一款集理解与生成于一体的统一视觉大模型,标志着商汤“日日新”大模型体系在视觉能力上的关键跃升。商汤指出,当前业界所谓“统一视觉”方案,往往仅是将目标检测、图像分割、深度预测等若干专用模型进行简单集成,底层逻辑仍属割裂;而sensenova-vision的根本性突破在于:将视觉能力深度内化为通用大模型的原生能力,真正实现视觉与语言、推理等模态的一体化融合。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
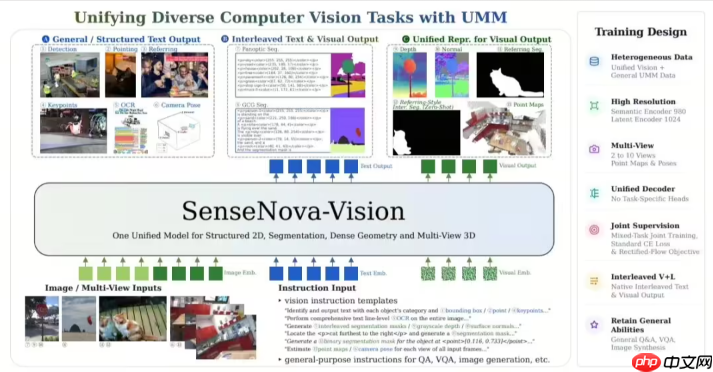
单模型覆盖四大视觉范式
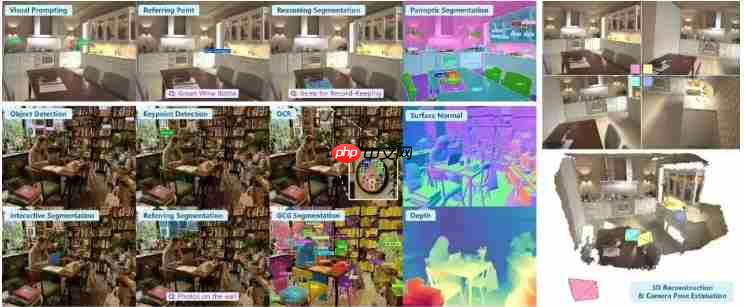
多项权威评测结果显示,SenseNova-Vision凭借单一模型架构,在目标检测、稠密几何估计、语义/实例分割、多视角三维重建四大核心视觉任务中全面领先,性能比肩甚至超越各领域顶尖专用模型。在结构化视觉理解方面,其在目标检测、指代定位、OCR识别、关键点回归等任务上显著优于同类通用视觉模型,尤其在小目标密集场景识别与长尾类别泛化能力上优势突出。在稠密几何预测维度,深度图与表面法向量估计精度已达专业几何模型水平,且在室内外复杂光照与尺度变化下保持高度鲁棒性。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
分割能力支持通用分割、推理驱动分割及交互式分割等多种范式;依托强大的跨模态对齐与语义理解能力,在需上下文推理的分割任务(如对话引导分割、指令式分割)中表现卓越。同时,该模型仅凭单一架构即可高质量完成多视角点云重建与相机位姿联合估计,在通用视觉建模路线中处于第一梯队。
全面超越Vision Banana,语料同步开放
横向对比显示:相较以语义理解见长的模型,SenseNova-Vision在检测精度、分割细粒度、深度估计误差等严苛指标上实现系统性领先;相较生成导向代表模型Vision Banana,则展现出显著的代际跨越——在主流基准测试的绝大多数评测项中均达成全面超越。Vision Banana仅能有效支撑四大视觉任务中的两类,而SenseNova-Vision则实现了结构化理解、稠密几何建模、全景分割、多视角三维感知等全栈能力覆盖。
在开源策略上,商汤不仅开源模型权重与推理代码,还同步发布规模达5000万条的高质量视觉指令数据集——SenseNova-Vision Corpus-50M。后续,SenseNova-Vision的核心视觉技术将深度整合进“日日新U系列”大模型体系,持续强化多模态智能底座能力。














