


人工智能视觉领域近日取得关键突破。商汤科技正式对外开源其多任务视觉基础模型 sensenova-vision-7b-mot,致力于为视觉感知理解与 gui 智能体构建提供高性能、高适应性的底层支撑。
该开源模型展现出卓越的多任务协同能力。它将目标检测、OCR(光学字符识别)、深度估计、法线图预测、图像语义/实例分割、多视角几何推理等主流视觉任务,深度融合于单一 70 亿参数规模的统一架构之中。这一设计显著增强了模型的任务泛化性,并支持借助自然语言指令动态定义和执行此前未显式训练过的新型视觉子任务,从而突破传统任务范式的限制,实现视觉能力的按需组合与灵活延展。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
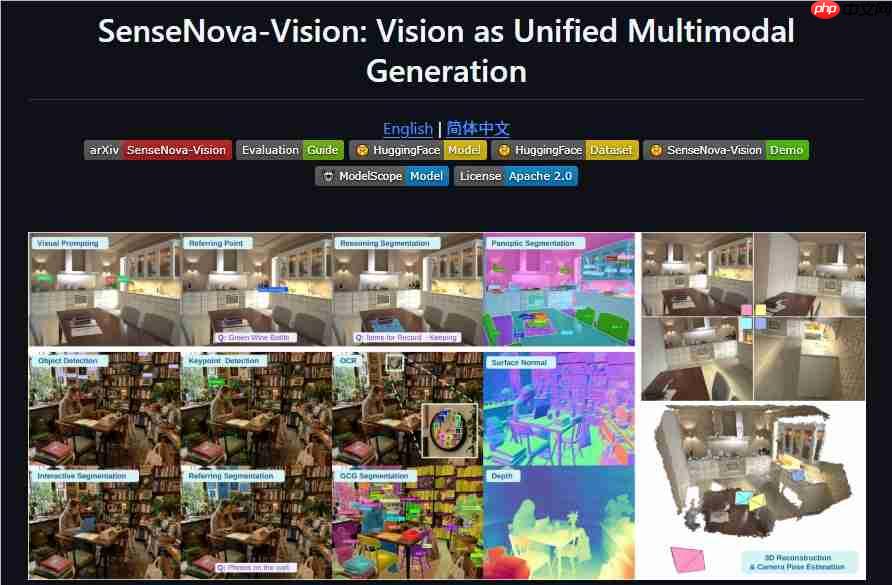
为全面赋能学术界与工业界,商汤采用全量开源模式:开放全部模型权重、发布涵盖 5000 万样本的 SenseNova-Vision 视觉语料子集,并配套提供完整可复现训练流程的工具链,协助开发者高效整合其余公开视觉数据资源。
行业技术专家普遍认为,SenseNova-Vision-7B-MoT 的推出并非仅是参数量级上的优化升级,更标志着视觉建模范式向“统一任务接口+语言驱动扩展”方向的重要演进。目前,模型技术文档、源代码仓库及交互式在线 Demo 已同步上线 Hugging Face 与 GitHub 平台,研究人员与工程开发者均可即刻访问并集成使用,推动视觉智能在真实场景中的快速验证与规模化落地。
项目地址:https://www.php.cn/link/4da297e69fc8c79e5f4a6804bb5b03c2















