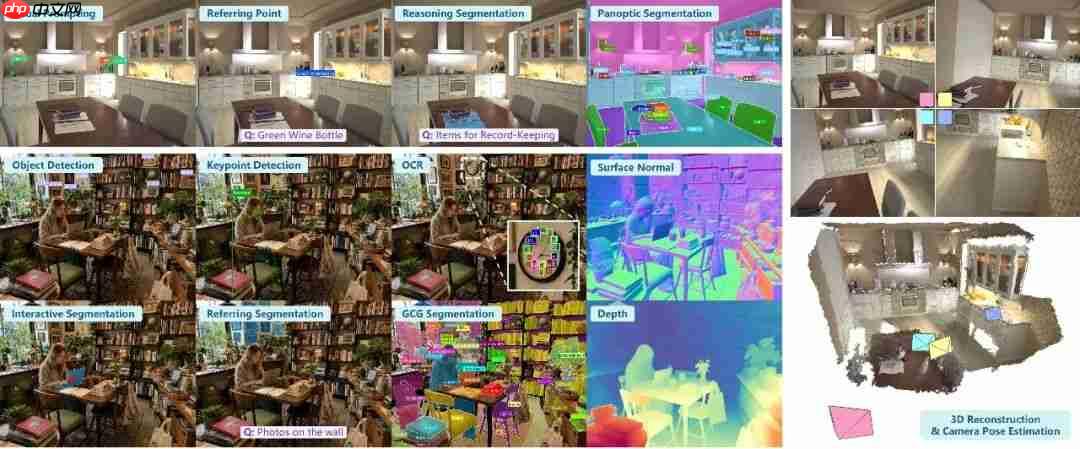
7月13日,商汤科技正式对外发布并全面开源其统一视觉大模型——sensenova-vision。该模型创新性地将目标检测、图像分割、深度估计等传统视觉任务,统一建模为多模态生成任务,完成了从“单一功能工具”向“具身世界理解模型”的范式跃迁。
在多个国际主流基准测试中,SenseNova-Vision展现出卓越性能,整体表现与各细分领域的顶尖专用模型相当,部分指标甚至实现反超。模型具备显著的跨任务知识迁移与协同能力,在未知场景与新兴任务中仍保持稳健的泛化表现。
为加速全球视觉AI技术普惠与创新,商汤同步开源了规模达5000万条的高质量视觉指令数据集——SenseNova-Vision Corpus-50M。这一举措有望显著降低多模态视觉模型的研发与应用成本,加速产业迈向通用化、基座化的视觉智能新阶段。

This skill transforms novel chapters into professional film storyboard scripts. 这个skill是将小说章节 →(变成) 专业电影分镜剧本。 Powered by **清云 EchoFlow API** (https://api.echoflow.cn/) — 一站式国内外580+大模型,一键开发票,企业级稳定,价格是官方的1.5折。
下载
将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜