





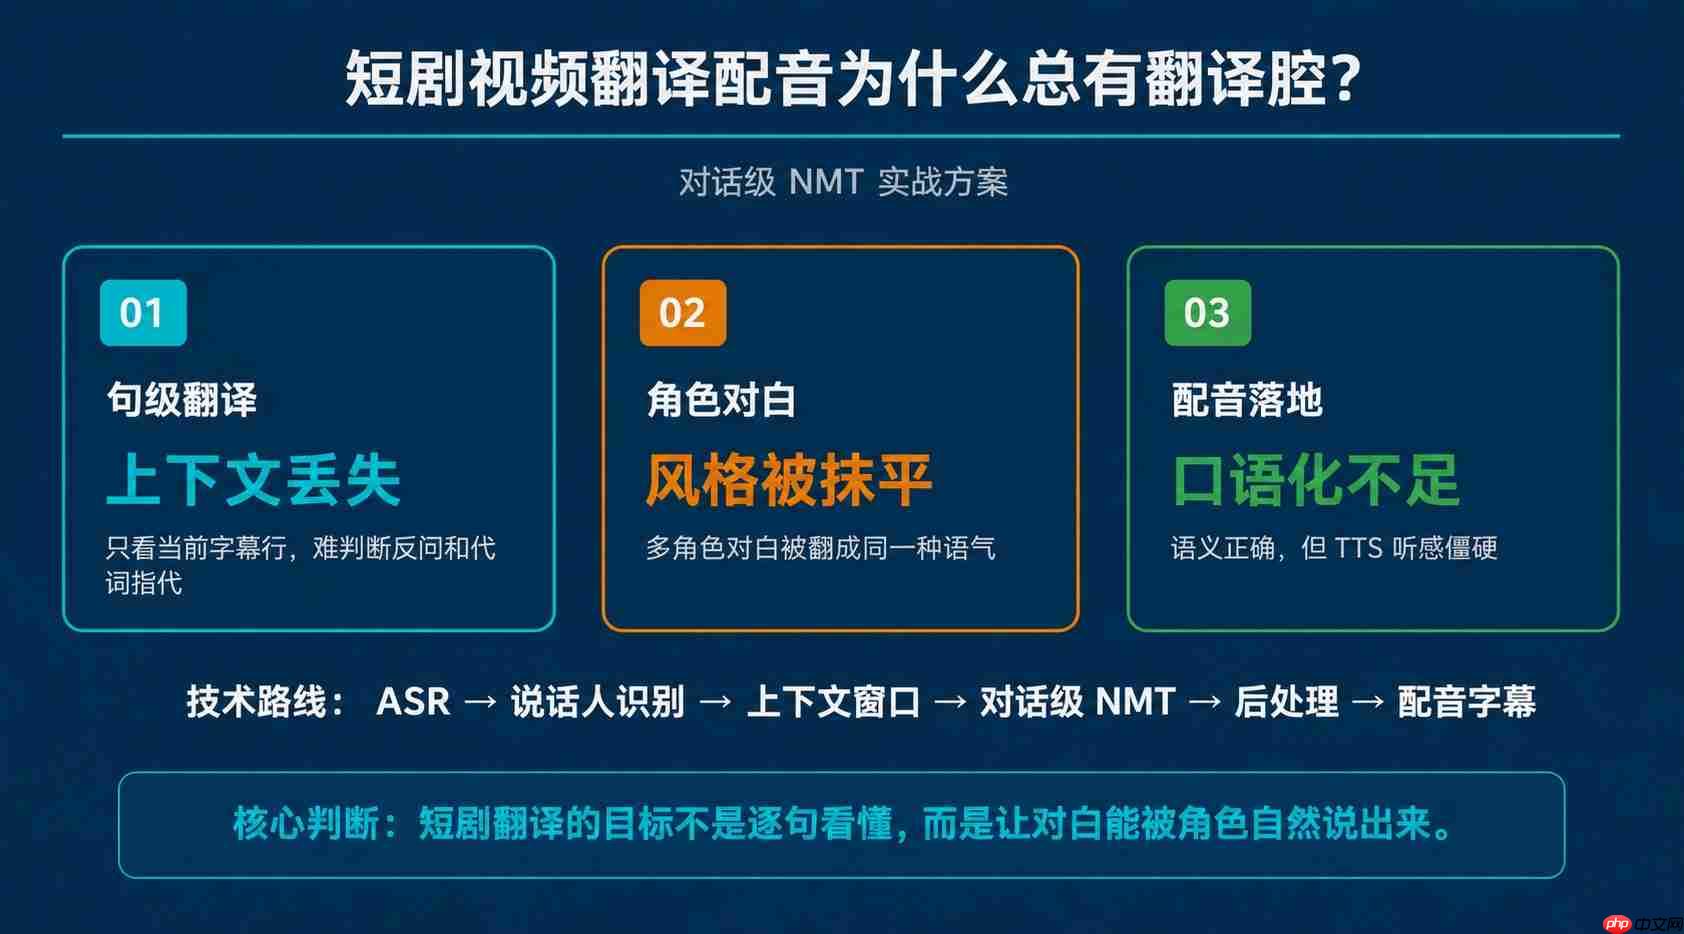
短剧配音里的“翻译腔”,很多时候不是模型完全不会翻译,而是翻译单元选错了。通用 nmt 往往按句子处理文本,看到的是一行字幕、一句台词,却看不到前后情绪、人物关系、说话人身份和下一句接话方式。结果就是:词义对了,语气不对;句子通顺,角色不像人说话。
对于短剧出海翻译,尤其是要接入 AI 配音、字幕和时间轴的工作流,句级翻译只能解决“看懂”,对话级翻译才更接近“能演”。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
句级 NMT 为什么容易把短剧对白翻成书面语?
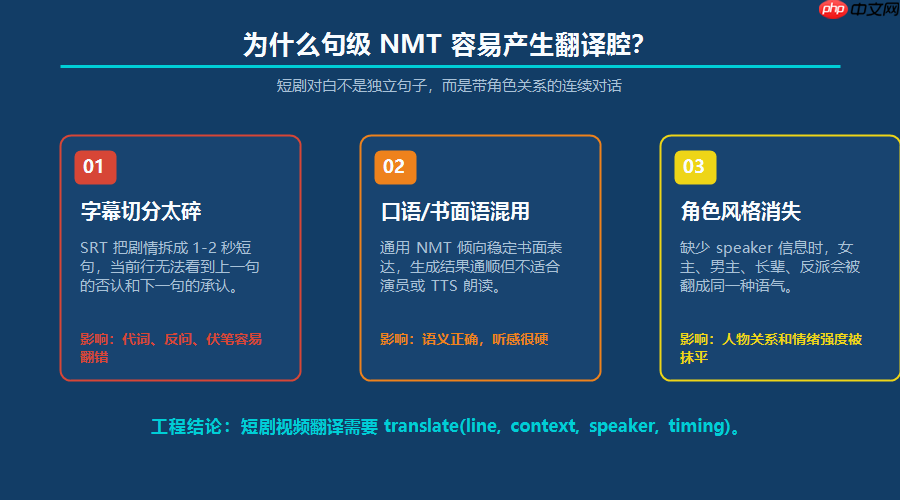
短剧对白和新闻、说明书、论文最大的区别是:它不是独立句子的集合,而是一串带角色关系的对话。
比如中文短剧里一句“你还装?”如果单独丢给通用 NMT,模型可能会翻成:
语义没错,但放在配音里很硬。如果上下文是女主发现男主隐瞒身份,这句更像:
问题不在单词,而在语境。句级 NMT 通常会遇到三个工程问题:
上下文丢失:字幕切分会把完整对话拆成很多短句,模型无法知道上一句是谁说的、对方刚刚承认了什么、当前台词是质问还是讽刺。口语和书面语混在一起:通用翻译模型在大量正式文本上表现稳定,但短剧配音更需要口语、省略、停顿和情绪词。直译过来的句子容易“语法正确,但不像演员会说的话”。角色风格被抹平:霸总、反派、闺蜜、长辈、下属的说话方式不同。句级翻译只看当前句,很难保留角色的固定表达、称谓习惯和语气强弱。所以短剧视频翻译不能只看 BLEU 或逐句准确率。真正影响成片观感的是:台词能不能接得上、角色有没有同一套语言风格、配音演员读出来是否自然。
对话级 NMT 怎么改造视频翻译 pipeline?
对话级翻译不是简单把 20 句字幕一起塞进模型。工程上更稳的做法,是把上下文、说话人和后处理拆成三个模块。
1. 上下文窗口:让模型看到“这句台词前后发生了什么”
短剧字幕常见输入是 SRT 或转写段落,每条包含开始时间、结束时间和文本。对话级 NMT 会在翻译当前句时加入一个上下文窗口,例如:
前 2-4 句:帮助判断代词、称谓、情绪延续。当前句:作为主要翻译目标。后 1-2 句:帮助判断伏笔、转折和接话方式。窗口不能无限拉长。太短,语境不够;太长,模型容易被无关信息干扰,还会增加推理成本。实践里更常见的是按场景切分:同一镜头、同一对话回合、同一说话人连续台词优先放进一个窗口。
一个可复用的输入结构可以写成:
<code class="javascript">{ "scene_id": "ep03_scene_12", "target_line": { "speaker": "female_lead", "start": "00:03:12.400", "end": "00:03:14.100", "text": "你还装?" }, "context_before": [ {"speaker": "male_lead", "text": "我不知道你在说什么。"}, {"speaker": "female_lead", "text": "合同上的名字就是你。"} ], "context_after": [ {"speaker": "male_lead", "text": "好吧,我承认。"} ]}</code>这种结构的价值是让翻译模型知道:当前句不是普通疑问句,而是揭穿后的质问。
2. 说话人信息注入:别让所有角色说同一种话
对话级 NMT 的另一个关键点是 speaker tag。短剧配音最怕“所有人都像同一个旁白在说话”,所以说话人信息要尽早进入翻译链路。
常见做法有三种:
文本前缀注入:在每句前加上[speaker=female_lead][tone=angry] 这类标签,低成本、容易落地。角色画像注入:给主要角色维护一个 style profile,例如“语气强势、短句多、少用敬语”“年轻口语、反问多”。后处理一致性检查:翻译后检查同一角色的称谓、口头禅、语气强度是否漂移,必要时做统一修正。说话人信息不是为了让模型“编戏”,而是限制它不要把人物关系翻丢。比如日语里的敬语、英语里的称呼、中文里的“您/你”、韩语里的语尾,都和人物关系强相关。
3. 口语化 post-editing:让翻译结果适合配音而不是只适合阅读
视频翻译最终要进入 AI 配音或人工配音,文本不能只追求字面对齐,还要考虑可读性和节奏。
一个实用的 post-editing 策略通常包含:
长句拆短:避免配音一口气读不完。书面词替换:把 “therefore / however / I am unable to” 换成更自然的口语表达。情绪词补偿:在不改变剧情的前提下补足讽刺、惊讶、迟疑。时间轴约束:译文长度不能明显超出原句时长。角色一致性:同一角色的称谓、语气和表达习惯保持稳定。这一步很容易被低估。很多“翻译腔”并不是 NMT 第一版造成的,而是后续没有做配音导向的口语化清洗。
句级 vs 对话级:日语和英语例句对比
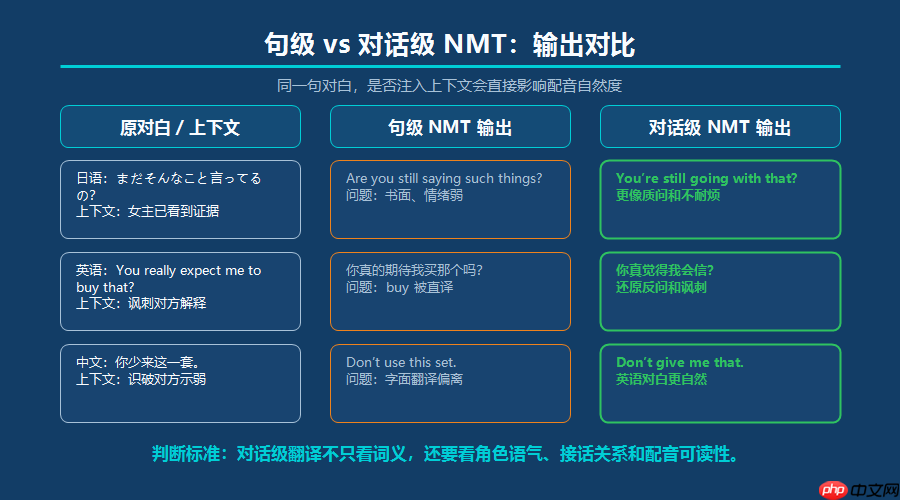
例句 1:日语短剧对白
原文:「まだそんなこと言ってるの?」
上下文:前一句是男主否认自己隐瞒身份,女主已经看到证据。
句级翻译:Are you still saying such things?
问题:语义基本对,但过于书面,情绪弱,像字幕翻译而不是配音台词。
对话级翻译:You’re still going with that?
适合配音的原因:保留了质问和不耐烦,英语口语更自然,演员读出来更像真实对话。
例句 2:英语短剧对白
原文:You really expect me to buy that?

上下文:角色发现对方解释前后矛盾,语气是讽刺,不是真正询问购买行为。
句级翻译:你真的期待我买那个吗?
问题:把 buy 直译成“买”,丢失了 “believe” 的语义。
对话级翻译:你真觉得我会信?
适合配音的原因:还原了反问和讽刺语气,中文短剧对白更自然。
例句 3:中文短剧对白
原文:你少来这一套。
上下文:女主识破男主示弱,上一句是男主说“我都是为你好”。
句级翻译:Don’t use this set.
问题:字面翻译完全偏离口语含义。
对话级翻译:Don’t give me that.
适合配音的原因:保留拒绝和反感语气,是英语对白中更自然的表达。
这些例子说明,短剧翻译的难点不是“词典里有没有对应词”,而是模型能不能理解这句台词在当前对话里的功能。
COMET 分数怎么看?不要只看平均分
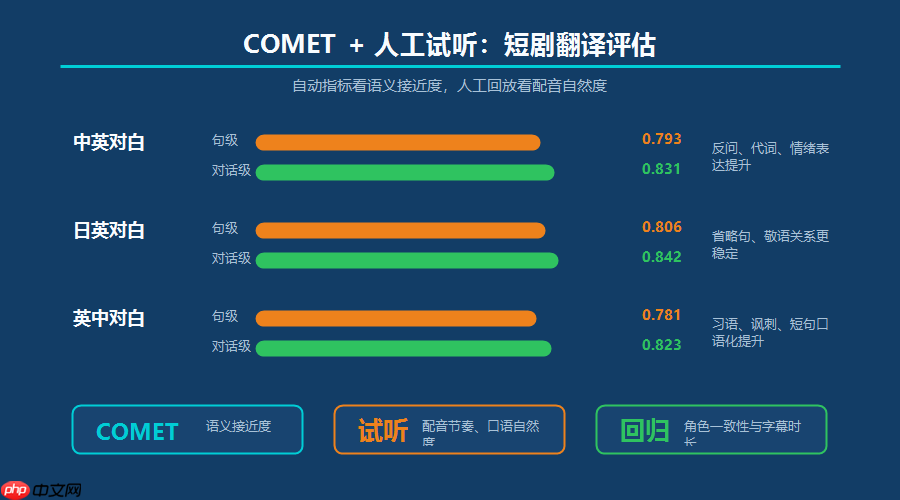
COMET 是常用的机器翻译评价指标之一,优点是比传统词面匹配指标更接近人类评价。但在短剧场景里,COMET 也要结合人工口语化检查一起看。
一个更贴近工程实践的评估方式是:同一批短剧片段分别跑句级翻译和对话级翻译,再用参考译文计算 COMET,同时人工标注“角色一致性”和“配音可读性”。
示例评估口径如下,数值可作为小样本回放的展示格式,不建议写成行业通用结论:
中英短剧对白 300 句:句级 NMT 的 COMET 约 0.793,对话级 NMT 约 0.831,主要提升来自反问句、代词指代和情绪表达。日英短剧对白 300 句:句级 NMT 的 COMET 约 0.806,对话级 NMT 约 0.842,主要提升来自省略句、敬语关系和接话语气。英中短剧对白 300 句:句级 NMT 的 COMET 约 0.781,对话级 NMT 约 0.823,主要提升来自习语、讽刺和短句口语化。这里的关键不是“对话级一定提升多少分”,而是评价维度变了:短剧配音要同时看语义准确、角色一致、口语自然、时长可控。COMET 可以做自动化回归指标,但不能完全替代人工试听。
一个可落地的 NMT pipeline 设计
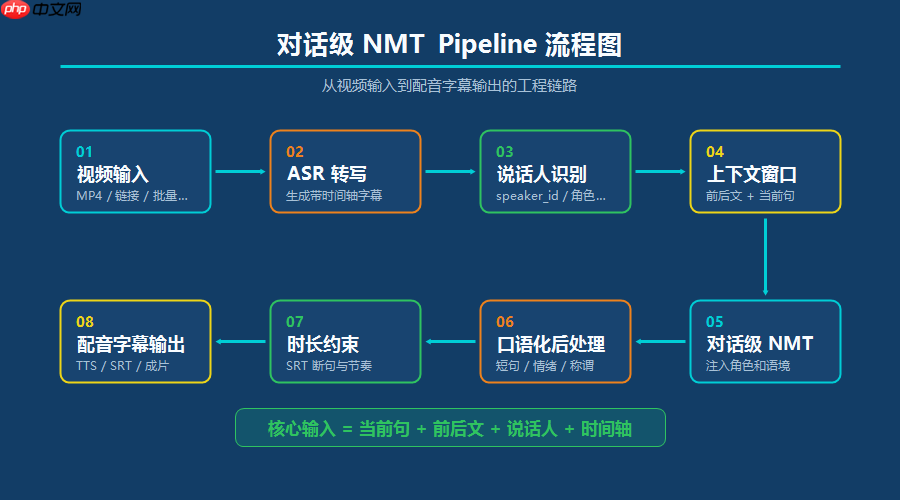
流程图文字稿:
视频输入:支持本地视频、网盘链接或平台链接,进入统一任务队列。ASR 转写:从音频中识别对白文本,生成带时间轴的初始字幕。说话人识别:按角色拆分台词,生成 speaker_id,避免多人对白混在一起。场景与上下文切分:按镜头、停顿、角色轮次和字幕时间轴划分对话窗口。对话级 NMT:输入当前句、前后文、说话人标签和目标语言,生成第一版译文。口语化 post-editing:修正书面表达、长句、称谓、情绪词和目标语言习惯。时长与字幕约束:检查译文长度、SRT 时间轴、断句位置和屏幕可读性。配音与字幕输出:进入 AI 配音、字幕压制、人工审核或多语种批量导出。如果用伪代码描述,核心不是“translate(line)”,而是“translate(line, context, speaker, timing)”:
<code class="javascript">def translate_dialogue_line(line, context_before, context_after, speaker_profile, timing): prompt = { "target_line": line.text, "speaker": speaker_profile, "context_before": context_before, "context_after": context_after, "timing_limit": timing.duration, "style": "spoken dialogue for dubbing" } draft = nmt_model.translate(prompt) polished = spoken_post_edit(draft, speaker_profile, timing) return polished</code>这也是短剧出海翻译和普通文档翻译最核心的差异:文档翻译主要追求段落准确,视频翻译还要追求角色、节奏和声音表现。
接入配音 pipeline 时,工程上要注意什么?
在实际的短剧出海翻译项目中,我们把对话级翻译方案接入了配音 pipeline:先由 ASR 和说话人识别生成可追踪的台词单元,再用上下文窗口做翻译,最后进入配音、字幕和成片导出。
如果团队使用 VividDub 这类一站式 AI 视频翻译方案,重点不是只看“能不能翻译”,而是看它能不能把 AI 视频翻译、AI 配音、多角色识别、字幕生成和字幕压制串成稳定链路。短剧项目通常不是单条视频,而是一批剧集、多角色、多语种、多平台版本,链路稳定比单次演示更重要。
接入时建议重点检查四个指标:
角色是否稳定:同一角色在不同集、不同场景里的称谓和语气不能频繁变化。配音是否读得顺:翻译文本要适合 TTS 或声音克隆,不要保留太多书面长句。字幕是否跟时间轴匹配:译文长度要能放进原视频节奏,否则后续配音和字幕都会返工。多语种是否能复用流程:英语、日语、韩语、西语等目标语言可以有不同 post-editing 策略,但底层 pipeline 不应每个语种重做一套。对短剧团队来说,VividDub 的价值在于把视频提交、转写、翻译、配音、字幕和导出放在同一条生产链路里,减少人工在多工具之间搬运文本、音频和字幕文件的时间。对于多角色剧情素材,尤其要关注说话人识别和声音一致性这两个环节。
结论:短剧翻译要从“逐句准确”走向“对话可演”
通用 NMT 适合解决大多数文本翻译问题,但短剧配音是更复杂的视频本地化任务。它要求译文不仅准确,还要像角色会说的话,能被配音读出来,并且能落到字幕时间轴里。
如果只是把 SRT 拆成一句一句翻译,再直接送去配音,出现“翻译腔”几乎是必然的。更合理的工程路线是:用对话级 NMT 保留上下文,用说话人信息保留角色,用口语化 post-editing 适配配音,再用 COMET 和人工试听共同做质量回归。
短剧出海翻译的质量差距,最后往往不在某一个模型,而在整条 pipeline 是否理解“对白”这件事。
















