





AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com
本文的主要作者来自香港大学的数据智能实验室 (data intelligence lab)。作者中,第一作者任旭滨和第二作者汤嘉斌都是香港大学数据科学院的一年级博士生,指导老师为 data intelligence lab@hku 的黄超教授。香港大学数据智能实验室致力于人工智能和数据挖掘的相关研究,涵盖大语言模型、图神经网络、信息检索、推荐系统、时空数据挖掘等领域。此前的工作包括了通用图大语言模型 graphgpt,higpt;智慧城市大语言模型 urbangpt;可解释大语言模型推荐算法 xrec 等。
在信息爆炸的当今时代,我们如何从浩如烟海的数据中探寻深层次的联系呢?
对此,香港大学、圣母大学等机构的专家学者在图学习与大型语言模型领域的最新综述中,为我们揭示了答案。
图,作为描绘现实世界中各种关系的基础数据结构,其重要性不言而喻。以往的研究已证明,图神经网络在图相关的任务中取得了令人瞩目的成果。然而,随着图数据应用场景复杂度的不断提升,图机器学习的瓶颈问题也越发凸显。近期,大型语言模型在自然语言处理领域大放异彩,其出色的语言理解和总结能力备受瞩目。正因如此,将大语言模型与图学习技术相融合,以提升图学习任务的效能,已成为业界新的研究热点。
这篇综述针对当前图学习领域的关键技术挑战,如模型泛化能力、鲁棒性,以及复杂图数据的理解能力等,进行了深入分析,并展望了未来大模型技术在突破这些 "未知边界" 方面的潜力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文地址:https://arxiv.org/abs/2405.08011
项目地址:https://github.com/HKUDS/Awesome-LLM4Graph-Papers
港大数据智能实验室:https://sites.google.com/view/chaoh/home
该综述深入回顾了最新应用于图学习中的 LLMs,并提出了一种全新的分类方法,依据框架设计对现有技术进行了系统分类。其详尽剖析了四种不同的算法设计思路:一是以图神经网络为前缀,二是以大语言模型为前缀,三是大语言模型与图集成,四是仅使用大语言模型。针对每一类别,我们都着重介绍了其中的核心技术方法。此外,该综述还深入探讨了各种框架的优势及其局限性,并指明了未来研究的潜在方向。
香港大学数据智能实验室的黄超教授领导的研究团队,将在 KDD 2024 大会上深入探讨大模型在图学习领域所面临的 "未知边界"。
1 基本知识
在计算机科学领域,图(Graph)是一种重要的非线性数据结构,它由节点集(V)和边集(E)构成。每条边连接一对节点,并可能是有向的(具有明确的起点和终点)或无向的(不指定方向)。特别值得一提的是,文本属性图(Text-Attributed Graph, TAG)作为图的特殊形式,为每个节点分配了一个序列化的文本特征,如句子,这一特性在大型语言模型时代显得尤为关键。文本属性图可以规范地表示为由节点集 V、边集 E 和文本特征集 T 组成的三元组,即 G* = (V, E, T)。
图神经网络(Graph Neural Networks, GNNs)是针对图结构数据设计的深度学习框架。它通过聚合邻近节点的信息来更新节点的嵌入表示。具体来说,GNN 的每一层都会通过特定的函数来更新节点嵌入 h,该函数综合考虑当前节点的嵌入状态以及周边节点的嵌入信息,从而生成下一层的节点嵌入。
大型语言模型(Large Language Models, LLMs)是一种强大的回归模型。近期研究显示,包含数十亿参数的语言模型在解决多种自然语言任务时表现卓越,如翻译、摘要生成和指令执行,因而被称为大型语言模型。目前,大多数前沿的 LLMs 都基于采用查询 - 键 - 值(QKV)机制的 Transformer 块构建,该机制能高效地在词元序列中整合信息。根据注意力的应用方向和训练方式,语言模型可分为两大类型:
掩码语言建模(Masked Language Modeling, MLM)是一种广受欢迎的 LLMs 预训练目标。它涉及在序列中选择性地掩盖特定的词元,并训练模型依据周边上下文预测这些被掩盖的词元。为实现精准预测,模型会综合考虑被掩盖词元的前后文环境。
因果语言建模(Causal Language Modeling, CLM)是另一种主流的 LLMs 预训练目标。它要求模型根据序列中先前的词元预测下一个词元。在此过程中,模型仅依据当前词元之前的上下文来进行准确的预测。
2 图学习与大语言模型
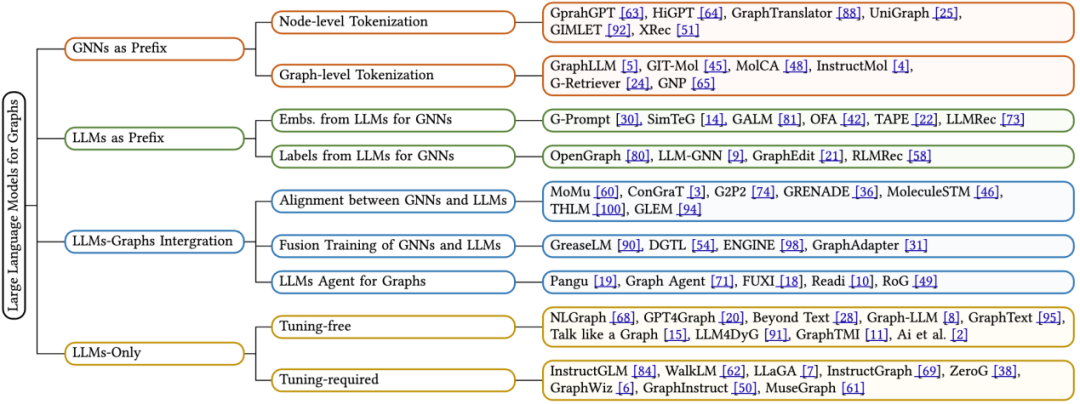
在这篇综述文章中,作者依据模型的推理流程 —— 即图数据、文本数据的处理方式以及与大型语言模型(LLMs)的交互方式,提出了一种新的分类方法。具体而言,我们归纳了四种主要的模型架构设计类型,具体如下:
GNNs as Prefix(GNNs 作为前缀):在此类别中,图神经网络(GNNs)作为首要组件,负责处理图数据,并为 LLMs 提供具有结构感知的标记(如节点级、边级或图级标记),以供后续推理使用。
LLMs as Prefix(LLMs 作为前缀):在这一类别中,LLMs 首先处理附带文本信息的图数据,随后为图神经网络的训练提供节点嵌入或生成的标签。
LLMs-Graphs Integration(LLMs 与图集成):该类别的方法致力于实现 LLMs 与图数据之间更为深入的整合,例如通过融合训练或与 GNNs 的对齐。此外,还构建了基于 LLM 的智能体(agent),以便与图信息进行交互。
LLMs-Only(仅使用 LLMs):此类别设计了实用的提示技巧,将图结构化数据嵌入到词元序列中,从而便于 LLMs 进行推断。同时,部分方法还融合了多模态标记,进一步丰富了模型的处理能力。
2.1 GNNs as Prefix
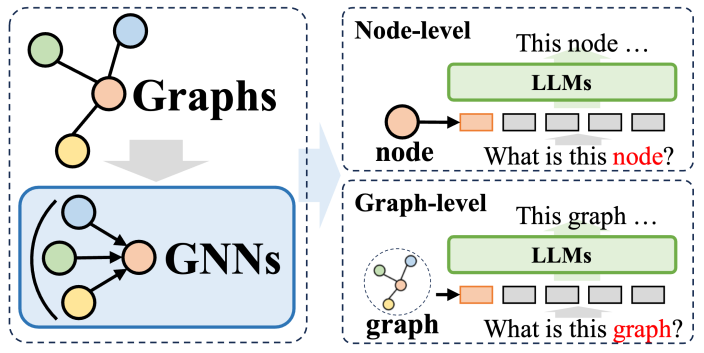
在图神经网络(GNNs)作为前缀的方法体系中,GNNs 发挥着结构编码器的作用,显著提升了大型语言模型(LLMs)对图结构数据的解析能力,从而为多种下游任务带来益处。这些方法里,GNNs 主要作为编码器,负责将复杂的图数据转换为包含丰富结构信息的图 token 序列,这些序列随后被输入到 LLMs 中,与自然语言处理流程相契合。
这些方法大体上可分为两类:首先是节点级 Token 化,即将图结构中的每个节点单独输入到 LLM 中。这一做法的目的是使 LLM 能够深入理解细粒度的节点级结构信息,并准确辨别不同节点间的关联与差异。其次是图级 Token 化,它采用特定的池化技术将整个图压缩为固定长度的 token 序列,旨在捕捉图结构的整体高级语义。

对于节点级 Token 化而言,它特别适用于需要建模节点级别精细结构信息的图学习任务,如节点分类和链接预测。在这些任务中,模型需要能够区分不同节点间的细微语义差别。传统的图神经网络会根据相邻节点的信息为每个节点生成一个独特的表示,然后基于此进行下游的分类或预测。节点级 Token 化方法能够最大限度地保留每个节点的特有结构特征,对下游任务的执行大有裨益。
另一方面,图级 Token 化则是为了适应那些需要从节点数据中提炼全局信息的图级任务。在 GNN 作为前缀的框架下,通过各种池化操作,图级 Token 化能够将众多节点表示综合成一个统一的图表示,这样不仅能够捕获图的全局语义,还能进一步提升各类下游任务的执行效果。
2.2 LLMs as Prefix

大语言模型(LLMs)前缀法利用大型语言模型生成的丰富信息来优化图神经网络(GNNs)的训练过程。这些信息涵盖了文本内容、LLMs 产生的标签或嵌入等多种数据。根据这些信息的应用方式,相关技术可分为两大类:一是利用 LLMs 生成的嵌入来助力 GNNs 的训练;二是将 LLMs 生成的标签整合到 GNNs 的训练流程中。
在利用 LLMs 嵌入方面,GNNs 的推理过程涉及节点嵌入的传递与聚合。然而,初始节点嵌入的质量和多样性在不同领域中差异显著,例如推荐系统中的 ID 基础嵌入或引文网络中的词袋模型嵌入,可能缺乏清晰度和丰富性。这种嵌入质量的不足有时会限制 GNNs 的性能表现。此外,缺乏通用的节点嵌入设计也影响了 GNNs 在处理不同节点集时的泛化能力。幸运的是,通过借助大型语言模型在语言总结和建模方面的卓越能力,我们可以为 GNNs 生成富有意义和效果的嵌入,从而提升其训练效果。
在整合 LLMs 标签方面,另一种策略是将这些标签作为监督信号,以增强 GNNs 的训练效果。值得注意的是,这里的监督标签不仅限于传统的分类标签,还包括嵌入、图等多种形式。由 LLMs 生成的信息并不直接作为 GNNs 的输入数据,而是构成了更为精细的优化监督信号,从而帮助 GNNs 在各种图相关任务上取得更加卓越的性能。
2.3 LLMs-Graphs Intergration
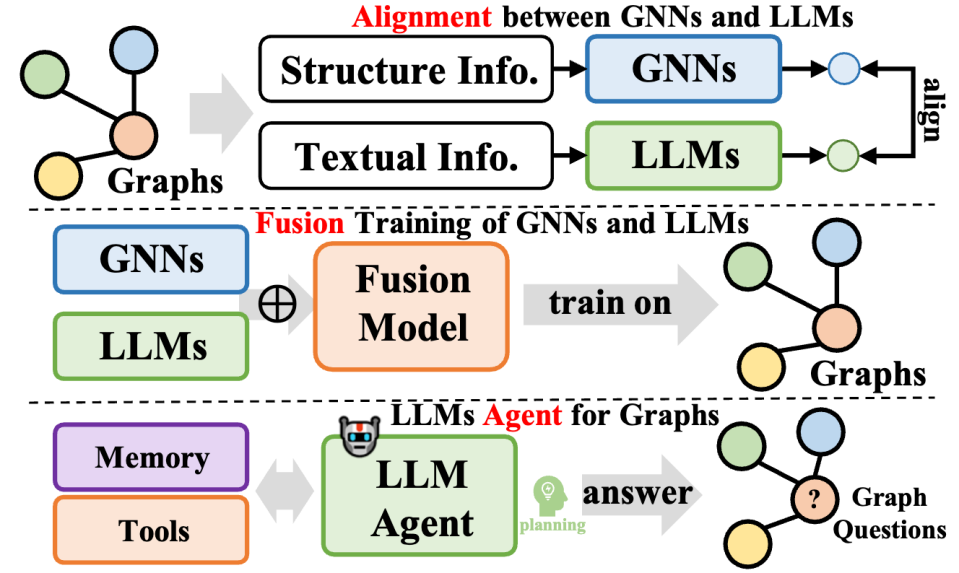
该类方法进一步整合了大型语言模型与图数据,涵盖多样化的方法论,不仅提升了大型语言模型(LLMs)在图处理任务中的能力,同时也优化了图神经网络(GNNs)的参数学习。这些方法可被归纳为三种类型:一是 GNNs 与 LLMs 的融合,旨在实现模型间的深度整合与共同训练;二是 GNNs 与 LLMs 之间的对齐,专注于两种模型在表示或任务层面上的对齐;三是构建基于 LLMs 的自主智能体,以规划和执行图相关任务。
在 GNNs 与 LLMs 的融合方面,通常 GNNs 专注于处理结构化数据,而 LLMs 则擅长处理文本数据,这导致两者具有不同的特征空间。为了解决这一问题,并促进两种数据模态对 GNNs 和 LLMs 学习的共同增益,一些方法采用对比学习或期望最大化(EM)迭代训练等技术,以对齐两个模型的特征空间。这种做法提升了图和文本信息的建模精度,从而在各种任务中提高了性能。
关于 GNNs 与 LLMs 的对齐,尽管表示对齐实现了两个模型的共同优化和嵌入级别的对齐,但在推理阶段它们仍是独立的。为了实现 LLMs 和 GNNs 之间更紧密的集成,一些研究聚焦于设计更深层次的模块架构融合,例如将 LLMs 中的变换器层与 GNNs 中的图神经层相结合。通过共同训练 GNNs 和 LLMs,可以在图任务中为两个模块带来双向的增益。
最后,在基于 LLM 的图智能体方面,借助 LLMs 在指令理解和自我规划解决问题上的出色能力,新的研究方向是构建基于 LLMs 的自主智能体,以处理人类给出的或与研究相关的任务。通常情况下,这样的智能体包括记忆、感知和行动三个模块,形成观察、记忆回忆和行动的循环,用于解决特定任务。在图论领域,基于 LLMs 的智能体能够直接与图数据进行交互,执行如节点分类和链接预测等任务。
2.4 LLMs-Only
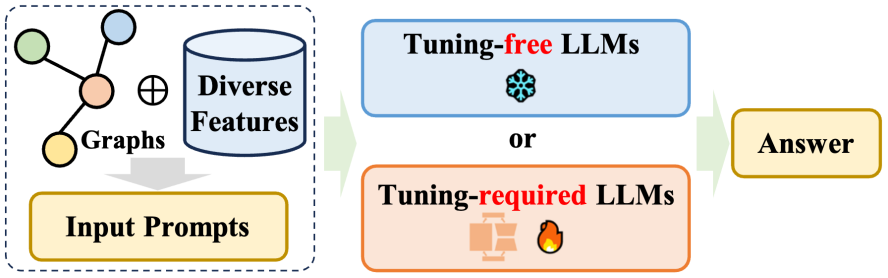
该综述在 LLMs-Only 的章节中详细阐述了直接将大型语言模型(LLMs)应用于各种以图为导向任务的情况,即所谓的 “仅 LLMs” 类别。这些方法的目标是让 LLMs 能够直接接受图结构信息,理解它,并结合这些信息对各种下游任务进行推理。这些方法主要可以分为两大类:i)无需微调的方法,旨在设计 LLMs 能够理解的提示,直接促使预训练的 LLMs 执行以图为导向的任务;ii)需要微调的方法,专注于将图转换为特定方式的序列,并通过微调方法对齐图 token 序列和自然语言 token 序列。
无需微调的方法:鉴于图数据独特的结构特性,出现了两个关键挑战:一是有效地用自然语言格式构建图;二是确定大型语言模型(LLMs)是否能够准确理解以语言形式表示的图结构。为了解决这些问题,一部分研究人员开发了无需调整的方法,在纯文本空间内对图进行建模和推理,从而探索预训练 LLMs 在增强结构理解方面的潜力。
需要微调的方法:由于使用纯文本表达图结构信息存在局限性,近期的主流方法是在将图输入到大型语言模型(LLMs)时,将图作为节点 token 序列与自然语言 token 序列对齐。与前述的 GNN 作为前缀的方法不同,需要调整的仅 LLM 方法放弃了图编码器,转而采用特定的文本描述来体现图结构,并且在提示中精心设计了 prompts,这在各种下游图相关任务中取得了有希望的表现。
3 未来的研究方向
该综述还讨论了大型语言模型在图领域的一些开放问题和潜在的未来研究方向:
多模态图与大型语言模型(LLMs)的融合。近期研究显示,大型语言模型在处理和理解图像、视频等多模态数据方面表现出非凡能力。这一进步为将 LLMs 与包含多种模态特征的多模态图数据相结合提供了新的契机。研发能够处理此类图数据的多模态 LLMs,将使我们在综合考虑文本、视觉、听觉等多种数据类型的基础上,对图结构进行更为精确和全面的推理。
提升效率与降低计算成本。目前,LLMs 的训练和推理阶段涉及的高昂计算成本已成为其发展的重大瓶颈,制约了它们处理包含数百万节点的大规模图数据的能力。当尝试将 LLMs 与图神经网络(GNNs)结合时,由于两种强大模型的融合,这一挑战变得更为严峻。因此,亟待发现并实施有效策略,以降低 LLMs 和 GNNs 的训练计算成本,这不仅有助于缓解当前面临的限制,还将进一步拓展 LLMs 在图相关任务中的应用范围,从而提升它们在数据科学领域的实用价值和影响力。
应对多样化的图任务。当前的研究方法主要集中在传统的图相关任务上,例如链接预测和节点分类。但考虑到 LLMs 的强大能力,我们有必要深入探索其在处理更为复杂和生成性任务方面的潜力,如图生成、图理解以及基于图的问题回答等。通过扩展基于 LLM 的方法以涵盖这些复杂任务,我们将为 LLMs 在不同领域的应用开辟无数新机遇。例如,在药物研发领域,LLMs 可以促进新分子结构的生成;在社交网络分析领域,它们可以提供对复杂关系模式的深入洞察;在知识图谱构建方面,LLMs 则有助于创建更加全面且上下文准确的知识库。
构建用户友好的图智能体。目前,大多数为图相关任务设计的基于 LLM 的智能体都是针对单一任务定制的。这些智能体通常采用单次运行模式,旨在一次性解决问题。然而,理想的基于 LLM 的智能体应具备用户友好性,并且能够动态地在图数据中搜索答案,以响应用户提出的多样化开放式问题。为实现这一目标,我们需要开发一个既灵活又稳健的智能体,它能够与用户进行迭代交互,并熟练应对图数据的复杂性,提供准确且相关的答案。这将要求智能体不仅具备高度的适应性,还需展现出强大的稳健性。
4 总结
该综述对图数据定制的大型语言模型(LLMs)进行了深入探讨,并提出了基于模型的推理框架设的分类方法,将不同的模型细致地划分为四种各具特色的框架设计。每一种设计都展现出其独特的优点与局限性。不仅如此,该综述还对这些特性展开了全面的讨论,深入挖掘了每一种框架在应对图数据处理任务时的潜力和挑战。此项调研工作旨在为那些热衷于探索并应用大型语言模型来解决图相关问题的研究人员提供参考资源,并且希望最终通过这项工作,推动对 LLMs 与图数据结合应用的更深层次理解,进一步催生该领域的技术创新和突破。














