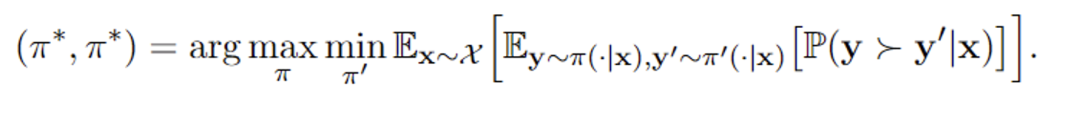讲师中心 微信公众号
AI工具推荐 视频效率加速

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈

落晨大大_7756

落晨大大_7756

发布时间:2024-05-13 15:22:01

|

414人浏览过

|

来源于机器之心

转载

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈
AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com

Richard Sutton 在 「The Bitter Lesson」中做过这样的评价:「从70年的人工智能研究中可以得出的最重要教训是,那些利用计算的通用方法最终是最有效的,而且优势巨大。」

自我博弈(self play)就是这样一种同时利用搜索和学习从而充分利用和扩大计算规模的方法。

今年年初,加利福尼亚大学洛杉矶分校(UCLA)的顾全全教授团队提出了一种自我博弈微调方法 (Self-Play Fine-Tuning, SPIN),可不使用额外微调数据,仅靠自我博弈就能大幅提升 LLM 的能力。

最近,顾全全教授团队和卡内基梅隆大学(CMU)Yiming Yang教授团队合作开发了一种名为「自我博弈偏好优化(Self-Play Preference Optimization, SPPO)」的对齐技术,这一新方法旨在通过自我博弈的框架来优化大语言模型的行为,使其更好地符合人类的偏好。左右互搏再显神通!

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

人类偏好就是尺!sppo对齐技术让大语言模型左右互搏、自我博弈

  • 论文标题:Self-Play Preference Optimization for Language Model Alignment
  • 论文链接:https://arxiv.org/pdf/2405.00675.pdf

技术背景与挑战

大语言模型(LLM)正成为人工智能领域的重要推动力,凭借其出色的文本生成和理解能力在种任务中表现卓越。尽管LLM的能力令人瞩目,但要使这些模型的输出行为更符合实际应用中的需求,通常需要通过对齐(alignment)过程进行微调。

这个过程关键在于调整模型以更好地反映人类的偏好和行为准则。常见的方法包括基于人类反馈的强化学习(RLHF)或者直接偏好优化(Direct Preference Optimization,DPO)。

基于人类反馈的强化学习(RLHF)依赖于显式的维护一个奖励模型用来调整和细化大语言模型。换言之,例如,InstructGPT就是基于人类偏好数据先训练一个服从Bradley-Terry模型的奖励函数,然后使用像近似策略优化(Proximal Policy Optimization,PPO)的强化学习算法去优化大语言模型。去年,研究者们提出了直接偏好优化(Direct Preference Optimization,DPO)。

不同于RLHF维护一个显式的奖励模型,DPO算法隐含的服从Bradley-Terry模型,但可以直接用于大语言模型优化。已有工作试图通过多次迭代的使用DPO来进一步微调大模型 (图1)。

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈

                                  图1.基于Bradley-Terry模型的迭代优化方法缺乏理论理解和保证

如Bradley-Terry这样的参数模型会为每个选择提供一个数值分数。这些模型虽然提供了合理的人类偏好近似,但未能完全捕获人类行为的复杂性。

这些模型往往假设不同选择之间的偏好关系是单调和传递的,而实证证据却常常显示出人类决策的非一致性和非线性,例如Tversky的研究观察到人类决策可能会受到多种因素的影响,并表现出不一致性。

SPPO的理论基础与方法

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈

                                 图2.假想的两个语言模型进行常和博弈。

在这些背景下,作者提出了一个新的自我博弈框架 SPPO,该框架不仅具有解决两玩家常和博弈(two-player constant-sum game)的可证明保证,而且可以扩展到大规模的高效微调大型语言模型。

具体来说,文章将RLHF问题严格定义为一个两玩家常和博弈 (图2)。该工作的目标是识别纳什均衡策略,这种策略在平均意义上始终能提供比其他任何策略更受偏好的回复。

为了近似地识别纳什均衡策略,作者采用了具有乘法权重的经典在线自适应算法作为解决两玩家博弈的高层框架算法。

在该框架的每一步内,算法可以通过自我博弈机制来近似乘法权重更新,其中在每一轮中,大语言模型都在针对上一轮的自身进行微调,通过模型生成的合成数据和偏好模型的注释来进行优化。

具体来说,大语言模型在每一轮回会针对每个提示生成若干回复;依据偏好模型的标注,算法可以估计出每个回复的胜率;算法从而可以进一步微调大语言模型的参数使得那些胜率高的回复拥有更高的出现概率(图3)。

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈

                                 图3.自我博弈算法的目标是微调自身从而胜过上一轮的语言模型

实验设计与成果

在实验中,研究团队采用了一种Mistral-7B作为基线模型,并使用了UltraFeedback数据集的60,000个提示(prompt)进行无监督训练。他们发现,通过自我博弈的方式,模型能够显著提高在多个评估平台上的表现,例如AlpacaEval 2.0和MT-Bench。这些平台广泛用于评估模型生成文本的质量和相关性。

通过SPPO方法,模型不仅在生成文本的流畅性和准确性上得到了改进,更重要的是:「它在符合人类价值和偏好方面表现得更加出色」。

人类偏好就是尺!SPPO对齐技术让大语言模型左右互搏、自我博弈

                                 图4.SPPO模型在AlpacaEval 2.0上的效果提升显著,且高于如 Iterative DPO 的其他基准方法。

在AlpacaEval 2.0的测试中(图4),经过SPPO优化的模型在长度控制胜率方面从基线模型的17.11%提升到了28.53%,显示了其对人类偏好理解的显著提高。经过三轮SPPO优化的模型在AlpacaEval2.0上显著优于多轮迭代的DPO, IPO和自我奖励的语言模型(Self-Rewarding LM)。

此外,该模型在MT-Bench上的表现也超过了传统通过人类反馈调优的模型。这证明了SPPO在自动调整模型行为以适应复杂任务方面的有效性。

结论与未来展望

自我博弈偏好优化(SPPO)为大语言模型提供了一个全新的优化路径,不仅提高了模型的生成质量,更重要的是提高了模型与人类偏好的对齐度。

随着技术的不断发展和优化,预计SPPO及其衍生技术将在人工智能的可持续发展和社会应用中发挥更大的作用,为构建更加智能和负责任的AI系统铺平道路。

热门AI工具

更多
豆包大模型

豆包大模型是一款由字节跳动推出的企业级大语言模型服务平台。

Seko
Seko Hot

一款AI视频创作工具,主要用于商汤科技推出的创编一体的AI短视频创作Agent,适合需要提升相关任务效率的用户。

SkildArt
SkildArt Hot

SkildArt是一款AI文本写作工具,一站式 AI 视觉创作平台。

DeepSeek

DeepSeek是一款面向对话、写作、编程和推理场景的AI大模型工具。

二狗PPT
二狗PPT Hot

一款AI演示文稿工具,主要用于专为中式职场打造的AI PPT生成工具,适合需要提升相关任务效率的用户。

UpDream
UpDream Hot

一款AI视频创作工具,主要用于哔哩哔哩推出的自研AI视频创作工具,适合需要提升相关任务效率的用户。

LibLibAI
LibLibAI Hot

一款AI视频创作工具,主要用于国内领先的AI创意平台,以海量模型、低门槛操作与“创作-分享-商业化”生态,让小白与专业创作者都能高效实现图文乃至视频创意表达,适合需要提升相关任务效率的用户。

WorkBuddy

一款AI办公效率工具,主要用于腾讯云推出的AI原生桌面智能体工作台,适合需要提升相关任务效率的用户。

VibeKnow
VibeKnow Hot

一款AI视频创作工具,主要用于全球首个AI知识视频创作平台,文档、文章、网页,一键生成视频,适合需要提升相关任务效率的用户。

相关专题

更多
页面置换算法
页面置换算法

页面置换算法是操作系统中用来决定在内存中哪些页面应该被换出以便为新的页面提供空间的算法。本专题为大家提供页面置换算法的相关文章,大家可以免费体验。

4836

2023.08.14

http与https有哪些区别
http与https有哪些区别

http与https的区别:1、协议安全性;2、连接方式;3、证书管理;4、连接状态;5、端口号;6、资源消耗;7、兼容性。本专题为大家提供相关的文章、下载、课程内容,供大家免费下载体验。

5250

2024.08.16

海螺AI提示词大全
海螺AI提示词大全

精选海螺AI进阶隐藏玩法与高效提示词(Prompt)公式。手把手教你如何用海螺AI撰写自媒体爆款文案、网络小说续写、脚本创作,以及利用AI工具落地副业的实战案例。

153

2026.06.02

Buffalo框架数据库开发全教程
Buffalo框架数据库开发全教程

本专题围绕Buffalo框架数据库开发,讲解database.yml多环境配置、soda与fizz迁移生成回滚、模型结构体标签、增删改查与条件查询、一对多与多对多关联、数据校验、回调钩子、事务处理及原生SQL执行能力。

120

2026.09.23

Buffalo框架路由与请求处理实操指南

本专题讲解Buffalo框架路由与请求处理机制,涵盖路由注册与分组、资源路由、Handler编写规范、Context上下文方法、参数绑定、中间件编写挂载、Session与Cookie读写、Flash消息及错误页面定制方法。

60

2026.09.23

Buffalo框架零基础入门教程
Buffalo框架零基础入门教程

本专题整理Buffalo框架入门内容,涵盖Go环境准备、buffalo CLI安装、新项目生成、目录结构说明、dev热加载启动、数据库连接配置与常见报错排查,帮助新手按约定优于配置的思路跑通第一个Buffalo框架应用。

40

2026.09.23

Conan创建软件包配方指南
Conan创建软件包配方指南

本专题介绍通过conanfile.py创建软件包的方法,讲解包名、版本、依赖和构建设置等基础信息,以及source、build、package、package_info等常用方法的作用及编写思路。

40

2026.09.22

Conan二进制包配置指南
Conan二进制包配置指南

本专题介绍Conan根据操作系统、编译器、架构和构建类型生成二进制包的方法,讲解Profile、Settings、Options及Package ID的作用,帮助管理不同平台和编译环境下的包版本。

40

2026.09.22

Conan私有仓库搭建教程
Conan私有仓库搭建教程

本专题系统的讲解Conan私有仓库的搭建流程,涵盖仓库服务部署、存储目录配置、用户认证、权限划分和远程地址添加,并介绍内部C++依赖包的上传、下载及版本维护方法。

40

2026.09.22

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
相关推荐
/
热门推荐
/
最新课程
Buffalo框架快速入门指南
Buffalo框架快速入门指南

共0课时 | 0人学习

Conan 2 Essentials 免费课程

共0课时 | 0人学习

Conan 2 高级依赖模型介绍
Conan 2 高级依赖模型介绍

共0课时 | 0人学习

关于我们 免责申明 举报中心 意见反馈 讲师合作 广告合作 最新更新
php中文网:公益在线php培训,帮助PHP学习者快速成长!
关注服务号
PHP中文网订阅号
每天精选资源文章推送

Copyright 2014-2026 https://www.php.cn/ All Rights Reserved | php.cn