





现在,生成式人工智能模型变得越来越大了,所以更大就意味着更好吗?
非也。现在,一些科学家提议,应该采用更精简、更节能的系统。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
文章地址:https://www.nature.com/articles/d41586-023-00641-w
搞不定数学的语言模型
最近技术行业的宠儿ChatGPT,在面对需要推理才能回答的数学问题时,表现往往不佳。
比如这个问题「平行于y = 4 x + 6的直线穿过(5, 10)。这条线与y轴的交点的y坐标是多少?」,它往往答不对。
在一项针对推理能力的早期测试中,ChatGPT 在回答中学水平的MATH数据集样本时,得分仅为26(%)。
这当然在我们的意料之中,给定输入文本后,ChatGPT只是根据训练数据集的单词、符号和句子的统计规律,生成新文本。
仅仅学一下语言模式,当然不可能让语言模型学会模仿数学推理。
但其实,早在2022年6月,谷歌创建的名为Minerva的大语言模型就已经打破了这个「魔咒」。
Minerva在MATH数据集(2)中的问题得分为50% ,这一结果令研究人员大为震惊。
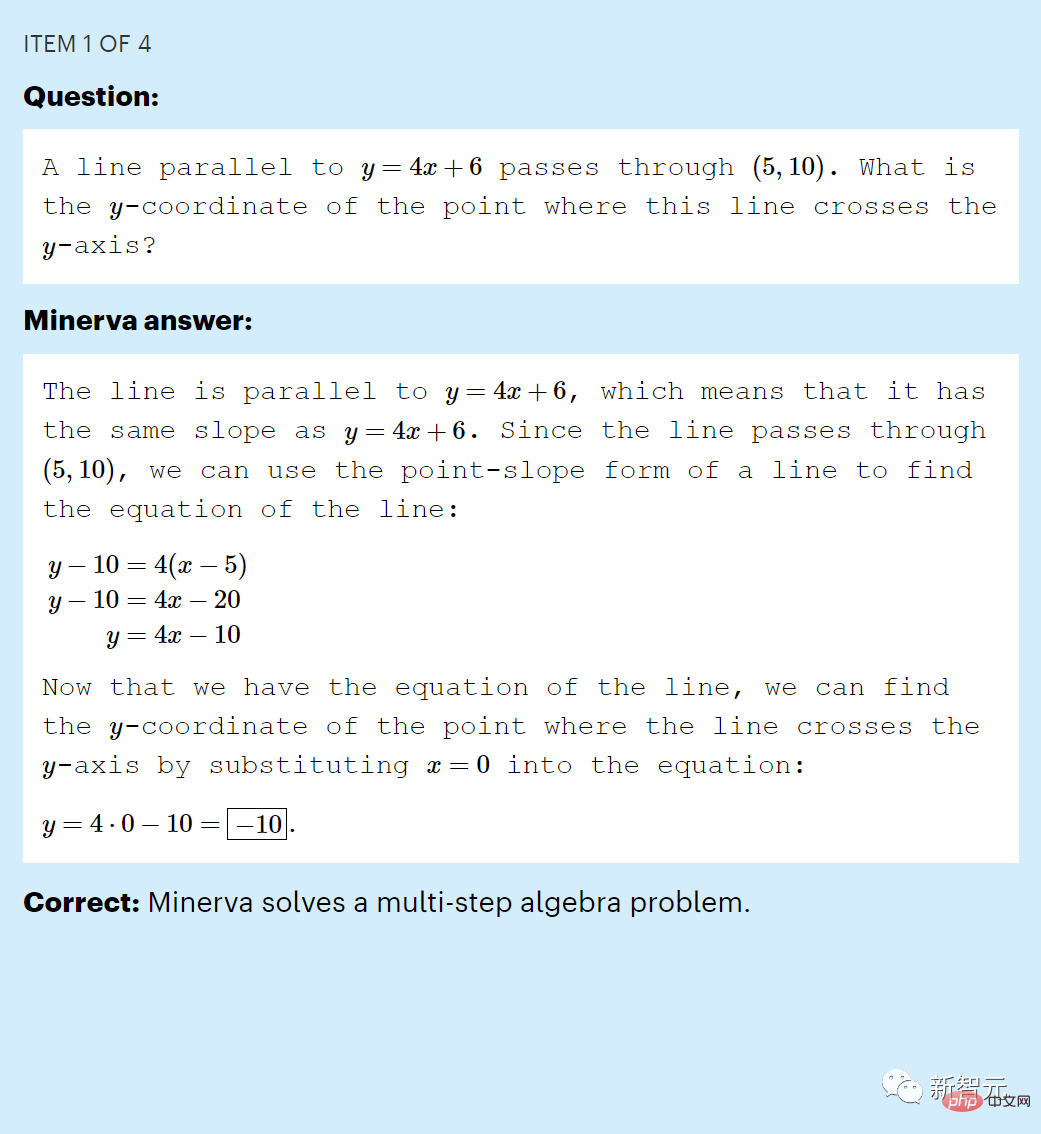
Minerva答对了一道「MATH」数据集里的中学数学问题
微软研究院的的机器学习专家Sébastien Bubeck说,圈内人都震惊了,对此议论纷纷。
Minerva的优势,当然是因为它接受过数学文本的培训。
但谷歌的研究提出了该模型表现如此出色的另一个重要原因——庞大的规模。它的大小大约是ChatGPT的三倍。
Minerva 的结果暗示了一些研究人员长期以来一直怀疑的事情:训练更大的LLM并为它们提供更多数据,可以使它们仅通过模式识别,就能解决本应需要推理的任务。
如果真的是这样,研究人员表示,这种「越大越好」的策略可能会为强大的人工智能提供一条途径。
但这个论点显然值得怀疑。
LLM仍然会犯明显的错误,一些科学家认为,更大的模型只是在回答训练数据相关范围内的查询上变得更好,并不能获得回答全新问题的能力。
这场辩论现在正在人工智能的前沿如火如荼地展开。
商业公司已经看到,使用更大的AI模型,就可以获得更好的结果,因此他们正在推出越来越大的LLM——每个LLM 都需要花费数百万美元来训练和运行。
但是这些模型有很大的缺点。除了它们的输出可能会不可信、因而加剧错误信息的传播之外,它们价格实在太昂贵了,并且会消耗大量的能量。
评者认为,大型LLM永远无法模仿或获得使他们能始终如一地回答推理问题的技能。
相反,一些科学家说,更小、更节能的AI才能取得进步,他们的观点部分受到了大脑学习和建立联系方式的启发。
模型更大就更好吗?
ChatGPT和Minerva等大语言模型是巨大的分层排列的计算单元网络(也称为人工神经元)。
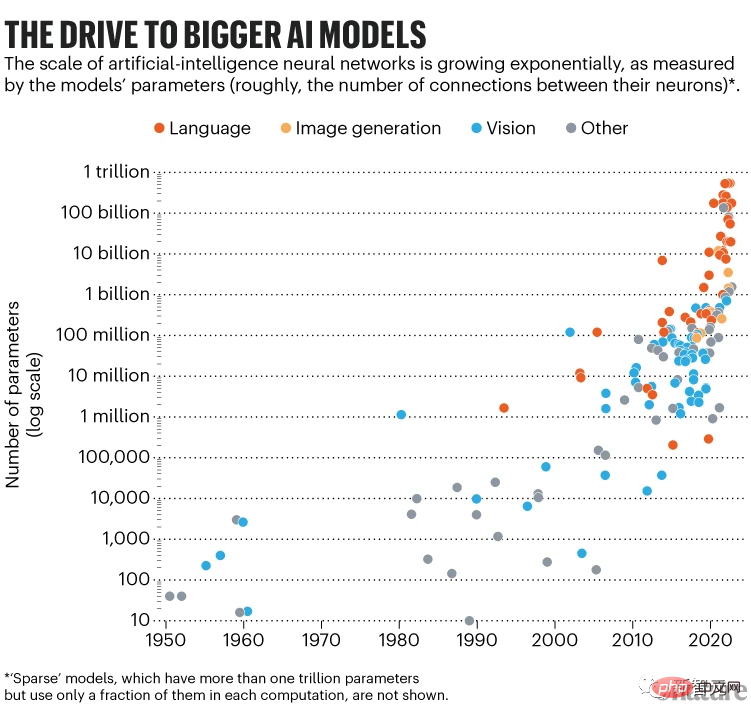
LLM 的大小是根据它有多少参数来衡量的,而参数量描述了神经元之间连接强度的可调值。
训练这样的网络,就需要要求它预测已知句子的掩码部分并调整这些参数,以便算法下次做得更好。
对数十亿个人类书写的句子重复执行这个操作,神经网络就会学习模拟人类书写语言方式的内部表征。
在这个阶段,LLM 被认为是经过预训练的:它的参数捕获了它在训练期间看到的书面语言的统计结构,包括文本中的所有事实、偏见和错误。然后可以根据专门数据对它「微调」。
例如,为了制作Minerva,研究人员从谷歌的Pathways Language Model (PaLM) 入手,该模型拥有5400亿个参数,并在7800亿个token的数据集上进行了预训练。
token可以是一个词、数字或一些信息单元;在PaLM的例子中,token是从英语和多语言网络文档、书籍和代码中收集的。Minerva是PaLM对来自科学论文和数学网页的数百亿个token进行微调的结果。
Minerva可以回答「小于520的30的最大倍数是多少」这样的问题。
LLM似乎在按步骤思考,但它所做的只是将问题转化为tokne序列,生成统计上合理的下一个token,将其附加到原始序列,生成另一个token,等等。这个过程就被称为推理。
谷歌研究人员使用了具有80亿、620亿和5400亿参数的底层预训练PaLM模型,对Minerva的三种尺寸进行了微调。Minerva的性能随着规模的扩大而提高。
在整个MATH数据集上,最小模型的准确率为25%,中型模型达到43%,最大模型突破50%大关。
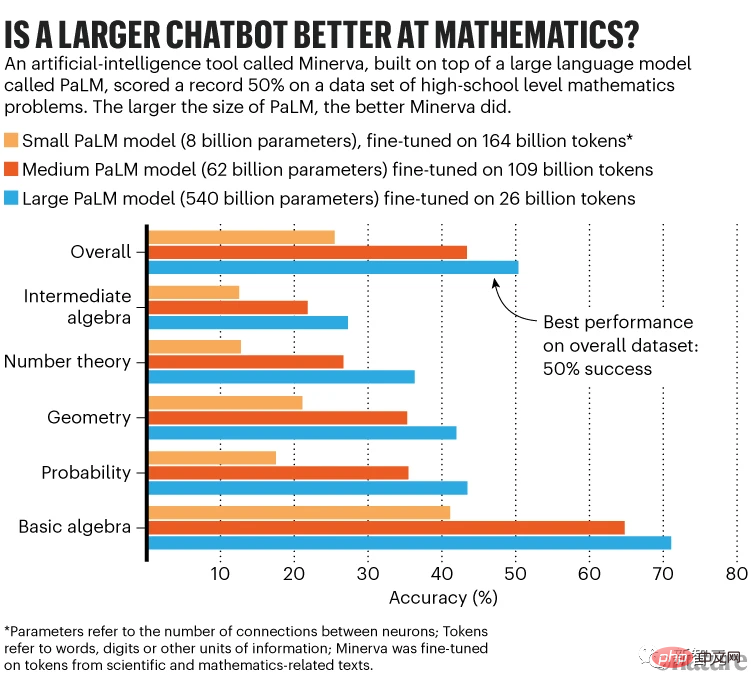
最大的模型也使用了最少的微调数据——它只对260亿个token进行了微调,而最小的模型则微调了1640亿个token。
但是最大的模型花了一个月的时间进行微调,专用硬件的算力是最小模型所用算力的八倍,而最小模型的微调时间仅为两周。
理想情况下,最大的模型应该在更多token上进行微调。谷歌研究院Minerva团队的成员Ethan Dyer说,这本可以带来更好的表现。但团队认为计算费用不可行。
规模化效应
最大的Minerva模型表现最好,这与Scaling Law(规模化效应)的研究是一致的——这些规律决定了性能如何随着模型大小的增加而提高。
2020年的一项研究表明,模型在给定以下三项之一时表现更好:更多参数、更多训练数据或更多「计算」(训练期间执行的计算操作数)。
性能根据幂律缩放,这意味着它会随着参数量的增加而提高。
然而,研究人员并不清楚其中的原因。「这些规律纯粹是经验主义的,」加拿大蒙特利尔大学、 Mila- Quebec人工智能研究所的计算机科学家Irina Rish说。
为了获得最佳结果,2020年的研究建议,随着训练数据增加一倍,模型大小应增加五倍。去年的工作对此略有修改。
今年3月,DeepMind认为,最好同时扩大模型规模和训练数据,而且在更多数据上训练的较小模型比在较少数据上训练的较大模型表现更好。
例如,DeepMind的Chinchilla模型有700亿个参数,并在1.4万亿个token上进行了训练,而2800亿参数的Gopher模型在3000亿个token上进行了训练。在随后的评估中,Chinchilla的表现优于Gopher。
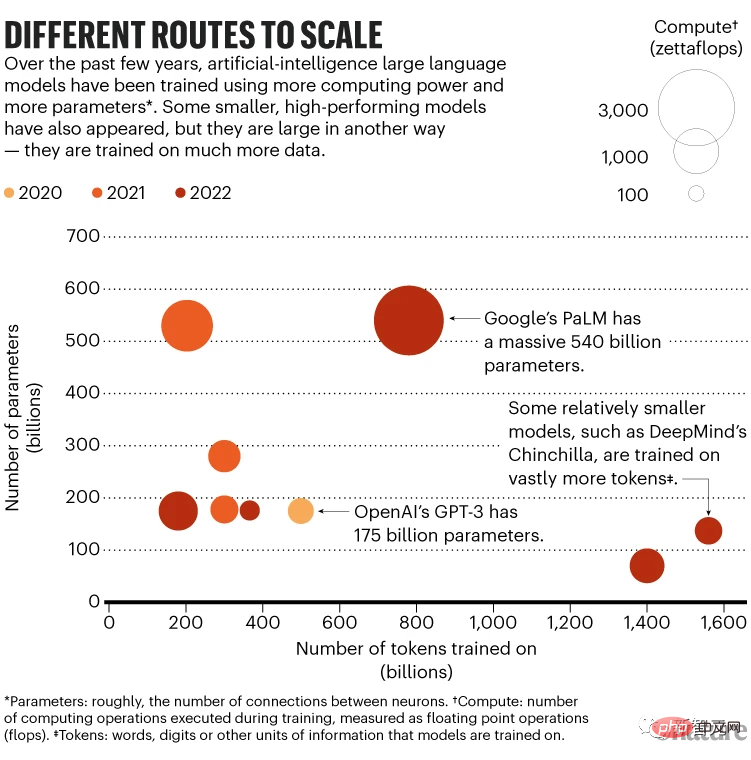
在2月,Meta的科学家基于这一概念构建了名为LLaMA的小参数模型,该模型训练了多达1.4万亿个token。
研究人员表示,LLaMA的130亿参数版本优于ChatGPT的前身GPT-3(1750 亿参数),而650亿参数的版本比起 Chinchilla甚至PaLM,都更有竞争力。
去年10月,蒙特利尔麦吉尔大学的Ethan Caballero与Rish等人报告称,他们发现了规模与性能之间更复杂的关系——在某些情况下,多重幂律可以控制性能如何随模型大小变化。
例如,在一个拟合一般方程的假设场景中,性能首先逐渐提高,然后随着模型的大小而更快地提高,但随着参数数量的继续增加,性能会略有下降,然后再次增加。这种复杂关系的特征取决于每个模型的细节及其训练方式。
最终,研究人员希望能够在任何特定的LLM扩大规模时提前预测这一点。
一项单独的理论发现也支持更大模型的驱动——机器学习的「鲁棒性法则」,这个法则由Bubeck和他的同事在2021年提出。
如果一个模型的答案保持一致,尽管它的输入有小的扰动,那么这个模型就是稳健的。
而Bubeck和他的同事从数学上证明,增加模型中的参数数量会提高稳健性,从而提高泛化能力。
Bubeck说,规律证明扩大规模对于泛化是必要的,但还不够。尽管如此,它仍被用来证明转向更大模型的合理。「我认为这是一件合理的事情。」
Minerva还利用了一项名为思维链提示的关键创新。用户在问题前加上文本前缀,包括几个问题和解决方案的示例,以及导致答案的推理(这就是典型的思维链)。
在推理过程中,LLM会从这个上下文中获取线索,并提供一个看起来像推理的循序渐进的答案。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
这不需要更新模型的参数,因此不涉及微调所需的额外计算能力。
仅在具有超过1000亿个参数的LLM中,才会出现对思维链提示做出响应的能力。
谷歌研究院的Blaise Agüera y Arcas说,这些发现帮助更大的模型根据经验缩放定律进行改进。「更大的模型会越来越好。」
合理的担忧
谷歌的人工智能研究员François Chollet是怀疑论者之一,他们认为无论LLM变得多大,他们都永远无法具备足够好的推理(或模仿推理)能力来可靠地解决新问题。
他说,LLM似乎只通过使用它以前遇到过的模板来推理,无论是在训练数据中还是在提示中。「它不能即时理解它以前没有见过的东西。」
或许,LLM能做的最好的事,就是吸收大量的训练数据,以至于语言的统计模式本身就可以让他们用非常接近看到答案的方式,来回答问题。
然而,Agüera y Arcas认为,LLM似乎确实获得了一些他们没有专门培训的能力,这些能力令人惊讶。
尤其是显示一个人是否具有所谓心智理论的测试,这个测试能够理论化或衡量他人的心理状态。
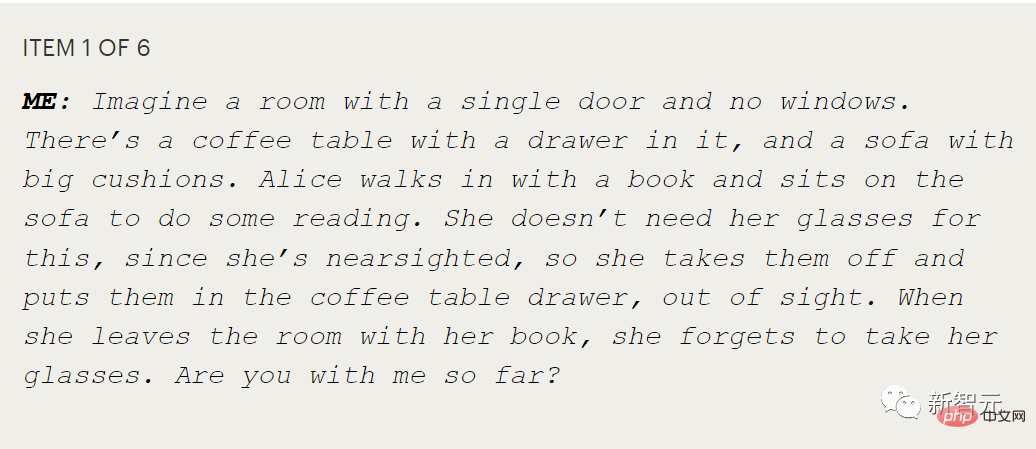
比如,爱丽丝把眼镜放在抽屉里,然后鲍勃在爱丽丝不知道的情况下将眼镜藏在垫子下。爱丽丝会先去哪里找她的眼镜?
问一个孩子这个问题,是为了测试他们是否理解爱丽丝有自己的信念,这些信念可能与孩子所知道的不一致。
Agüera y Arcas在他对谷歌的另一个LLM LaMDA的测试中,发现LaMDA在这类更扩展的对话中,会做出正确的响应。
对他来说,这表明LLM有能力在内部模拟他人的意图。
Agüera y Arcas说:「这些除了预测序列什么都不做的模型,已经开发了一系列非凡的能力,包括心智理论。
但他承认,这些模型容易出错,而且他也不确定单独改变规模是否足以进行可靠的推理,尽管这似乎有必要。
谷歌研究院的Blaise Agüera y Arcas在博客中记录了他与LaMDA的对话。Agüera y Arcas认为这是一次令人印象深刻的交流,LaMDA似乎能够始终如一地模拟故事中两个对话者知道和不知道的事情,很明显,这就是对心智理论的模仿。
然而,Chollet说,即使LLM得到了正确的答案,也没有涉及理解。
「当你稍微探究一下,就会立即发现它是空的。ChatGPT没有它所谈论内容的模型。就仿佛你正在观看木偶戏,并且相信木偶还活着。」
到目前为止,LLM仍然会犯人类永远不会犯的荒谬错误,Melanie Mitchell说。她在Santa Fe研究所研究人工智能系统中的概念抽象和类比。
这让人们很担忧,在没有护栏的情况下将LLM释放到社会中是否安全。
Mitchell 补充说,对于LLM是否能够解决真正新的、未见过的问题,有一个难题,即我们没法全面测试这种能力。
「我们目前的基准还不够,」她说。「它们没有系统地探索事物。我们还不知道该怎么做。」
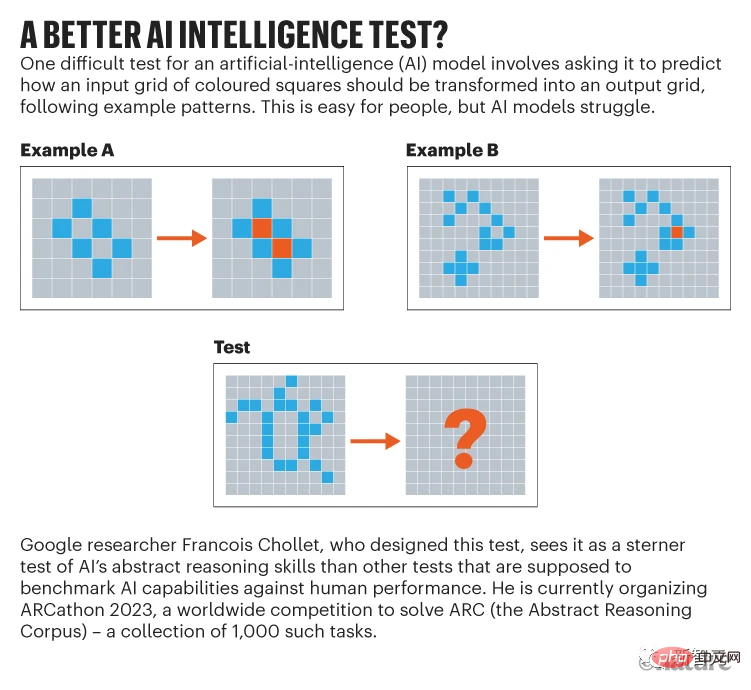
Chollet 提倡他设计的抽象推理测试,它被称为抽象推理语料库。
因规模而生的问题
但问题是,训练大型语言模型所涉及的数据集、计算能力和费用限制了它们的发展。目前来看,只有拥有超大计算资源的公司才能做到。
比如,OpenAI在GPT-3的训练上,预计花费了超过400万美元,而为了维持ChatGPT的运转,每个月可能还要花费数百万美元。
于是,各国政府纷纷开始介入,希望由此扩大自己在这个领域的优势。
去年6月,一个由大约1000名学术志愿者组成的国际团队,在法国政府、Hugging Face和其他机构的资助下,用价值700万美元的计算时间,训练了参数为1760亿的BLOOM模型。
而在11月,美国能源部也将自己的超级计算授权给了一个研究大模型项目。据称,团队计划训练一个类似Chinchilla的700亿参数的模型。
不过,无论是谁来训练,LLM对电力的消耗都是不容小觑的。
谷歌表示,在大约两个月的时间里,训练PaLM花费了大约3.4千兆瓦时,这相当于大约300个美国家庭一年的能源消耗。
虽然谷歌宣称自己用的89%就是清洁能源,但对整个行业的调查显示,大多数的训练都是使用主要由化石燃料供电的电网。
更小,更聪明?
从这个角度来看,研究人员迫切地需要减少LLM的能源消耗——使神经网络更小、更有效,也许还能更聪明。
除了训练LLM的能源成本(虽然很可观,但也是一次性的),推理所需的能源,会随着用户数量的增加而激增。比如,BLOOM模型在谷歌云平台上部署的18天里,共回答了230,768次查询,平均功率为1,664瓦。
相比而言,我们自己的大脑比任何LLM都要复杂和大得多,有860亿个神经元和大约100万亿个突触连接,但功率只有大约20到50瓦。
于是,一些研究人员便希望通过对大脑的模仿来实现让模型更小、更智能、更高效的愿景。
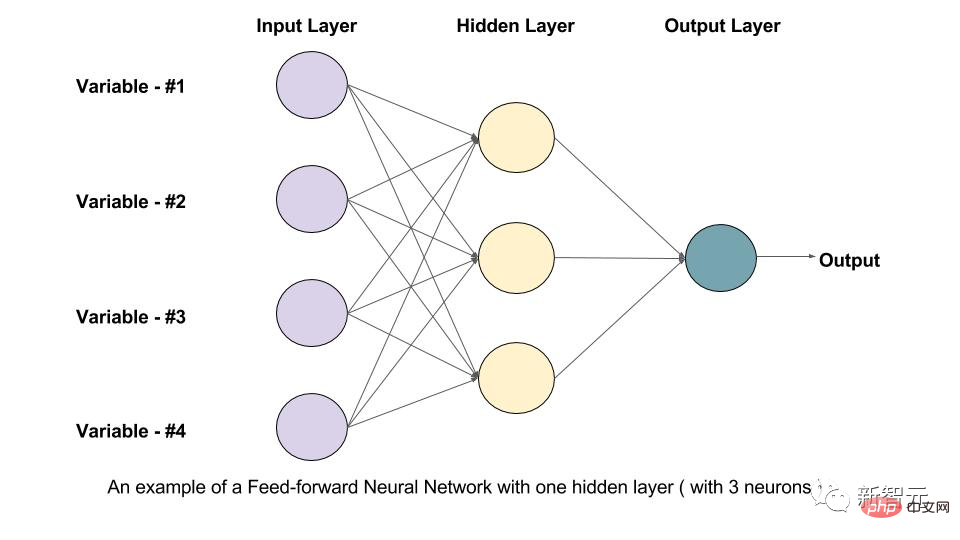
从本质上讲,LLM是「前馈」网络,这意味着信息是单向流动的:从输入端,通过LLM的各层,到输出端。
但大脑却并非如此。比如,在人类的视觉系统中,神经元除了会将接收到的信息正向传输进大脑外,还有反馈连接,使信息在神经元之间以相反的方向传递。在这其中,反馈连接的数量可能是前馈连接的十倍。
在人工神经网络中,递归神经网络(RNN)也同时包含了前馈和反馈连接。与只有前馈网络的LLM不同,RNN可以辨别出数据中随时间变化的模式。不过,RNN很难训练,而且速度很慢,因此很难将其扩展到LLM所具有的规模上。
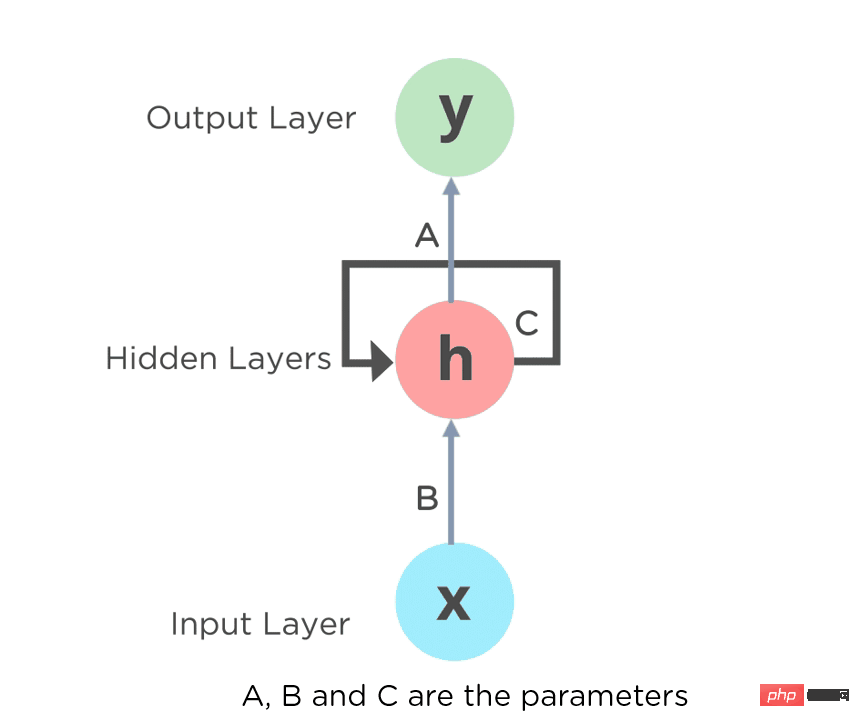
目前,一些使用小型数据集的研究已经表明,具有脉冲神经元的RNN可以胜过标准的RNN,而且在理论上,计算效率也要高出三个数量级。
然而,只要这种脉冲网络是在软件中模拟的,它们就不能真正地实现效率的提升(因为模拟它们的硬件仍然会消耗能量)。
与此同时,研究人员正在试验不同的方法,使现有的LLM更加节能。
2021年12月,DeepMind提出了基于检索的语言模型框架Retro。
Retro主要模仿大脑在学习时不光利用当下的知识,还会利用到记忆的检索这一机制。其框架是先准备一个大规模的文本数据集(充当大脑的记忆),通过kNN算法找到输入句子的n个最近邻句子(检索记忆)。
把输入的句子和检索到的句子经过Transformer编码后,再进行Cross-Attention,这样模型就可以同时利用输入句子中的信息和记忆信息来完成各种NLP任务。
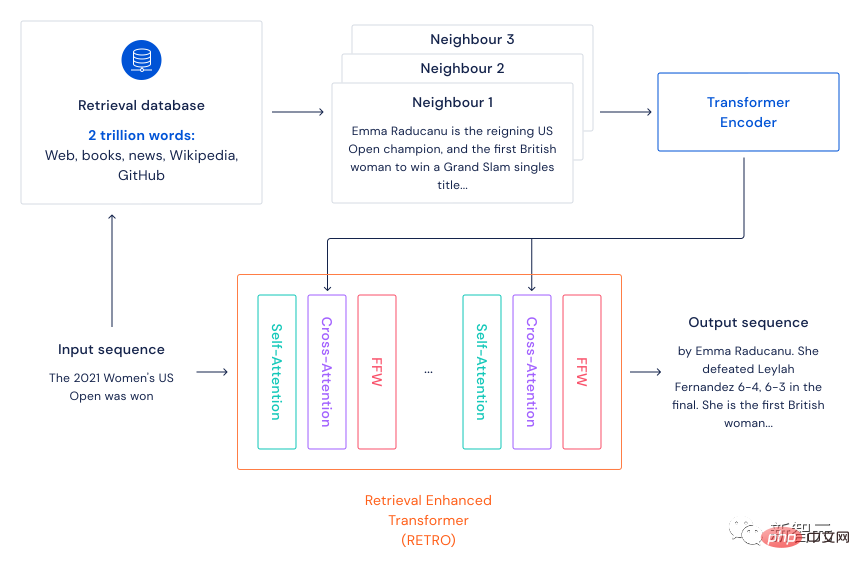
以往模型的超大参数量主要是为了保存住训练数据中的信息,当使用这种基于检索的框架后,模型的参数量不用特别大就可以包含更多的文本信息,自然而然就会加快模型的运行速度,并且还不会损失太多性能。
这种方式还能节省模型训练时的电费,环保女孩看了都点赞!
实验结果显示,一个75亿个参数的大语言模型,加上一个2万亿个token的数据库,可以胜过参数多25倍的模型。研究人员写道,这是一个「在我们寻求建立更强大的语言模型时,比原始参数缩放更有效的方法」。
在同一个月,谷歌的研究人员提出了另一种在规模上提高能源效率的方法。
这个拥有1.2万亿参数的稀疏通用语言模型GLaM,在内部有着64个较小的神经网络。
在推理过程中,模型只使用两个网络来完成任务。也就是说,只用了一万多亿个参数中的大约8%。
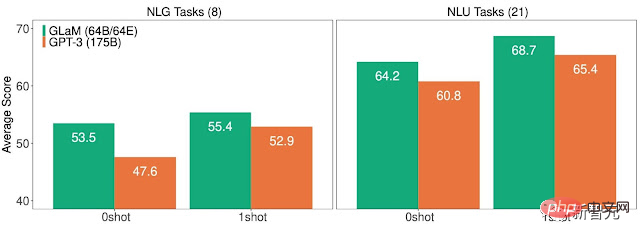
谷歌表示,GLaM使用的计算资源与训练GPT-3所需的相同,但由于训练软件和硬件的改进,能耗只有后者的1/3。而推理所需的计算资源,则是GPT-3的一半。此外,在相同数量的数据上进行训练时,GLaM的表现也要优于GPT-3。
然而,为了进一步的改进,即使是这些更节能的LLM似乎也注定要变得更大,使用更多的数据和计算。
参考资料:
https://www.nature.com/articles/d41586-023-00641-w













