


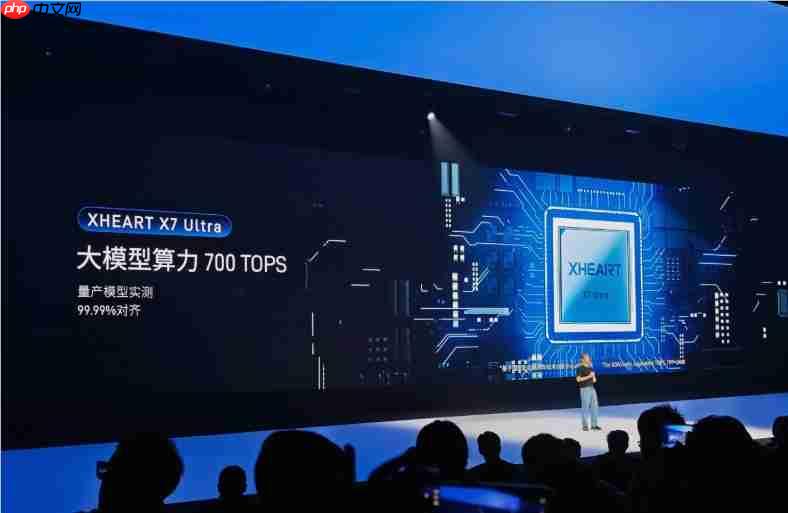
10月29日,xheart新芯航途正式推出全新一代智能驾驶大模型专用芯片——x7ultra。随着智能驾驶技术加速从传统分散式小模型架构迈向“端到端大模型”范式,新芯航途坚持“以大模型定义芯片”的底层设计理念,在公司创立初期即锚定真实量产大模型的底层需求,逆向重构芯片的计算架构、存储体系与数据通路,并为后续模型迭代预留充足的硬件演进空间。
在核心算力与架构层面,X7Ultra面向大模型场景实现700TOPS的峰值AI算力,实测中与量产模型的精度对齐度达99.99%。该芯片专为Transformer类大模型深度定制,采用超大核NPU架构,核内数据交互带宽跃升至TB/s量级,相较传统核间通信方式实现数量级提升。其多级缓存系统兼顾超大容量与高并发访问能力,显著压缩推理延迟并优化功耗表现。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

大模型 Token 成本节约工具。在请求到达大模型之前自动压缩 prompt 和上下文,减少 60-95% 的 token 消耗,直接降低 API 成本。支持 Claude/OpenAI/Gemini 等主流模型,提供代理模式、CLI 包装、Python SDK 和 MCP Server 四种接入方式。内置一键安...
为兼顾模型精度与运行效率,X7Ultra集成了高精度大模型专属算子加速引擎,对Layernorm、Softmax、Transpose等Transformer核心算子进行全硬件级深度优化,并原生支持FP16/FP32高精度向量运算。依托上述创新,NPU硬件并行资源被极致释放,实际计算利用率高达98.7%;相较当前主流旗舰芯片,内存带宽占用降低80%,整机能效比提升100%。
除卓越的NPU性能外,X7Ultra还首次在国内实现Armv9车规级CPU的量产落地,CPU性能提升20%,能效提升10%。同时,通过升级的大规模集群架构,芯片大幅强化了多核协同调度能力与L3缓存访存效率,并集成新一代SVE2向量处理引擎,在数字信号处理(DSP)任务中相较上一代NEON指令集展现出更强的计算吞吐与灵活性。














