








php 8.6读取很大的json数组文件时,可以让jsonmachine逐项解析目标数组,避免先把整个文件读成字符串再json_decode。下面固定读取results子树,把每项解码为数组后处理;内存仍受单个元素大小和业务保留数据量影响,并非无条件恒定。
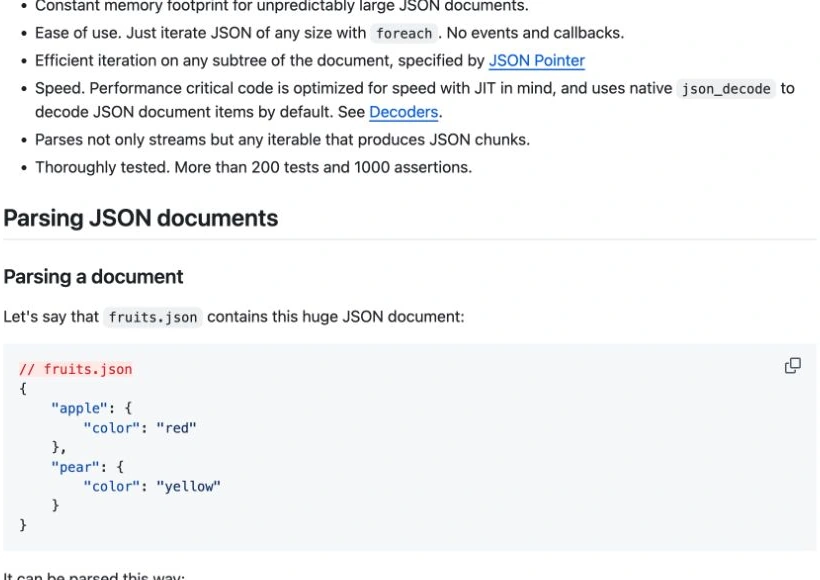
官方文档:Parsing a document
安装并准备固定输入文件
使用halaxa/json-machine 1.2系列。示例private/input.json放在Web根目录之外;实际输入应先由上传流程校验来源、大小与归属,不能直接接受任意本地路径。
composer require halaxa/json-machine:"^1.2"
{"results":[{"id":1,"title":"Alpha"},{"id":2,"title":"Beta"}]}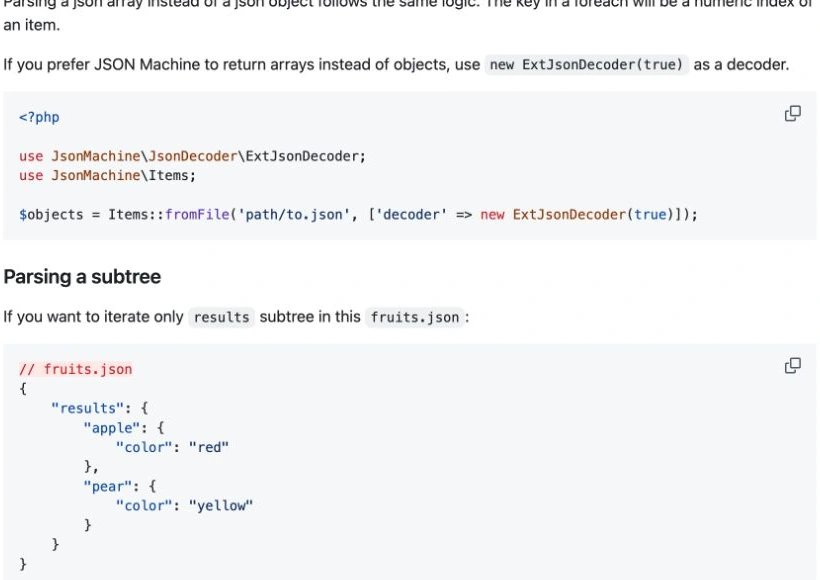
官方文档:Parsing a subtree
只遍历需要的子树
保存import.php。pointer采用JSON Pointer语法,/results选择该字段;如果文件本身就是顶层数组,可移除pointer。不要在循环里重新把全部记录加入一个无限增长的数组。
<?php
require __DIR__.'/vendor/autoload.php';
use JsonMachine\Items;
use JsonMachine\JsonDecoder\ExtJsonDecoder;
$file = __DIR__.'/private/input.json';
if (!is_file($file) || !is_readable($file)) throw new RuntimeException('Input unavailable');
$count = 0;
try {
    $items = Items::fromFile($file, [
        'pointer'=>'/results', 'decoder'=>new ExtJsonDecoder(true)
    ]);
    foreach ($items as $index => $row) {
        if (!is_array($row) || !is_int($row['id'] ?? null)
            || !is_string($row['title'] ?? null) || strlen($row['title'])>1000) {
            throw new UnexpectedValueException('Invalid record at '.$index);
        }
        echo $row['id'], "\t", str_replace(["\r","\n","\t"], ' ', $row['title']), PHP_EOL;
        ++$count;
    }
    fwrite(STDERR, 'Parsed records: '.$count.PHP_EOL);
} catch (Throwable $e) {
    fwrite(STDERR, 'Import stopped after '.$count.' records: '.$e::class.PHP_EOL);
    exit(1);
}
正确理解流式失败的位置
解析器可能到文件后部才发现JSON损坏,因此异常处理必须包住foreach,而不只包住Items::fromFile()。在损坏位置之前输出或写入的记录可能已经生效;需要整批原子导入时,应先写暂存表,全部解析与业务校验通过后再切换,不能把逐条读取误写成自动事务。

exa-js 是 Exa 官方 JavaScript 软件开发工具包,Exa 是一个为 AI 工作流构建的网络搜索 API。它为代理提供了一种具体的方式来搜索网络、检索页面内容,并从代码中生成有来源的答案,而不是手动拼接原始 HTTP 调用。
控制单项大小和后续缓存
如果一个数组元素本身就包含超大字符串或子数组,逐项解析仍可能占用大量内存。可以重新设计输入结构或选择更深的pointer,并限制业务缓存与批量写入缓冲区。JSONMachine只负责解析,不替代业务去重、字段校验及失败恢复。
立即学习“PHP免费学习笔记(深入)”;


















