








starlette 本身不直接提供数据库驱动,而是通过集成异步 orm(如 sqlalchemy 2.0+、tortoise-orm 或 prisma)来实现异步数据库操作。核心做法是:在应用启动时创建异步引擎和会话工厂,在请求处理中通过依赖注入获取会话,执行异步查询后提交或回滚。由于 starlette 的请求生命周期与异步事件循环紧密绑定,必须确保所有数据库调用都在异步上下文中进行,避免阻塞事件循环。
如何配置异步数据库连接
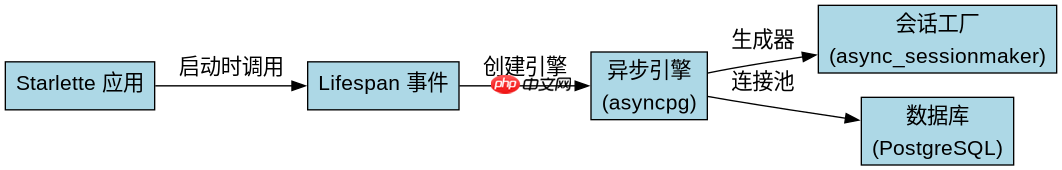
配置异步数据库连接的关键在于使用支持异步的数据库驱动(如 asyncpg 用于 PostgreSQL)并初始化异步引擎。以 SQLAlchemy 2.0+ 为例,需使用 create_async_engine 创建引擎,并通过 async_sessionmaker 定义会话工厂。这一步通常在 Starlette 应用的 lifespan 事件中完成,确保连接池在应用启动时建立,在关闭时释放。
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker
from sqlalchemy.orm import DeclarativeBase

class Base(DeclarativeBase): pass

engine = create_async_engine("postgresql+asyncpg://user:pass@localhost/dbname")
AsyncSessionLocal = async_sessionmaker(engine, expire_on_commit=False)

# 在 Starlette lifespan 中使用
async def startup():
    async with engine.begin() as conn:
        await conn.run_sync(Base.metadata.create_all)

async def shutdown():
    await engine.dispose()
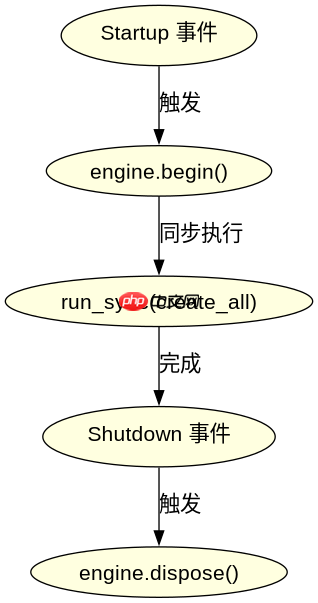
上述代码定义了基础模型类、异步引擎和会话工厂。在 startup 函数中,使用 engine.begin() 确保表结构在首次启动时创建;shutdown 函数则负责清理连接资源。开发者需替换实际的数据库 URL 以匹配环境。

Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
如何在路由中注入数据库会话
在 Starlette 路由中注入数据库会话的最佳实践是使用依赖注入系统。通过定义一个异步依赖函数,该函数在每次请求开始时创建新的数据库会话,并在请求结束后自动关闭。这种方式确保了每个请求拥有独立的会话,避免了并发冲突和资源泄漏。

from fastapi import Depends
from starlette.requests import Request
from sqlalchemy.ext.asyncio import AsyncSession

async def get_db() -> AsyncSession:
    async with AsyncSessionLocal() as session:
        try:
            yield session
            await session.commit()
        except Exception:
            await session.rollback()
            raise

@app.get("/items/")
async def read_items(db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Item))
    return {"items": result.scalars().all()}
此代码展示了 get_db 依赖函数,它使用 yield 模式管理会话生命周期。当请求进入时,创建会话并传递给路由函数;请求结束时,若未发生异常则提交事务,否则回滚。路由函数 read_items 接收 db 参数并执行异步查询。开发者需注意,Starlette 原生不支持 FastAPI 的 Depends,需手动实现类似逻辑或使用第三方库如 starlette-dependencies。
异步查询返回的数据类型是什么
异步查询返回的数据类型取决于所使用的 ORM 和查询方法。在 SQLAlchemy 2.0+ 中,execute 方法返回一个 Result 对象,需调用 scalars() 或 unique() 等方法提取实际数据。例如,result.scalars().all() 返回一个包含模型实例的列表。若查询无结果,返回空列表而非 None。开发者应始终检查返回值类型,避免在模板或 API 响应中直接使用未处理的 Result 对象。



















