








使用 fetch 发起请求后,调用返回的 response 对象的 .text() 方法获取原始字符串。由于 asf(application specific format)通常不是标准的 json 或 xml,浏览器无法直接解析,必须将其视为纯文本处理。拿到字符串后,你需要根据 asf 的具体规范编写自定义解析逻辑,或者使用第三方库进行转换。
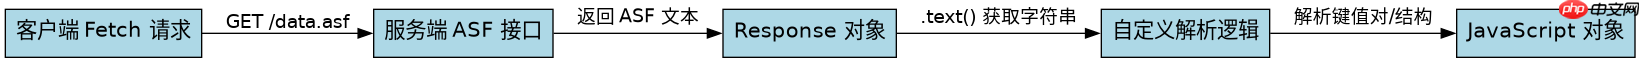
如何获取并验证 ASF 响应内容
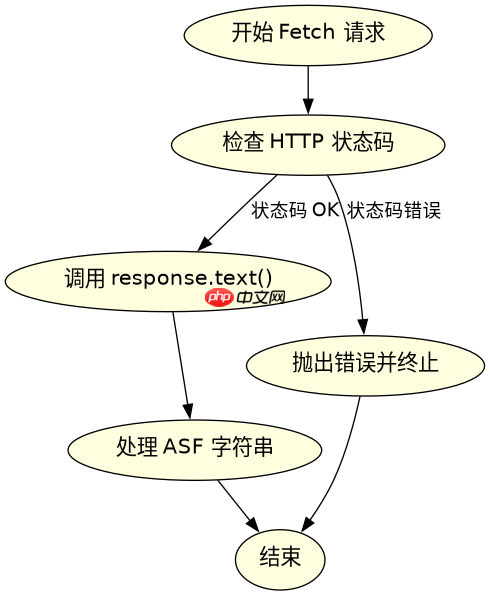
在 JavaScript 中,fetch 默认只处理 HTTP 状态码,不会自动解析非标准格式的数据体。要获取 ASF 数据,最直接的方式是调用 response.text()。这会返回一个 Promise,解析后得到一个包含完整 ASF 内容的字符串。你可以将这段字符串打印到控制台或使用 console.log 进行初步验证,确保网络请求成功且数据完整。
const url = 'https://api.example.com/data.asf';

fetch(url)
  .then(response => {
    if (!response.ok) {
      throw new Error(`HTTP error! status: ${response.status}`);
    }
    return response.text();
  })
  .then(asfData => {
    console.log('Raw ASF Data:', asfData);
    // 在此处进行后续解析
  })
  .catch(error => {
    console.error('Fetch failed:', error);
  });
上述代码展示了基本的获取流程。如果接口返回的是二进制流而非文本,可能需要改用 response.arrayBuffer() 或 response.blob(),但大多数基于文本的 ASF 变体使用 .text() 即可。关键在于确认服务端返回的 Content-Type 是否为 application/octet-stream 或自定义类型,这有助于调试时判断数据是否被正确传输。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何将 ASF 字符串转换为结构化对象
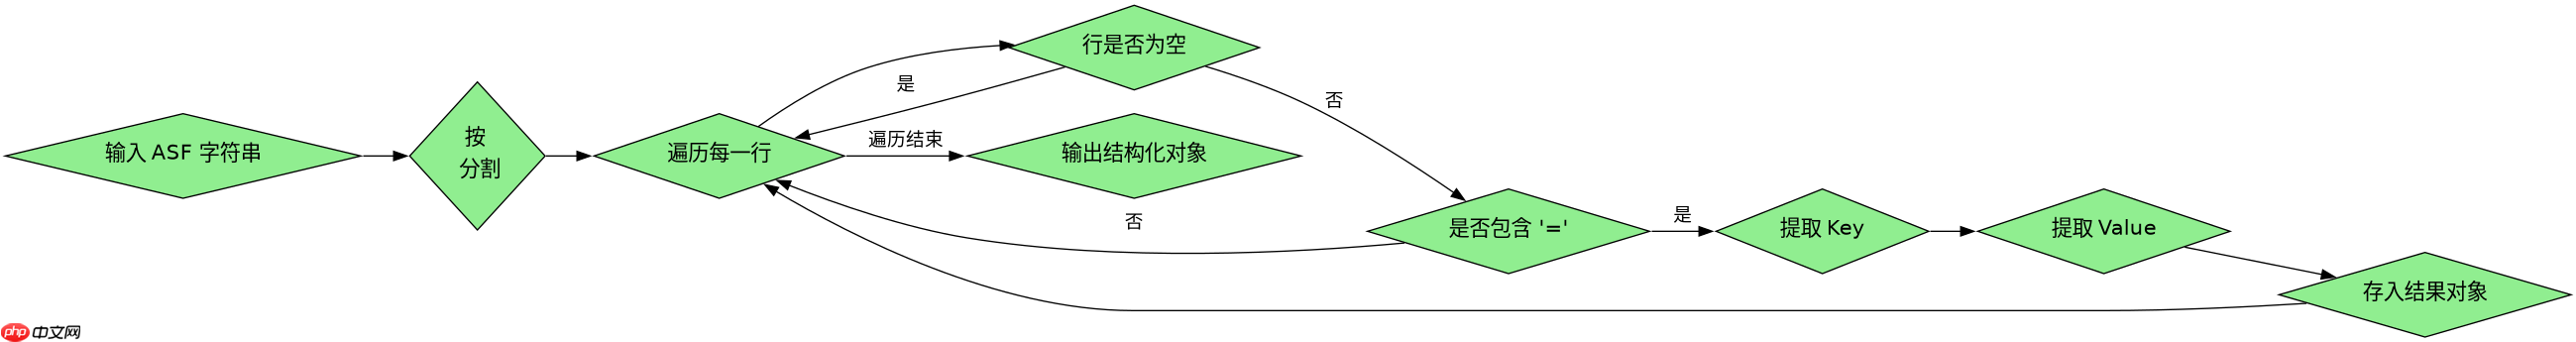
获取到 ASF 字符串后,下一步通常是将其转换为 JavaScript 对象以便使用。ASF 的具体结构取决于定义它的协议或应用层规范。常见的做法是使用正则表达式提取关键字段,或者如果 ASF 是基于键值对的结构,可以使用简单的字符串分割方法。若 ASF 兼容 JSON 或 XML 的子集,也可以尝试用对应的解析器处理,但需做好异常捕获。
function parseAsfString(asfText) {
  const result = {};
  // 假设 ASF 格式为 "KEY=VALUE" 每行一条
  const lines = asfText.split('\n');

  for (const line of lines) {
    const trimmedLine = line.trim();
    if (trimmedLine && trimmedLine.includes('=')) {
      const [key, ...valueParts] = trimmedLine.split('=');
      const value = valueParts.join('='); // 防止值中包含等号
      result[key.trim()] = value.trim();
    }
  }
  return result;
}

// 使用示例
const rawAsf = "title=Example\ndate=2023-10-01\nstatus=active";
const parsedObj = parseAsfString(rawAsf);
console.log(parsedObj); // { title: 'Example', date: '2023-10-01', status: 'active' }
这个解析函数演示了如何处理简单的键值对 ASF 数据。如果你的 ASF 格式更复杂,例如包含嵌套结构或多行值,则需要调整解析逻辑。重要的是,解析过程应与 fetch 调用分离,保持代码的可维护性。在实际项目中,建议将解析逻辑封装成独立的工具函数,并在单元测试中覆盖各种边界情况,如空值、特殊字符和格式错误。
当 ASF 数据包含特殊编码或二进制部分时如何处理
某些 ASF 实现可能包含非 UTF-8 编码的二进制数据,或者使用特定的分隔符。在这种情况下,直接使用 .text() 可能导致乱码或截断。此时应使用 response.arrayBuffer() 获取原始字节,然后使用 TextDecoder 指定正确的编码(如 ISO-8859-1 或 GBK)进行解码。此外,如果 ASF 数据中包含嵌入的二进制块,需要手动定位这些块的偏移量并进行单独处理。
async function fetchAndDecodeAsf(url) {
  const response = await fetch(url);
  if (!response.ok) throw new Error('Network response was not ok');

  const arrayBuffer = await response.arrayBuffer();
  // 假设使用 GBK 编码,因为某些中文 ASF 实现可能使用此编码
  const decoder = new TextDecoder('gbk', { fatal: true });
  try {
    const text = decoder.decode(arrayBuffer);
    return text;
  } catch (error) {
    console.warn('Decoding failed with GBK, trying fallback...', error);
    // 回退到 UTF-8 或其他编码
    const utf8Decoder = new TextDecoder('utf-8');
    return utf8Decoder.decode(arrayBuffer);
  }
}
这种处理方式确保了即使面对非标准编码,也能尽可能正确地还原 ASF 数据。在实际应用中,应根据服务端文档确定正确的编码方式。如果 ASF 数据中包含二进制附件,可能需要进一步解析字节数组,提取特定长度的数据块。总之,处理 ASF 数据的核心在于灵活应对不同的格式和编码要求,确保数据的完整性和准确性。

















