








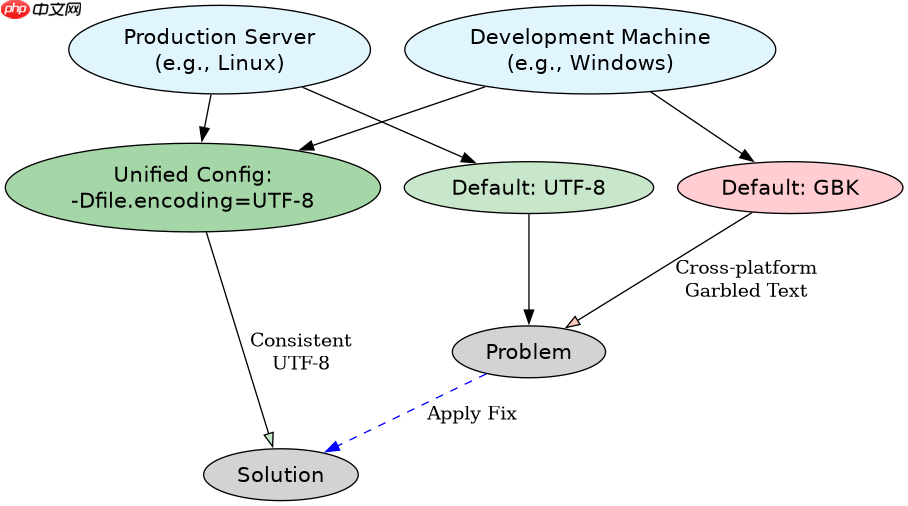
在java项目中统一字符编码环境,最可靠的做法是在jvm启动时通过设置系统属性 -dfile.encoding=utf-8 来强制指定默认字符集。这一配置会直接影响 string.getbytes()、filereader 以及servlet容器等底层i/o操作的默认行为,确保整个应用在处理文本数据时保持一致的utf-8标准,从而避免跨平台部署或不同模块间出现的乱码问题。
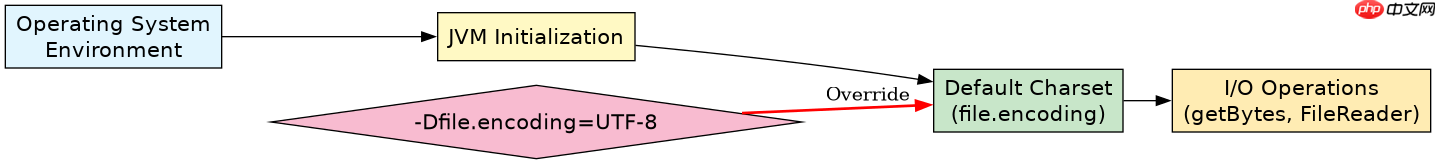
JVM如何决定默认字符集
JVM在初始化阶段会根据操作系统的环境变量和区域设置来确定默认的字符编码。如果未显式指定 -Dfile.encoding,Windows系统通常使用GBK或GB2312,而Linux/macOS系统多使用UTF-8。这种差异导致代码在开发机运行正常,但在生产服务器部署后出现乱码。通过启动参数覆盖这一默认值,可以消除环境差异带来的不确定性。
public class EncodingDemo {
    public static void main(String[] args) {
        // 获取当前JVM默认字符集
        String defaultCharset = System.getProperty("file.encoding");
        System.out.println("Default Charset: " + defaultCharset);

        // 测试字符串转换
        String text = "Hello 世界";
        byte[] bytes = text.getBytes(); // 使用默认编码
        String decoded = new String(bytes); // 使用默认解码

        System.out.println("Original: " + text);
        System.out.println("Decoded: " + decoded);
        System.out.println("Match: " + text.equals(decoded));
    }
}
上述程序在添加 -Dfile.encoding=UTF-8 启动参数后,输出将显示 Default Charset 为 UTF-8,且原始字符串与解码后的字符串完全匹配。若不加此参数且在GBK环境下运行,虽然中文也能正确回环,但与其他UTF-8系统的交互会产生乱码。该示例验证了系统属性对 getBytes() 无参版本的直接控制作用。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
IDE与构建工具的配置协同
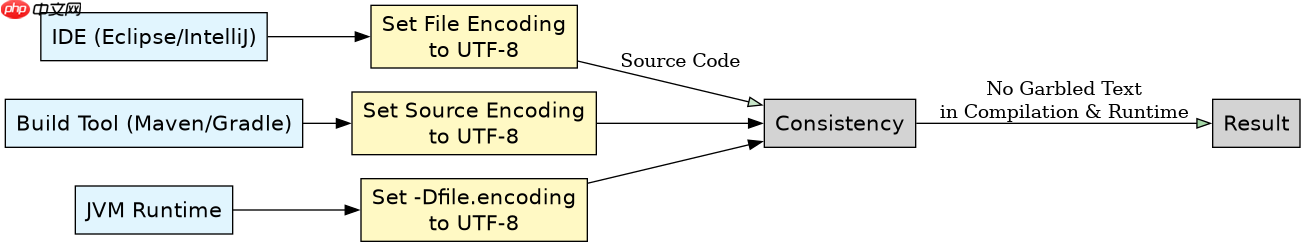
仅靠JVM启动参数不足以覆盖所有场景,IDE和构建工具(如Maven/Gradle)也需要配置以统一源码编译和测试时的编码。Eclipse和IntelliJ IDEA中需在项目属性和文件编辑器设置中指定UTF-8。Maven项目中可通过 pom.xml 配置 maven.compiler.source 和 maven.compiler.target 以及 project.build.sourceEncoding 来确保编译器使用UTF-8读取源文件并生成字节码。Gradle则在 build.gradle 中设置 tasks.withType(JavaCompile).options.encoding = 'UTF-8'。这些配置保证了从源码到编译输出的编码一致性,防止因IDE默认编码与JVM运行编码不一致导致的类加载异常或常量池乱码。
// Maven pom.xml 片段
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
</properties>
在Maven项目中,上述配置确保了 mvn compile 时使用UTF-8解析Java源文件。若源文件中包含非ASCII字符(如中文注释或字符串),缺少此配置可能导致编译错误或生成的class文件中字符损坏。结合JVM启动参数,形成了从编译到运行的完整编码闭环。
Servlet容器中的编码处理
在Web应用中,除了JVM全局配置,还需关注Servlet容器(如Tomcat)对HTTP请求和响应编码的处理。Tomcat的 server.xml 中Connector元素可设置 URIEncoding="UTF-8" 来处理URL查询参数中的中文。同时,在Servlet代码中应始终显式调用 request.setCharacterEncoding("UTF-8") 和 response.setCharacterEncoding("UTF-8"),并在设置内容类型时指定charset,如 response.setContentType("text/html;charset=UTF-8")。尽管JVM默认编码可能已设为UTF-8,但显式设置能确保在特定请求上下文中编码不被意外覆盖,特别是在过滤器链或第三方库介入时。对于Spring Boot应用,内置Tomcat通常自动处理大部分编码问题,但仍建议在 application.properties 中设置 spring.http.encoding.charset=UTF-8 以增强可控性。



















