








在 javascript 循环中处理索引越界,核心做法是确保访问数组元素前进行边界检查,或者使用 `for...of`、`foreach` 等不直接暴露索引的迭代方式。通过判断索引是否小于数组长度且大于等于零,可以有效避免读取到 undefined 或引发逻辑错误。对于需要精确控制边界的场景,结合 array.prototype.at() 方法或使用可选链操作符能提供更安全的访问路径。
传统 for 循环中如何安全访问元素
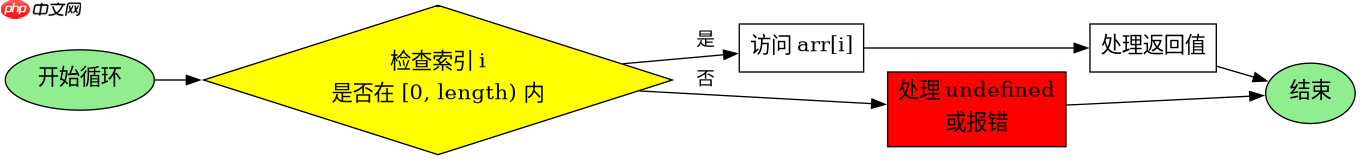
在使用基于索引的 for 循环时,必须显式检查索引范围。如果仅依赖数组长度作为上限,通常不会发生物理上的越界报错,但访问超出范围的索引会返回 undefined,这可能导致后续计算出错。因此,在循环体内访问 arr[i] 之前,应确认 i 的有效性。
const arr = [10, 20, 30];
// 安全访问示例
for (let i = 0; i < arr.length; i++) {
  const val = arr[i]; // 始终有效
  console.log(val);
}

// 潜在风险:手动调整索引
let index = 5;
if (index >= 0 && index < arr.length) {
  console.log(arr[index]); // 输出 undefined,但不报错
} else {
  console.log('Index out of bounds');
}
上述代码展示了两种情况。第一种是标准的遍历,索引 i 始终在合法范围内。第二种是手动指定索引 index 为 5,而数组长度仅为 3。此时直接访问 arr[5] 不会抛出异常,而是返回 undefined。如果在业务逻辑中期望得到数值,这种隐式的 undefined 可能会引发类型错误。因此,显式的边界判断 index >= 0 && index 是必要的防御性编程手段。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
现代迭代方法如何规避索引问题
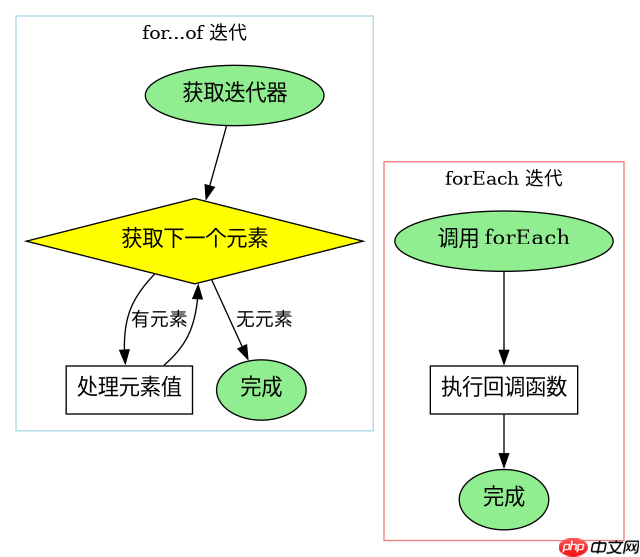
为了避免手动管理索引带来的越界风险,推荐使用 for...of 或 forEach 方法。这些方法由引擎内部处理迭代逻辑,开发者无需关心当前元素的索引位置,从而彻底消除了索引越界的可能性。它们直接操作元素值,适用于不需要索引的场景。
const arr = ['a', 'b', 'c'];

// 使用 for...of
for (const item of arr) {
  console.log(item); // 直接获取值,无索引概念
}

// 使用 forEach
arr.forEach((item, index) => {
  if (index >= 0 && index < arr.length) {
    console.log(index, item);
  }
});
在 for...of 循环中,变量 item 直接绑定到数组中的每个值,不存在索引访问的步骤,因此不可能出现越界。而在 forEach 中,虽然提供了索引参数 index,但回调函数仅在数组存在的元素上调用,引擎保证了传入的索引一定是合法的。这种方式简化了代码结构,减少了因索引计算错误导致的潜在 bug。
负数索引与 at() 方法的具体行为
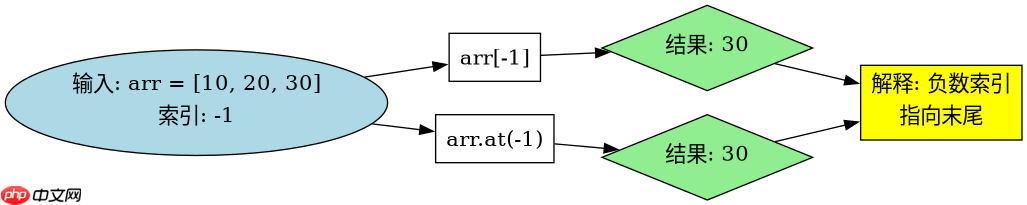
JavaScript 支持负数索引访问数组末尾的元素,这是 at() 方法相较于方括号访问的一个显著优势。当使用 arr[-1] 时,实际上是在访问最后一个元素,但这容易与“越界”混淆。而 at(-1) 明确表达了从末尾计数的意图,且在索引完全越界(如 -100)时同样返回 undefined,行为一致但语义更清晰。
const arr = [100, 200, 300];
console.log(arr[-1]);   // 300, 访问最后一个元素
console.log(arr.at(-1)); // 300, 同上
console.log(arr.at(10)); // undefined, 越界
console.log(arr[10]);    // undefined, 越界
这段代码验证了负数索引的行为。虽然 arr[-1] 能正常工作,但在某些严格模式下或与其他库交互时,负数键可能被视为对象属性而非数组索引。使用 at() 方法可以统一正负索引的处理逻辑,使代码意图更加明确。在处理动态生成的索引时,优先使用 at() 可以减少对数组长度计算的依赖,提高代码的健壮性。


















