








在sql server中监控触发器的调用次数与资源消耗,最直接且低开销的方法是利用扩展事件(extended events)捕获`sql_batch_completed`或`rpc_completed`事件,并通过过滤条件锁定特定触发器名称,从而统计执行频次并获取cpu、读取和持续时间等性能指标。具体做法是创建一个会话,订阅相关事件并添加目标收集器,查询系统视图即可得到聚合后的统计数据;若需实时查看单次调用的详细资源占用,可结合动态管理视图`sys.dm_exec_query_stats`进行关联分析。这种方法避免了使用传统sql profiler带来的高负载,同时能精准定位到具体的触发器逻辑。

如何配置扩展事件以捕获触发器执行频率?
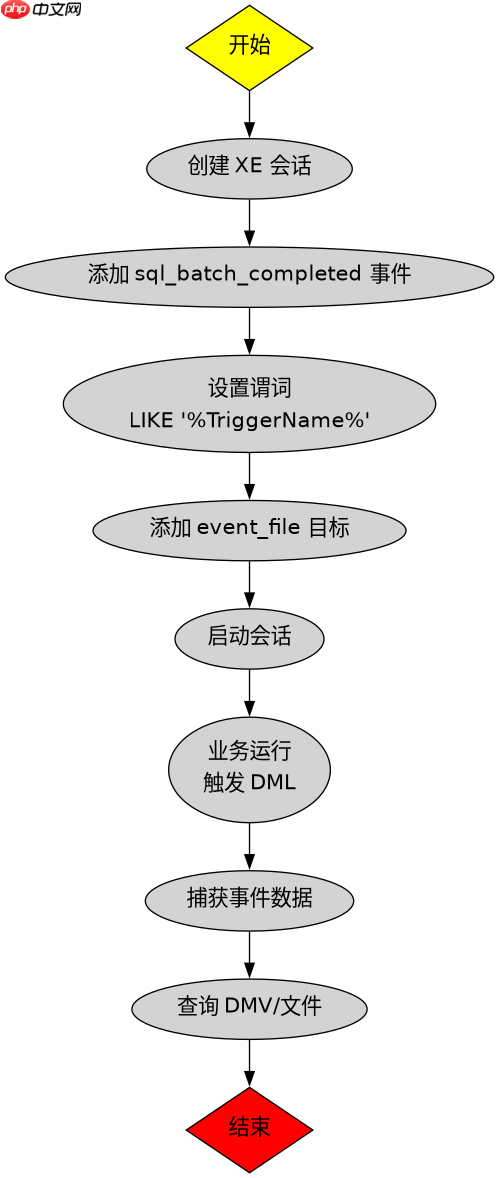
要统计触发器的调用次数,需要创建一个扩展事件会话,专门监听与触发器执行相关的底层事件。虽然触发器本身不直接产生独立的事件流,但它们作为批处理的一部分被执行,因此可以通过捕获`sql_batch_completed`事件并过滤出包含触发器名称的SQL文本,或者更精确地,利用`trigger:after_insert`、`trigger:after_update`等特定对象类事件(如果可用)来追踪。在实际操作中,最通用的方式是监听`sp_executesql`或常规SQL批处理,并在谓词中匹配触发器所属的模式或名称。通过设置`collect_statistics`选项,可以自动对捕获的数据进行聚合,从而直接获得调用计数。创建会话后,启动它并让业务运行一段时间,随后查询`sys.dm_xe_sessions`和`sys.dm_xe_session_targets`即可看到累积的调用次数。
-- 创建扩展事件会话以监控触发器调用
CREATE EVENT SESSION [MonitorTriggerCalls] ON SERVER
ADD EVENT sqlserver.sql_batch_completed(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE ([sqlserver].[like_i_sql_unicode_string]([sql_text],N'%YourTriggerName%'))
),
ADD EVENT sqlserver.rpc_completed(
    ACTION(sqlserver.sql_text,sqlserver.username)
    WHERE ([sqlserver].[like_i_sql_unicode_string]([sql_text],N'%YourTriggerName%'))
)
ADD TARGET package0.event_file(SET filename=N'C:\XEvents\TriggerCalls.xel')
WITH (MAX_MEMORY=4096 KB,EVENT_RETENTION_MODE=ALLOW_SINGLE_EVENT_LOSS);
GO

-- 启动会话
ALTER EVENT SESSION [MonitorTriggerCalls] ON SERVER STATE = START;
GO
上述代码定义了一个名为`MonitorTriggerCalls`的会话,它捕获SQL批处理和远程过程调用完成事件。关键部分在于`WHERE`子句,这里使用了`like_i_sql_unicode_string`谓词来模糊匹配触发器名称。你需要将`%YourTriggerName%`替换为实际要监控的触发器名。目标设置为`event_file`,将数据持久化到磁盘文件。启动会话后,数据库中的相关业务操作会被记录。要查看结果,可以使用`sys.fn_xe_file_target_read_file`函数读取这些XML文件,并对`event_data`中的`call_count`或类似聚合字段进行解析。如果希望实时查询内存中的数据,可以使用`sys.dm_xe_session_targets`视图,但需注意内存目标可能会因内存压力而轮转。
如何获取触发器执行时的具体资源消耗?
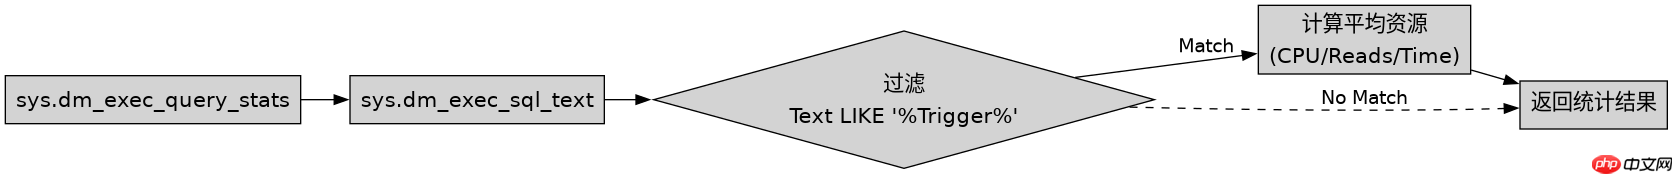
除了调用次数,了解每次触发器执行消耗的CPU时间、逻辑读取数和持续时间对于性能优化至关重要。这可以通过扩展事件的`data`字段获取,或者通过分析`sys.dm_exec_query_stats`动态管理视图来实现。当触发器被激活时,它会生成一个或多个子查询计划。在`sys.dm_exec_query_stats`中,每个计划都有对应的`total_worker_time`(CPU时间)、`total_logical_reads`和`total_elapsed_time`。为了将这些统计信息与特定触发器关联,需要检查`sys.dm_exec_sql_text`返回的文本,看是否包含触发器名称,或者更准确地,通过`sys.triggers`和`sys.objects`的关系,结合`sys.dm_exec_procedure_stats`(如果是存储过程触发的)或直接分析批处理文本。由于触发器是隐式执行的,它们通常共享父批处理的统计信息,因此精确分离触发器自身的资源消耗较为复杂。一种有效的方法是启用`STATISTICS IO`和`STATISTICS TIME`,并在触发器内部记录日志到自定义表中,但这会增加写入开销。对于非侵入式监控,扩展事件提供了`cpu_time`、`duration`和`read`等数据元素,可以直接从事件包中提取。
-- 查询最近执行的与触发器相关的计划统计
SELECT
    qs.execution_count,
    qs.total_worker_time / qs.execution_count AS avg_cpu_ms,
    qs.total_logical_reads / qs.execution_count AS avg_reads,
    qs.total_elapsed_time / qs.execution_count AS avg_duration_ms,
    st.text AS sql_text
FROM sys.dm_exec_query_stats qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) st
WHERE st.text LIKE '%YourTriggerName%'
ORDER BY qs.total_worker_time DESC;
GO
这段T-SQL脚本查询了`sys.dm_exec_query_stats`,筛选出SQL文本中包含目标触发器名称的记录。计算出的平均值反映了该触发器(或其所在的批处理片段)的平均资源消耗。需要注意的是,如果触发器只是批处理中的一小部分,这些统计值可能包含了其他语句的开销。为了更精确地隔离触发器,建议在触发器代码开头和结尾插入临时表记录,或使用扩展事件的`query_plan`动作来分析具体的执行计划树,识别出属于触发器逻辑的部分。此外,`sys.dm_exec_trigger_stats`视图(如果存在且适用)可以提供更直接的触发器级别统计,但在某些SQL Server版本中,触发器统计可能合并到过程统计中。因此,结合扩展事件的细粒度数据和DMV的聚合数据是最佳实践。
基于触发器执行失败时的错误处理机制是什么?
当触发器在执行过程中遇到错误(如约束违反、死锁或权限不足)时,其默认行为取决于事务的状态和错误的严重性。如果触发器是在显式事务中由用户代码激活的,且未使用`TRY...CATCH`块捕获错误,默认情况下,大多数运行时错误会导致触发器回滚,并将错误传播给调用者,进而导致发起调用的主事务也回滚。这意味着,如果触发器因为逻辑错误而失败,整个数据修改操作都会被撤销,保证了数据的一致性。然而,如果触发器内部使用了`TRY...CATCH`并调用了`RAISERROR`或`THROW`,可以根据需要选择回滚触发器内的更改而不影响主事务,或者强制回滚整个事务。此外,对于某些严重性较高的错误(如16级以上的错误),即使没有显式回滚,SQL Server也会自动中止当前批处理。理解这一机制对于设计健壮的触发器至关重要,特别是在处理外键约束或复杂业务规则时,应避免在触发器中使用可能导致不可控回滚的操作,或者明确记录错误以便后续审计。

















