








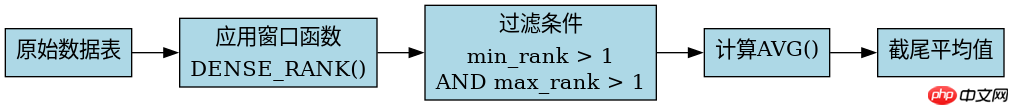
在sql聚合查询中排除最大值与最小值后求平均,最稳健的做法是使用窗口函数 rank() 或 dense_rank() 为每行数据打上排名标签,然后在子查询中过滤掉排名为1的记录,最后对剩余数据进行 avg() 聚合。这种方法能正确处理并列极值的情况,避免误删有效数据。
如何处理并列的最大值或最小值
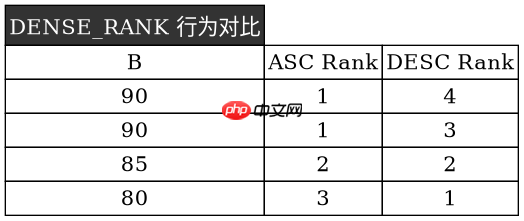
当数据中存在多个相同的最大值或最小值时,使用 RANK() 会跳过后续排名,而 DENSE_RANK() 则保持连续。如果业务逻辑要求只要等于极值就剔除,无论出现多少次,应使用 DENSE_RANK() 并筛选排名大于1的行;若只需剔除一个实例(极少见),才考虑 RANK()。通常推荐前者以确保统计的公平性。
SELECT category, AVG(value) as trimmed_avg
FROM (
    SELECT
        category,
        value,
        DENSE_RANK() OVER (PARTITION BY category ORDER BY value ASC) as min_rank,
        DENSE_RANK() OVER (PARTITION BY category ORDER BY value DESC) as max_rank
    FROM scores
) ranked
WHERE min_rank > 1 AND max_rank > 1;
空值与单值数据的边界情况处理
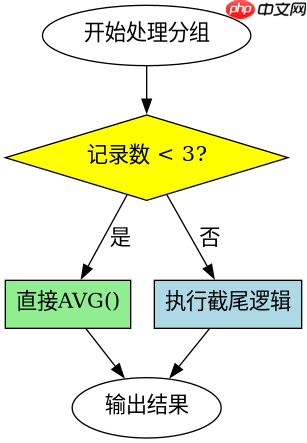
上述查询在处理单条记录或全为空值的数据时,会返回NULL或无结果,因为所有记录都被过滤掉了。若需保留至少一个平均值,可结合 COUNT() 判断:当组内记录数小于3时直接取普通平均值,否则执行截尾平均。这避免了因极端值剔除导致样本量不足的问题。
SELECT
    category,
    CASE
        WHEN COUNT(value) < 3 THEN AVG(value)
        ELSE AVG(CASE
            WHEN DENSE_RANK() OVER (PARTITION BY category ORDER BY value ASC) = 1
             OR DENSE_RANK() OVER (PARTITION BY category ORDER BY value DESC) = 1
            THEN NULL
            ELSE value
        END)
    END as final_avg
FROM scores
GROUP BY category;


















