








++ 和 -- 在赋值语句中如何避免混淆
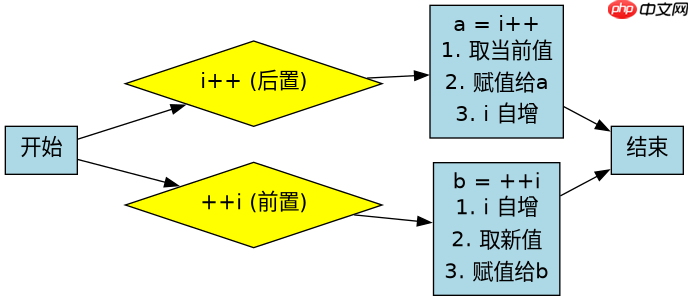
使用自增自减运算符时,最稳妥的做法是彻底放弃在复杂表达式或赋值语句中使用后置形式,统一改为前置形式或将运算拆分为独立的赋值步骤。后置运算符(如 i++)会先返回变量当前的值,然后再修改变量,这会导致赋值操作拿到的是旧值而非新值,极易引发逻辑错误;而前置运算符(如 ++i)则先修改变量再返回值,行为更符合直觉。通过强制规范代码风格,可以消除因求值顺序带来的歧义。
let i = 0;
// 危险写法:结果取决于语言规范,容易混淆
let a = i++;
// 安全写法:明确先加后取
let b = ++i;
console.log(a, b); // 输出: 0 2
上述代码展示了两种写法的实际差异。在 a = i++ 中,a 被赋值为 0,随后 i 变为 1。而在 b = ++i 中,i 先变为 2,然后 b 被赋值为 2。这种差异在简单的计数器循环中可能不明显,但在涉及数组索引或状态更新的复杂逻辑中会导致严重的 Bug。
在数组遍历或条件判断中如何处理自增
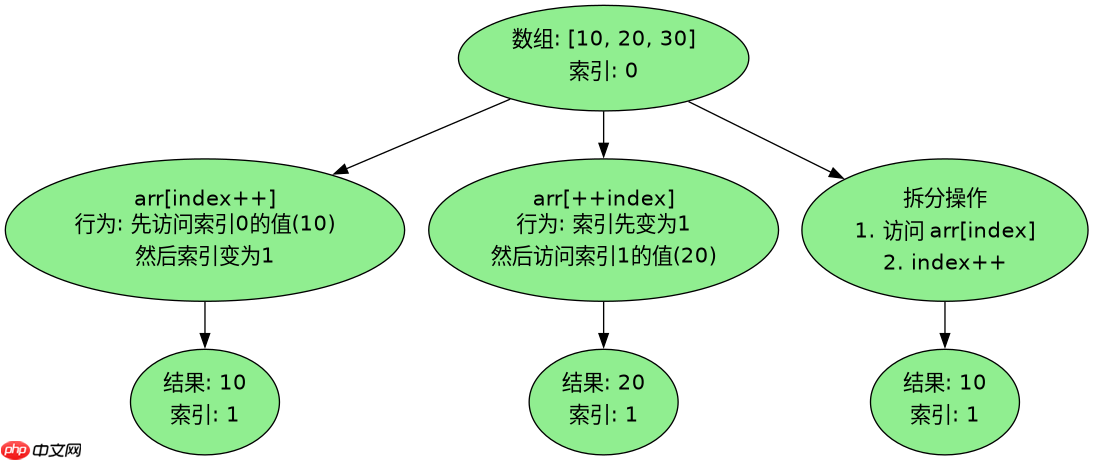
在 for 循环的更新部分或条件判断中,应优先使用前置自增以确保状态同步,或者将自增操作移出表达式单独成行。当自增运算符出现在条件判断中时,其返回值会被用于判断真假,这往往掩盖了真实的业务意图。例如,在检查数组边界时,使用 arr[++index] 会比 arr[index++] 更清晰地表达“先移动指针再访问”的意图,从而避免越界或跳过元素的问题。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
立即学习“Java免费学习笔记(深入)”;
const arr = [10, 20, 30];
let index = 0;
// 常见陷阱:先取值再递增,可能导致处理重复或遗漏
console.log(arr[index++]); // 输出: 10, index 变为 1
// 推荐做法:显式分离操作
console.log(arr[index]);   // 输出: 10
index++;                   // 明确递增
这段代码演示了在数组访问场景下的最佳实践。虽然 arr[index++] 在语法上是合法的,但它隐含了“先使用后修改”的逻辑,这在某些算法中可能导致对同一元素的重复处理或对下一个元素的跳过。通过将 index++ 拆分为单独的语句,代码的可读性和可维护性显著提高,且完全消除了任何关于执行顺序的猜测。
基于具体输入验证自增运算符的实际副作用
针对具体的输入场景,验证自增运算符的副作用可以发现其在对象属性更新中的特殊表现。当自增运算符作用于对象的属性时,它不仅改变数值,还会确保该属性存在于对象上。这种行为在某些动态数据结构构建中非常有用,但也可能意外地污染对象命名空间。通过观察不同输入下的对象状态,可以确认自增运算符是否产生了预期的副作用。
let obj = { count: 0 };
// 验证自增对对象属性的影响
obj.count++;
console.log(obj.count); // 输出: 1
console.log(typeof obj.count); // 输出: number

// 验证未定义属性的自增
let newObj = {};
newObj.missing++;
console.log(newObj.missing); // 输出: NaN
console.log(typeof newObj.missing); // 输出: number运行上述代码可以清晰看到,对于已存在的数字属性,++ 按预期工作。但对于未定义的属性,JavaScript 会将其视为 undefined,进行自增操作后得到 NaN,并且该属性会被添加到对象中。这一行为证实了自增运算符不仅是一个数学操作,还是一个具有副作用的属性初始化过程。开发者在处理此类逻辑时,必须预先检查属性是否存在,以避免意外的 NaN 值传播到后续计算中。


















