








在sql中借助join避免大范围between引发的全表扫描,核心做法是将范围查询转化为等值连接(eq join),利用索引进行精确匹配。具体而言,若需查找某范围内的记录,可先通过子查询或cte获取该范围内所有可能的键值(如离散的时间戳、id列表),再将这些键值作为临时表与主表进行inner join。这样做能强制优化器使用索引查找(index seek)而非范围扫描(range scan),从而显著减少i/o开销。前提是范围对应的列具备高基数且存在合适索引;若范围极宽导致临时表过大,则此法可能适得其反。
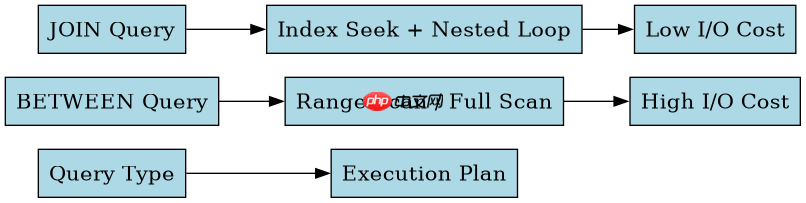
为什么BETWEEN会导致全表扫描
BETWEEN操作在缺乏合适索引或范围过宽时,会触发全表扫描或低效的范围扫描。当数据库无法有效利用B-Tree索引定位起始和结束点之间的所有行时,它会逐行检查条件,导致性能急剧下降。此外,如果范围覆盖了表中大部分数据,优化器可能认为全表扫描比随机I/O更高效,但这通常不是我们想要的结果。
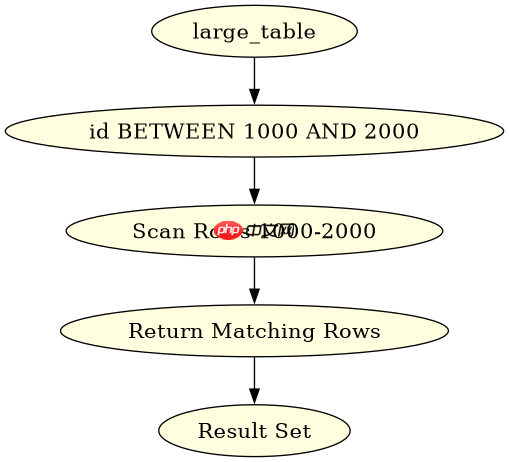
SELECT * FROM large_table WHERE id BETWEEN 1000 AND 2000;
预期结果:执行计划显示为Table Scan或Full Index Scan,扫描行数接近1000行。
如何用JOIN替代BETWEEN
通过将范围查询转化为JOIN,可以迫使数据库使用索引查找。具体做法是创建一个包含目标范围内所有键值的临时表或派生表,然后与主表进行INNER JOIN。这种方法特别适用于范围由离散值组成且这些值可以通过某种方式高效生成的场景。例如,如果我们要查找ID在特定范围内的记录,可以先提取这些ID,再JOIN回原表。
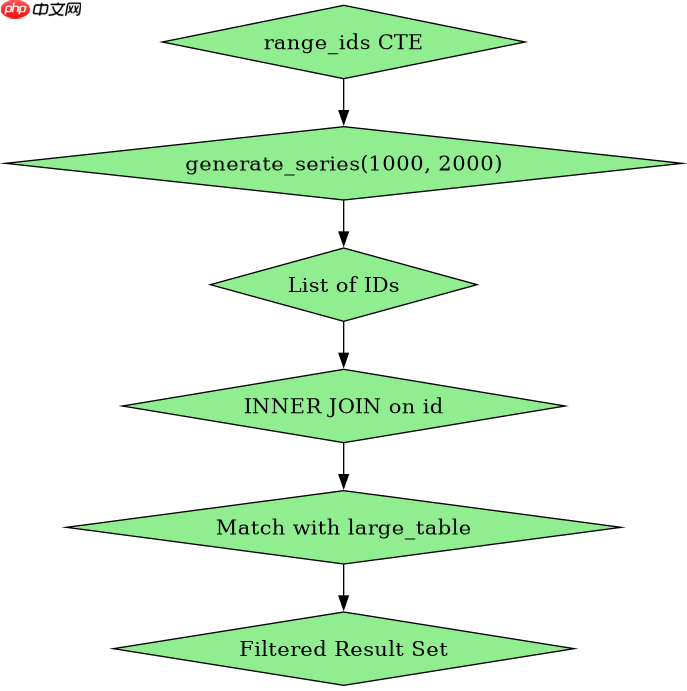
WITH range_ids AS ( SELECT id FROM generate_series(1000, 2000) AS id ) SELECT lt.* FROM large_table lt INNER JOIN range_ids ri ON lt.id = ri.id;
预期结果:执行计划显示为Nested Loop Join,内部循环使用Index Seek,仅访问匹配的1000行。
基于程序中某个输入、条件或结果的具体问题
当范围极大(如100万行)时,生成临时表的成本可能超过直接扫描的收益。此时,应评估范围大小与表总行数的比例。若范围占比过高,建议保留BETWEEN并依赖覆盖索引;若范围较小且离散,JOIN方案更优。可通过EXPLAIN分析执行计划,对比两种方案的cost值,选择实际更高效的写法。

















