








在sql中利用lag和lead实现用户会话切分,核心思路是通过比较当前记录与相邻记录的`timestamp`差值是否超过预设阈值(如30分钟),标记出会话断点。具体做法是:使用`lag(timestamp)`获取上一行时间,计算差值;若差值大于阈值或为null,则标记为新会话开始;最后通过对该标记列进行累积求和(sum over)生成唯一的`session_id`。

如何识别会话断点并标记新会话
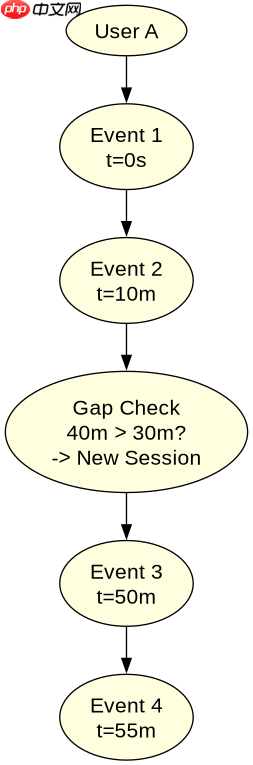
要识别会话断点,需先按用户ID和时间排序,然后使用窗口函数LAG获取前一行的时间戳。将当前行时间戳与前一行时间戳相减,如果差值超过设定的阈值(例如30分钟)或者当前行是第一行(LAG返回NULL),则判定为新的会话开始。此时可以将该条件转化为一个布尔值或整数标记(1表示新会话,0表示同一会话内)。
-- 假设表名为 user_events,包含 user_id, event_time
-- 步骤1: 获取前一行时间并计算差值
WITH step1 AS (
    SELECT
        user_id,
        event_time,
        LAG(event_time) OVER (PARTITION BY user_id ORDER BY event_time) as prev_event_time
    FROM user_events
),
-- 步骤2: 判断是否为新会话
step2 AS (
    SELECT
        user_id,
        event_time,
        prev_event_time,
        CASE
            WHEN prev_event_time IS NULL THEN 1
            WHEN EXTRACT(EPOCH FROM (event_time - prev_event_time)) > 1800 THEN 1 -- 30分钟 = 1800秒
            ELSE 0
        END as is_new_session
    FROM step1
)
上述代码首先通过`LAG`获取前一条记录的时间,然后在`step2`中通过`CASE`语句判断间隔是否超过1800秒。如果超过或为空,`is_new_session`标记为1,否则为0。这一步是会话切分的基础,准确标记了每个会话的起始点。

将测试、lint、构建和文档流程编码为命名的Python会话,以便人类和代理每次运行相同的workflow。
如何基于断点标记生成唯一Session ID
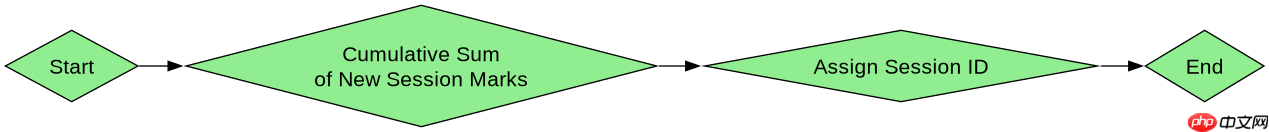
一旦有了标记新会话开始的标志位,下一步就是为每个连续的会话分配一个唯一的ID。这可以通过对`is_new_session`列进行累积求和来实现。由于新会话开始时标记为1,后续同一会话内的标记为0,因此累积求和的结果会在每个新会话开始时递增1,从而形成唯一的会话标识。
-- 步骤3: 累积求和生成 Session ID
SELECT
    user_id,
    event_time,
    SUM(is_new_session) OVER (PARTITION BY user_id ORDER BY event_time) as session_id
FROM step2;
最终查询通过对`step2`的结果应用`SUM(...) OVER (...)`窗口函数,按用户分区并按时间排序进行累积求和。这样,每个用户的第一个事件产生session_id=1,直到遇到下一个新会话标记,session_id变为2,依此类推。这种方法高效且无需自连接,能够正确处理大规模数据中的会话切分问题。
当用户连续操作间隔恰好等于阈值时如何处理
当用户连续操作的间隔恰好等于预设阈值(如30分钟)时,根据上述逻辑,条件`EXTRACT(EPOCH FROM (event_time - prev_event_time)) > 1800`将不成立(因为等于1800不大于1800),因此不会标记为新会话,而是视为同一会话内的连续操作。如果需要将等于阈值的情况也视为新会话,应将条件改为`>= 1800`。这种边界条件的处理直接影响会话的粒度,开发者应根据业务需求明确界定“超时”的定义。


















