








使用 max() over (partition by ...) 窗口函数可以直接在保留原始行数据的同时获取分组最大值,无需自连接或子查询。具体做法是在 select 列表中定义该窗口函数,指定按目标列分区并按值排序(通常不需要显式排序即可计算聚合),这样每行都会附带其所属组的最大数值。

如何过滤出仅包含最大值的那些行?
窗口函数会在所有行上生成结果,若只需保留最大值对应的记录,需在外层包裹一层查询并添加 WHERE 条件进行过滤。通过比较原始列与生成的最大值列,可以精准筛选出符合要求的行,同时保持查询逻辑清晰且易于维护。
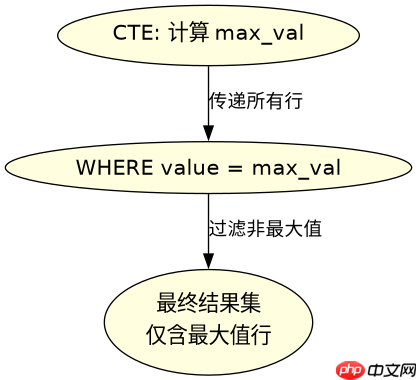
WITH RankedData AS (
    SELECT
        category,
        value,
        MAX(value) OVER (PARTITION BY category) as max_val
    FROM sales_data
)
SELECT category, value
FROM RankedData
WHERE value = max_val;
如何处理并列最大值的情况?
当同一组内存在多个相同的最大值时,上述基于 = 的比较会返回所有匹配的行。如果业务逻辑要求只取其中一条(例如按时间最新的一条),则需要引入 RANK() 或 DENSE_RANK() 配合 ORDER BY 子句来打破平局,确保结果的确定性。
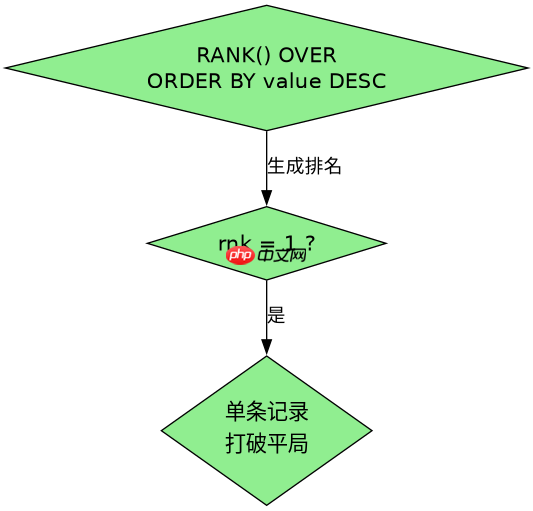
WITH RankedData AS (
    SELECT
        category,
        value,
        RANK() OVER (PARTITION BY category ORDER BY value DESC) as rnk
    FROM sales_data
)
SELECT category, value
FROM RankedData
WHERE rnk = 1;
基于输入数据中category为'A'的具体查询结果是什么?
针对输入数据中 category 为 'A' 的记录,程序将首先计算该组内的最大值。假设 'A' 组的数据值为 10, 20, 20, 5,则最大值列为 20。随后的过滤步骤会保留所有值为 20 的行,即返回两行结果,分别对应原始数据中的两个 20。这验证了该方法能正确处理并列最大值并返回所有相关记录的特性。


















