








javascript 中浅拷贝和深拷贝的内存管理核心区别在于是否复制引用。浅拷贝只复制对象的第一层属性,嵌套对象仍共享同一内存地址,修改嵌套内容会影响原对象;深拷贝则递归复制所有层级,为新对象分配全新内存空间,与原对象完全隔离。实现上,浅拷贝可用 object.assign() 或展开运算符 {...obj},而深拷贝需通过递归函数、结构化克隆 structuredclone() 或第三方库如 lodash 的 _.clonedeep() 来完成。
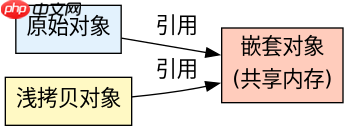
浅拷贝如何影响原始数据的内存引用
浅拷贝仅复制对象顶层属性的值,对于基本类型(如字符串、数字)会创建新副本,但对于引用类型(如数组、对象),它只复制指向该对象的指针。这意味着新旧对象在嵌套层级上共享同一块堆内存。例如,使用展开运算符 {...original} 创建一个新对象后,如果修改新对象中的嵌套对象属性,原始对象也会随之改变,因为它们指向同一个内存地址。这种机制节省内存但可能导致意外的数据污染,适用于只需要扁平化结构或明确知道不会修改嵌套数据的场景。
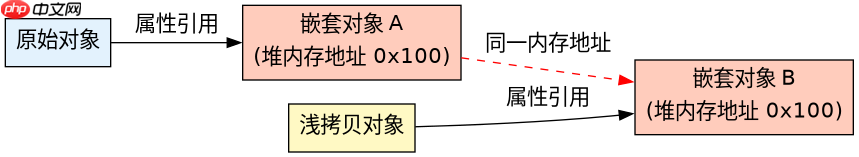
const original = { a: 1, nested: { b: 2 } }; const shallowCopy = { ...original }; console.log(original.nested === shallowCopy.nested); // true, 共享内存 shallowCopy.nested.b = 99; console.log(original.nested.b); // 99, 原对象被修改深拷贝如何实现内存完全隔离
深拷贝通过递归遍历对象的所有属性,为每一层嵌套对象分配新的内存空间,从而切断与原对象的所有引用联系。这样生成的新对象是独立的,任何修改都不会波及原始数据。现代浏览器支持 structuredClone() API,它能自动处理循环引用和复杂类型,是最推荐的深拷贝方式。对于不支持的环境,可以编写递归函数或使用 JSON 序列化(注意:JSON 方法无法处理函数、undefined 和循环引用)。深拷贝消耗更多内存和时间,适合需要严格数据隔离的场景,如状态管理中的不可变更新。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
立即学习“Java免费学习笔记(深入)”;
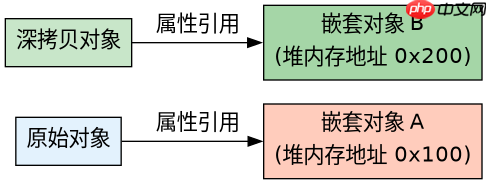
const original = { a: 1, nested: { b: 2 } }; const deepCopy = structuredClone(original); console.log(original.nested === deepCopy.nested); // false, 独立内存 deepCopy.nested.b = 99; console.log(original.nested.b); // 2, 原对象不受影响当嵌套对象包含循环引用时深拷贝会怎样
如果对象存在循环引用,即某个属性直接或间接引用了自身,标准的递归深拷贝会陷入无限递归导致栈溢出。此时需要使用特殊策略来检测已访问的对象并建立映射表,避免重复处理。现代 structuredClone() API 内置了对循环引用的支持,能正确克隆此类结构而不报错。若手动实现,需维护一个 WeakMap 记录已克隆的对象,遇到循环时直接返回缓存的副本。这确保了内存管理的完整性,防止程序崩溃,同时保持数据结构的逻辑一致性。

















