








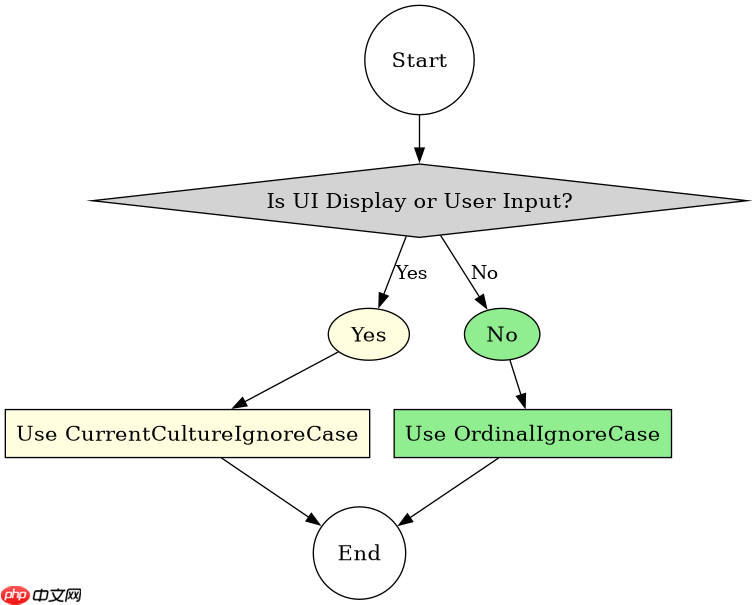
在c#中比较字符串是否忽略大小写,应优先选择stringcomparison.ordinalignorecase。它基于unicode码位进行逐字符比较,速度快且结果确定,适合大多数业务逻辑和键值匹配场景;而currentcultureignorecase受当前系统区域设置影响,性能较差且可能因语言规则(如土耳其语)产生意外结果,仅在需要符合特定用户本地化习惯的ui展示或排序时才使用。
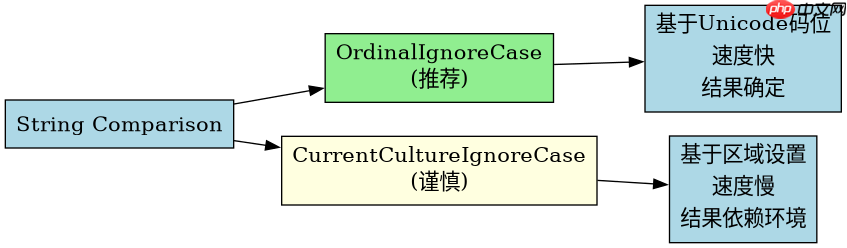
为什么OrdinalIgnoreCase比CurrentCultureIgnoreCase更快更稳定?
因为OrdinalIgnoreCase直接比较字符的UTF-16编码值,不涉及任何语言特定的映射表或区域设置上下文。相比之下,CurrentCultureIgnoreCase会查询当前线程的CultureInfo,执行复杂的字符规范化过程,这在循环或高频调用中会成为性能瓶颈。此外,某些文化(如土耳其语)对'I'和'i'的处理特殊,可能导致CurrentCultureIgnoreCase在不同机器上返回不同结果,破坏程序的一致性。

using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        string s1 = "Hello";
        string s2 = "hello";

        // 推荐做法:快速、确定
        bool result1 = string.Equals(s1, s2, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine($"OrdinalIgnoreCase: {result1}"); // True

        // 不推荐做法:慢、依赖环境
        bool result2 = string.Equals(s1, s2, StringComparison.CurrentCultureIgnoreCase);
        Console.WriteLine($"CurrentCultureIgnoreCase: {result2}"); // True (通常)

        // 验证性能差异示例
        var sw = System.Diagnostics.Stopwatch.StartNew();
        for (int i = 0; i < 1000000; i++)
        {
            string.Equals("Test", "TEST", StringComparison.OrdinalIgnoreCase);
        }
        sw.Stop();
        Console.WriteLine($"OrdinalIgnoreCase耗时: {sw.ElapsedMilliseconds}ms");

        sw.Restart();
        for (int i = 0; i < 1000000; i++)
        {
            string.Equals("Test", "TEST", StringComparison.CurrentCultureIgnoreCase);
        }
        sw.Stop();
        Console.WriteLine($"CurrentCultureIgnoreCase耗时: {sw.ElapsedMilliseconds}ms");
    }
}
什么情况下必须使用CurrentCultureIgnoreCase?
只有当你的应用面向非英语用户,且需要严格遵循该语言的大小写折叠规则时,才应考虑CurrentCultureIgnoreCase。例如,在德语中“ß”的小写形式是“ss”,在某些文化下大写转换可能涉及多字符映射。如果用于数据库查询、API密钥验证或内部数据结构键匹配,绝对不要使用它,因为它会导致跨平台行为不一致。对于绝大多数开发者而言,坚持使用OrdinalIgnoreCase是更安全的选择。
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        // 模拟土耳其语环境下的差异
        CultureInfo tr = new CultureInfo("tr-TR");
        CultureInfo en = new CultureInfo("en-US");

        string upperI = "I";
        string lowerI = "i";

        // 在土耳其语文化中,'I'.ToLower() 变成 'ı' (无点i),而不是 'i'
        // 因此 CurrentCultureIgnoreCase 在 tr-TR 下可能认为 I 和 i 不相等
        // 或者在某些比较逻辑中表现异常

        bool trResult = string.Equals(upperI, lowerI, StringComparison.CurrentCultureIgnoreCase);
        Console.WriteLine($"Turkish Culture Result: {trResult}"); // False in some contexts due to case mapping rules

        bool enResult = string.Equals(upperI, lowerI, StringComparison.Ordinal);
        Console.WriteLine($"English/Ordinal Result: {enResult}"); // False

        // 最佳实践:始终显式指定 OrdinalIgnoreCase
        bool safeResult = string.Equals(upperI, lowerI, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine($"Safe OrdinalIgnoreCase Result: {safeResult}"); // True
    }
}
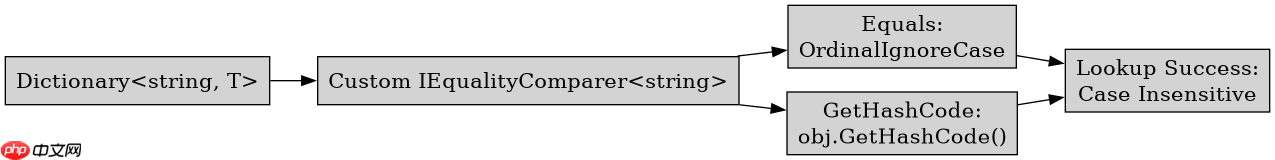
在Dictionary查找中使用OrdinalIgnoreCase作为键的策略是什么?
由于标准Dictionary<string t></string>默认使用GetHashCode和Equals,而这两者都区分大小写,因此不能直接传入StringComparison.OrdinalIgnoreCase。你需要创建一个自定义的IEqualityComparer<string></string>实现类,在其中重写Equals和GetHashCode方法,分别调用string.Equals(..., StringComparison.OrdinalIgnoreCase)和string.GetHashCode()(注意哈希码计算也需考虑大小写一致性,通常直接使用原始字符串的哈希码即可,因为相等性判断已处理)。然后实例化字典时传入这个比较器。
using System;
using System.Collections.Generic;

class CaseInsensitiveComparer : IEqualityComparer<string>
{
    public bool Equals(string x, string y)
    {
        if (x == null && y == null) return true;
        if (x == null || y == null) return false;
        return string.Equals(x, y, StringComparison.OrdinalIgnoreCase);
    }

    public int GetHashCode(string obj)
    {
        if (obj == null) return 0;
        // 使用原始字符串的哈希码,因为Equals已经处理了大小写
        // 为了更严格的规范,可以统一转为小写后计算哈希,但性能略低
        return obj.GetHashCode();
    }
}

class Program
{
    static void Main()
    {
        var dict = new Dictionary<string, string>(new CaseInsensitiveComparer());
        dict["Key"] = "Value";

        // 这样查找成功
        string val = dict["key"];
        Console.WriteLine(val); // Value

        // 这样也成功
        val = dict["KEY"];
        Console.WriteLine(val); // Value
    }
} 
















