








在sql中通过group by与pivot结合生成报表,核心做法是先使用子查询或cte进行基础聚合(如sum、count),再对聚合结果应用pivot运算符将行转列。这样做可以直接得到以特定维度为列的宽表格式,无需在应用层处理数据透视逻辑。若数据库不支持pivot关键字(如mysql),则需使用case when配合group by实现等效的行转列操作。

如何使用PIVOT关键字进行行转列
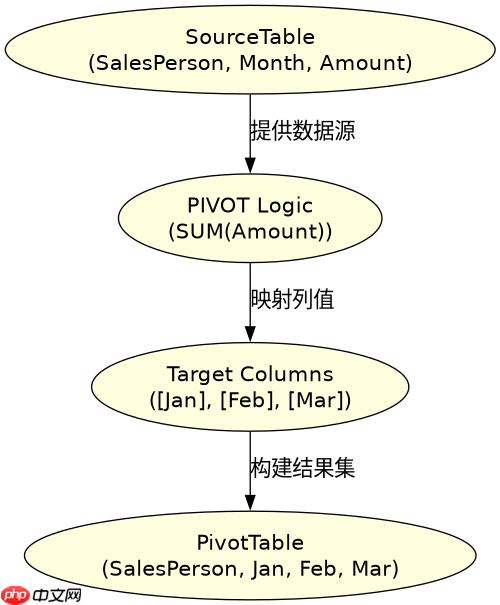
对于支持PIVOT语法的数据库(如SQL Server、Oracle),可以直接使用PIVOT函数。该函数需要指定聚合函数、目标列值以及要转换的源列。例如,将销售记录按月份汇总销售额,只需定义PIVOT后的列名即可自动生成对应的列。
SELECT * FROM
(
    SELECT SalesPerson, Month, Amount
    FROM SalesData
) AS SourceTable
PIVOT
(
    SUM(Amount)
    FOR Month IN ([January], [February], [March])
) AS PivotTable;
上述代码首先从SalesData表中选取人员、月份和金额。接着,PIVOT部分对Amount进行求和,并将Month列中的'January'、'February'、'March'转换为独立的列。最终结果集将包含SalesPerson以及这三个月份的销售额列。如果某人在某月无销售记录,对应单元格将为NULL。
如何使用CASE WHEN模拟PIVOT效果
在不支持PIVOT关键字的数据库(如MySQL、PostgreSQL)中,可以使用条件聚合来实现相同的效果。这种方法利用CASE表达式在GROUP BY阶段动态生成列,本质上是将行转列的逻辑嵌入到聚合过程中。这种方式兼容性更好,但语法相对冗长。

SELECT
    SalesPerson,
    SUM(CASE WHEN Month = 'January' THEN Amount END) AS January,
    SUM(CASE WHEN Month = 'February' THEN Amount END) AS February,
    SUM(CASE WHEN Month = 'March' THEN Amount END) AS March
FROM SalesData
GROUP BY SalesPerson;
这段代码遍历SalesData表,针对每个SalesPerson分组。在每组内,CASE WHEN语句检查Month字段,如果匹配特定月份则返回Amount,否则返回NULL。外层的SUM函数忽略NULL值并累加有效金额。最终输出结构与使用PIVOT关键字的结果一致,包含销售人员姓名及各月的销售额列。
如何处理PIVOT后的空值填充
在使用PIVOT或CASE WHEN生成的报表中,缺失的数据通常显示为NULL。为了提升报表的可读性,通常需要在最外层包裹一层COALESCE或ISNULL函数,将NULL替换为0或其他默认值。这一步骤不改变底层聚合逻辑,仅影响最终展示格式。
SELECT
    SalesPerson,
    COALESCE(January, 0) AS January,
    COALESCE(Feburary, 0) AS Feburary,
    COALESCE(March, 0) AS March
FROM
(
    SELECT SalesPerson,
           SUM(CASE WHEN Month = 'January' THEN Amount END) AS January,
           SUM(CASE WHEN Month = 'February' THEN Amount END) AS Feburary,
           SUM(CASE WHEN Month = 'March' THEN Amount END) AS March
    FROM SalesData
    GROUP BY SalesPerson
) AS SubQuery;
此查询在之前的CASE WHEN基础上增加了COALESCE处理。它检查每一列的值,如果为NULL则返回0。这样生成的报表中,所有单元格都有数值,便于后续的计算或可视化展示。这种嵌套写法确保了即使原始数据存在大量空缺,报表依然保持结构完整且易于阅读。


















