








php中文字符串截取出现乱码是因为utf-8编码的中文字符由多个字节组成,使用基于字节的函数(如`substr`)截断会导致字符不完整。解决该问题的核心方法是使用支持多字节字符的函数,例如`mb_substr`或`iconv_substr`,并明确指定utf-8编码参数。
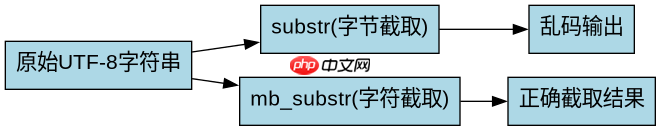
为什么substr会破坏UTF-8字符串
`substr`函数按字节数截取,而UTF-8中文通常占3个字节。若截断位置落在中间字节,后续解码器无法识别非法字节序列,从而输出乱码或替换字符。
$str = "你好世界";
echo substr($str, 0, 4); // 输出: 浣犱
上述代码中,“你”字占3个字节,第4个字节是“好”字的起始字节的一部分,导致截断错误。正确做法是使用`mb_substr`:
立即学习“PHP免费学习笔记(深入)”;

Build MCP servers and clients for PHP applications with the official PHP SDK
下载
使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
$str = "你好世界";
echo mb_substr($str, 0, 2, 'UTF-8'); // 输出: 你好
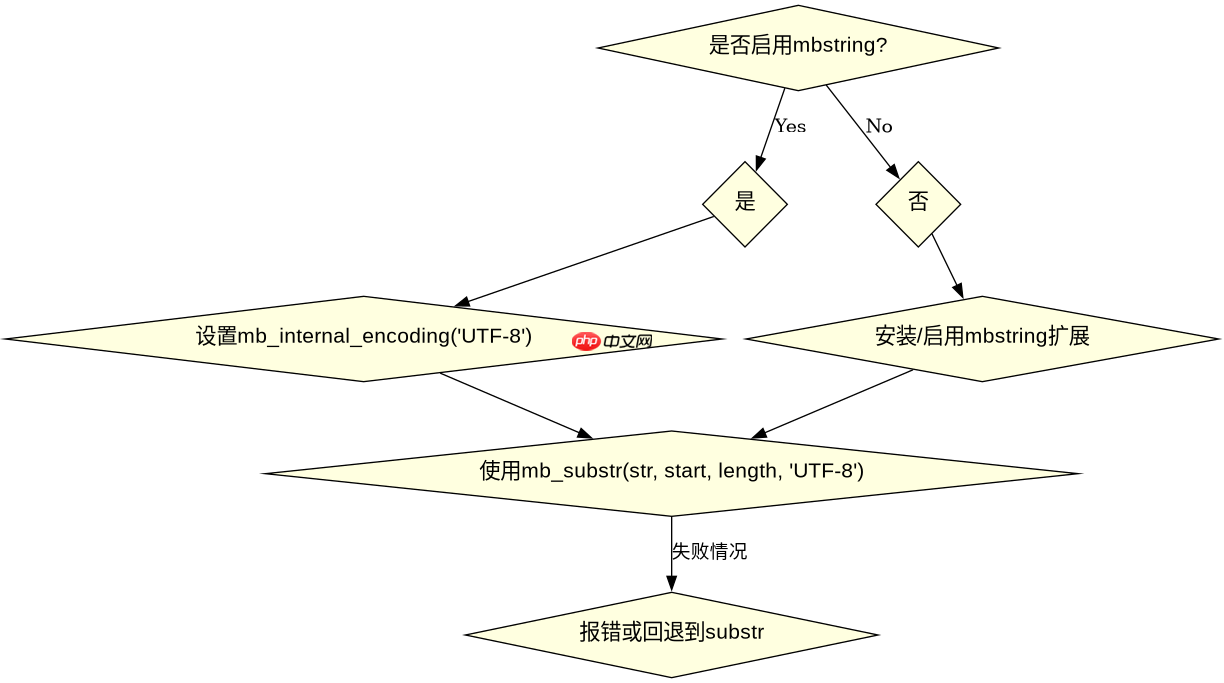
如何确保mb_substr正确工作
使用`mb_substr`前需确认PHP已启用`mbstring`扩展,并通过`mb_internal_encoding`或第三个参数指定编码为`UTF-8`。若未指定编码,可能沿用默认编码导致意外结果。

mb_internal_encoding('UTF-8');
$str = "你好世界";
echo mb_substr($str, 0, 2); // 输出: 你好
此外,可检查`mb_detect_encoding`验证输入编码,避免编码不一致问题。若处理混合内容,建议统一转换为UTF-8后再截取。
当字符串包含HTML标签时如何安全截取
若截取对象含HTML标签,直接截取可能破坏标签结构。此时应先剥离标签或使用`strip_tags`预处理,再应用`mb_substr`,确保截取后文本完整且无乱码。



















