








java jdbc 处理联合查询(union query)的核心做法是编写包含 union 或 union all 关键字的标准 sql 语句,并通过 preparedstatement 执行后使用 resultset 遍历结果。由于联合查询会将多个 select 的结果纵向合并,返回的列数必须一致且类型兼容,jdbc 驱动会自动将这些行视为一个统一的逻辑表,开发者只需按列索引或别名获取数据即可。
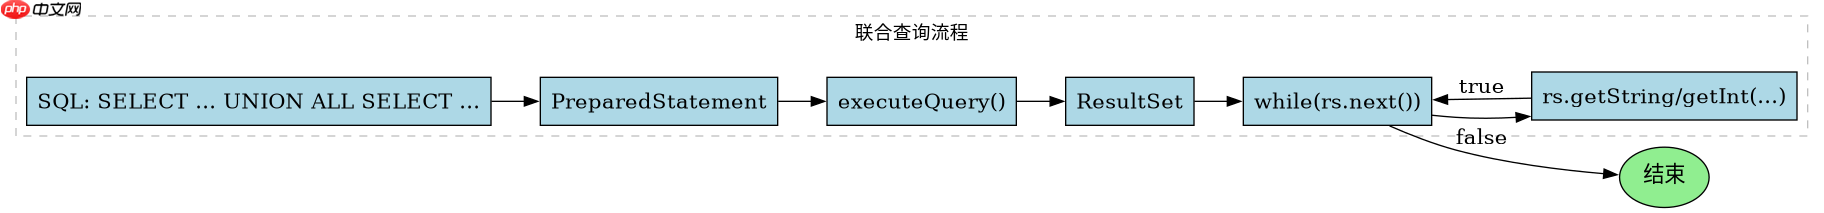
如何编写支持参数化的 Union SQL 并防止注入
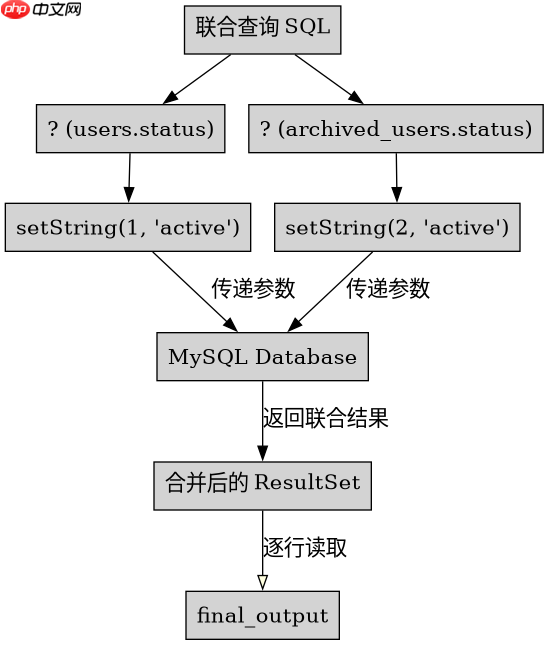
在 Java 中实现联合查询时,应始终使用 PreparedStatement 来替代字符串拼接,以确保 SQL 安全。通过设置占位符 ?,可以动态传入不同子查询的条件参数,例如根据用户 ID 或时间范围过滤数据。这种方式不仅避免了 SQL 注入风险,还能让数据库利用预编译缓存提升性能。需要注意的是,虽然参数化能保护输入值,但表名或排序字段等结构部分仍需通过应用层校验后拼接,不能直接作为参数传入。
import java.sql.*;

public class UnionQueryExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // 定义联合查询 SQL,两个子查询结构必须一致
        String sql = "SELECT id, name, status FROM users WHERE status = ? " +
                     "UNION ALL " +
                     "SELECT id, name, status FROM archived_users WHERE status = ?";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            // 设置参数:第一个问号对应 users 表,第二个对应 archived_users 表
            pstmt.setString(1, "active");
            pstmt.setString(2, "active");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    int id = rs.getInt("id");
                    String name = rs.getString("name");
                    String status = rs.getString("status");
                    System.out.println("ID: " + id + ", Name: " + name + ", Status: " + status);
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了如何通过 setString 为两个子查询分别绑定参数。执行后,ResultSet 会按顺序返回所有匹配的行,包括来自 users 和 archived_users 表的数据。若使用 UNION 而非 UNION ALL,数据库会在内部自动去重,但会增加排序和比较开销。在实际开发中,若业务允许重复数据,推荐使用 UNION ALL 以获得更好的性能。
立即学习“Java免费学习笔记(深入)”;

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
如何处理联合查询中的列类型不一致与空值
当联合查询涉及不同表或视图时,各子查询返回的列类型可能不完全相同,JDBC 会通过隐式类型转换尝试对齐,但若转换失败则会抛出 SQLException。例如,一个子查询返回 INT 类型,另一个返回 VARCHAR,在某些数据库中可能导致错误。此外,若某个子查询返回空结果集,联合查询仍会正常执行,不会报错,但需确保后续代码能正确处理零行数据的情况。建议在编写 SQL 时使用 CASE WHEN 或 CAST 显式统一类型,并在 Java 端使用 rs.getObject() 配合类型检查以增强健壮性。

import java.sql.*;

public class UnionTypeHandling {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // 使用 CAST 确保两子查询列类型一致
        String sql = "SELECT id, CAST(name AS CHAR) as name, COALESCE(score, 0) as score FROM students " +
                     "UNION ALL " +
                     "SELECT id, CAST(username AS CHAR) as name, COALESCE(points, 0) as score FROM players";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    // 使用 getObject 避免类型转换异常
                    Object idObj = rs.getObject("id");
                    Object nameObj = rs.getObject("name");
                    Object scoreObj = rs.getObject("score");

                    if (idObj != null && nameObj != null && scoreObj != null) {
                        System.out.printf("ID: %s, Name: %s, Score: %s%n",
                                idObj.toString(), nameObj.toString(), scoreObj.toString());
                    }
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
该示例通过 CAST 将名称字段统一为字符型,并用 COALESCE 处理空分数,确保联合查询结果的结构一致性。在 Java 端,使用 getObject() 可避免因类型不匹配导致的 ClassCastException。若某行数据中某列为 NULL,getObject() 将返回 null,因此需进行非空判断。这种处理方式适用于多源数据整合场景,如将学生成绩与玩家积分合并展示。
基于 ResultSet 游标位置的具体问题
在使用 ResultSet 遍历联合查询结果时,游标默认位于第一行之前,每次调用 next() 才会移动到下一行。若在 next() 返回 false 后继续访问列数据,将抛出 SQLException。此外,若连接使用了 Statement.TYPE_FORWARD_ONLY(默认),则无法向后移动游标,也无法随机访问行。对于大型联合查询结果,建议逐行处理并及时释放资源,避免内存溢出。若需多次遍历结果,可将数据加载到 List 或 Map 中,或使用 ResultSet.TYPE_SCROLL_INSENSITIVE 创建可滚动结果集,但需注意其性能开销。



















