








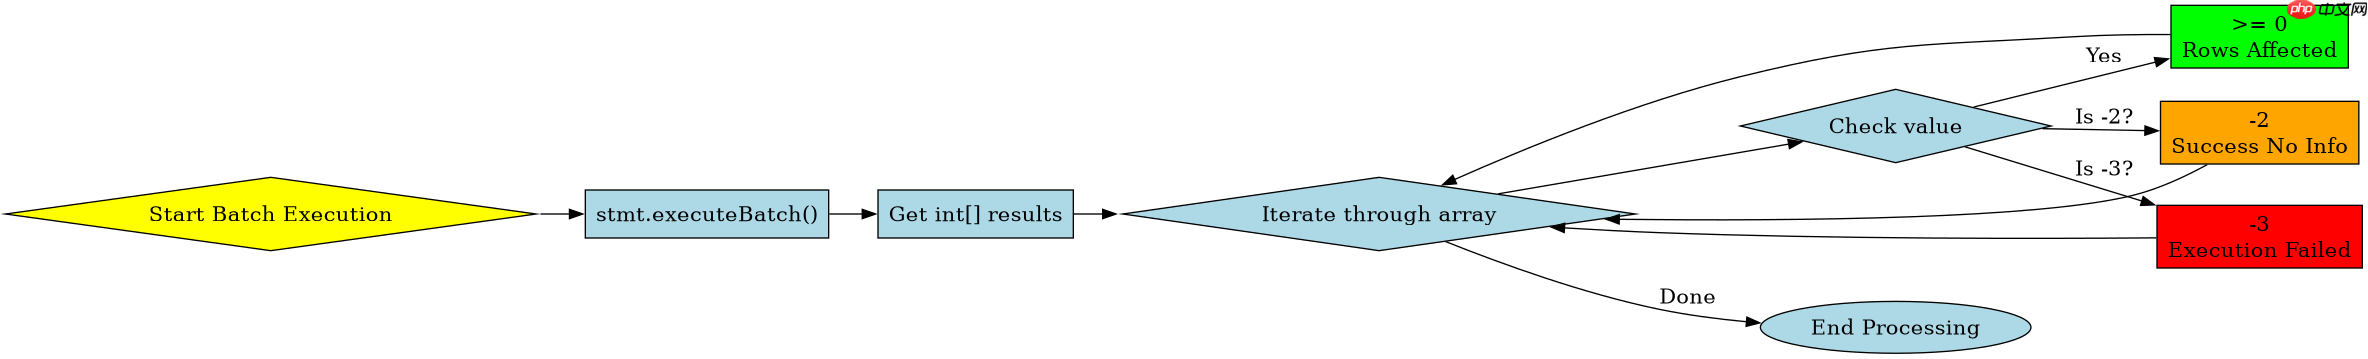
java jdbc 处理批量操作结果获取的核心方法是调用 executebatch() 后解析返回的 int[] 数组。该数组中的每个元素对应一条 sql 语句的执行状态,其中非负整数表示受影响的行数,而 -2 代表成功执行但受影响行数未知(常见于 ddl),-3 代表执行失败。通过遍历这个数组,开发者可以精确判断每条语句是成功、失败还是被跳过,从而决定是否需要回滚或记录日志。
executeBatch() 返回值的含义是什么
executeBatch() 方法返回一个整型数组,其长度与添加到批次的 SQL 语句数量一致。数组索引对应语句在批次中的顺序。如果某条语句执行成功并返回了受影响行数,数组对应位置即为该正整数;若语句是 UPDATE 或 DELETE 且未匹配任何行,值为 0;若语句是 INSERT 且数据库不支持返回行数,或者语句类型特殊,值可能为 -2;若抛出异常导致部分执行,后续未执行的语句在数组中通常保持默认值 0 或不被填充,具体取决于驱动实现,但标准行为是只返回已执行语句的状态。理解这些返回值是处理批量结果的基础。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.Statement;

public class BatchResultExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement()) {

            // 清除之前的批次
            stmt.clearBatch();

            // 添加多条更新语句到批次
            stmt.addBatch("UPDATE users SET status = 1 WHERE id = 1");
            stmt.addBatch("UPDATE users SET status = 1 WHERE id = 2");
            stmt.addBatch("UPDATE users SET status = 1 WHERE id = 999"); // 假设id=999不存在

            // 执行批量操作并获取结果
            int[] results = stmt.executeBatch();

            // 遍历结果数组
            for (int i = 0; i < results.length; i++) {
                if (results[i] >= 0) {
                    System.out.println("Statement " + (i + 1) + " succeeded. Rows affected: " + results[i]);
                } else if (results[i] == Statement.SUCCESS_NO_INFO) {
                    System.out.println("Statement " + (i + 1) + " succeeded with no info.");
                } else if (results[i] == Statement.EXECUTION_FAILED) {
                    System.out.println("Statement " + (i + 1) + " failed.");
                }
            }

        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
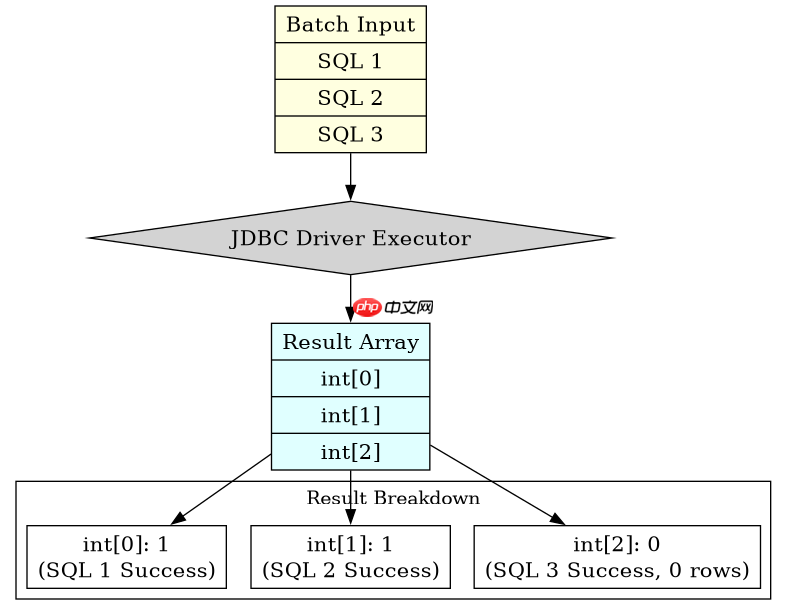
上述代码展示了如何获取并解析 executeBatch() 的结果。预期输出将显示前两条语句的成功状态及受影响行数(通常为1),第三条语句同样成功但受影响行数为0。如果某条语句因语法错误等导致执行失败,JDBC 驱动通常会抛出 BatchUpdateException,此时需要捕获该异常并通过其 updateCounts() 方法获取已成功执行的语句结果。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理批量操作中的部分失败情况
当批量操作中某条语句执行失败时,JDBC 规范规定会抛出 BatchUpdateException。这个异常对象包含了 getUpdateCounts() 方法,该方法返回一个 int[] 数组,记录了在失败发生之前所有已成功执行的语句的受影响行数。这意味着即使整个批次没有完全成功,你仍然可以通过捕获异常来获取部分成功的结果,从而进行精细化的错误处理和事务回滚控制。

import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.Statement;

public class PartialFailureHandling {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement()) {

            conn.setAutoCommit(false);
            stmt.addBatch("INSERT INTO logs (msg) VALUES ('log1')");
            stmt.addBatch("INSERT INTO logs (msg) VALUES ('log2')");
            stmt.addBatch("INVALID SQL STATEMENT"); // 这将导致失败
            stmt.addBatch("INSERT INTO logs (msg) VALUES ('log4')");

            try {
                int[] results = stmt.executeBatch();
                conn.commit();
            } catch (BatchUpdateException e) {
                // 获取已成功执行的语句结果
                int[] updateCounts = e.getUpdateCounts();
                System.out.println("Batch partially failed. Successful statements: " + updateCounts.length);
                for (int i = 0; i < updateCounts.length; i++) {
                    System.out.println("Statement " + (i + 1) + " result: " + updateCounts[i]);
                }
                conn.rollback(); // 回滚整个事务
            }

        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
此代码演示了捕获 BatchUpdateException 并提取部分成功结果的过程。预期结果是程序会打印出前两条语句的成功计数,然后执行回滚。这确保了数据的一致性,避免了部分数据写入数据库而另一部分丢失的情况。开发者应根据业务需求决定是回滚整个批次还是仅处理失败的语句。
基于 Statement.SUCCESS_NO_INFO 的具体问题
当批量操作中包含 CREATE TABLE 或 ALTER TABLE 等 DDL 语句时,executeBatch() 返回的数组中对应位置的值通常是 Statement.SUCCESS_NO_INFO(即 -2)。这表明语句执行成功,但驱动程序无法提供具体的受影响行数,因为 DDL 操作不产生传统意义上的“行”影响。在处理此类结果时,不应将其视为错误或忽略,而应作为成功的一种特殊状态进行处理。



















