








java jdbc 实现批量操作死锁检测的核心在于捕获 sqlexception 中的 sqlstate 或错误码,识别出数据库返回的死锁标识(如 mysql 的 1213 或 postgresql 的 40p01),并在代码中通过循环重试机制处理。具体做法是:将批量更新包裹在事务中,执行后检查异常;若确认为死锁,则回滚当前事务并重新执行该批次;同时需设置合理的最大重试次数和退避策略,防止无限循环。

如何配置 JDBC 驱动以支持自动重试与超时控制
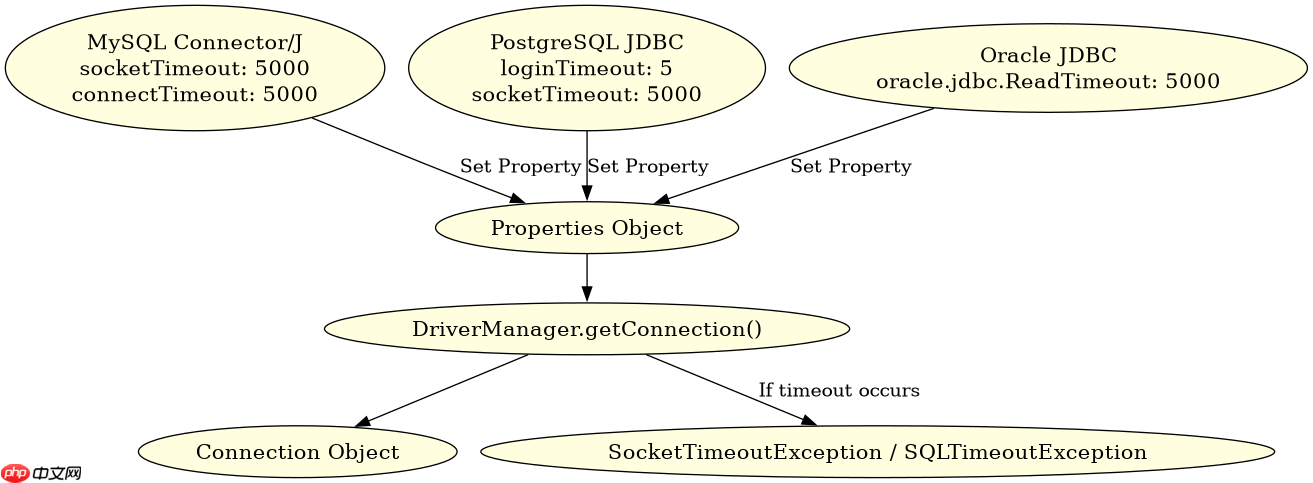
要确保死锁检测有效,必须配置连接池或驱动层面的超时参数,避免线程永久挂起。以 MySQL Connector/J 为例,可通过 socketTimeout 和 connectTimeout 设置网络层超时,并通过 autoReconnect 属性控制断线重连行为。对于 PostgreSQL,可使用 loginTimeout 和 socketTimeout。这些配置能辅助快速失败,但无法替代应用层的死锁逻辑判断,因为死锁通常由数据库引擎主动抛出异常而非超时。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.util.Properties;

public class JdbcConfigExample {
    public static Connection createConnection() throws SQLException {
        Properties props = new Properties();
        props.setProperty("user", "username");
        props.setProperty("password", "password");
        // MySQL 示例:设置 socket 超时为 5 秒
        props.setProperty("socketTimeout", "5000");
        props.setProperty("connectTimeout", "5000");
        // PostgreSQL 示例:设置 login 超时
        // props.setProperty("loginTimeout", "5");

        return DriverManager.getConnection("jdbc:mysql://localhost:3306/test", props);
    }
}
上述代码展示了如何通过 Properties 对象传递超时参数。实际运行时,若数据库响应超过设定时间,JDBC 驱动会抛出 SocketTimeoutException 或 SQLTimeoutException,这与死锁异常不同,需分别处理。正确配置可提升系统健壮性,但不直接解决死锁问题。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在业务代码中封装死锁重试逻辑
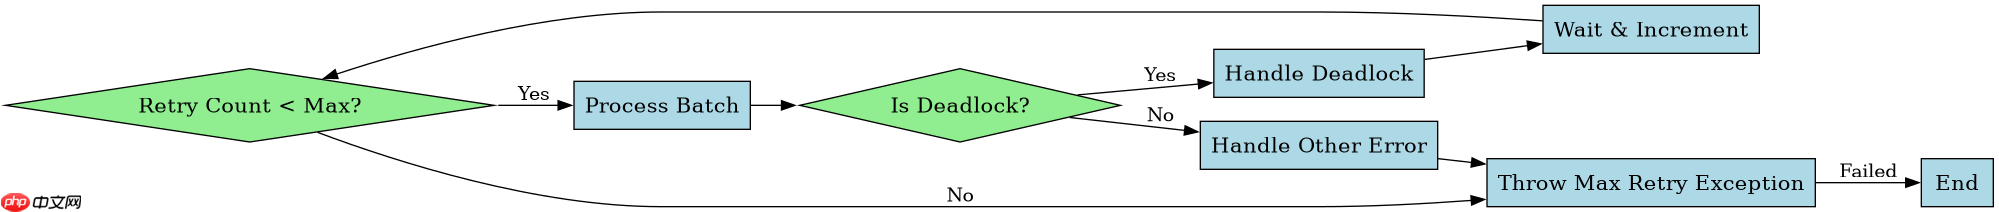
在业务层,应将批量操作封装为独立方法,内部包含事务管理、异常捕获和重试逻辑。关键步骤包括:开启事务、添加批量语句、执行批量、捕获 SQLException、判断是否为死锁、决定重试或抛出异常。推荐使用 try-catch-finally 结构确保事务状态一致。例如,在 MySQL 中,死锁错误码为 1213,对应 SQLState 为 40001。在 PostgreSQL 中,错误码为 40P01。代码中应明确区分这两种情况,并针对每种数据库类型定义常量。
import java.sql.*;

public class BatchDeadlockHandler {
    private static final int MAX_RETRIES = 3;
    private static final long RETRY_DELAY_MS = 100;

    public void executeBatchWithRetry(Connection conn, String[] sqlStatements) throws SQLException {
        int retryCount = 0;
        while (retryCount < MAX_RETRIES) {
            try {
                conn.setAutoCommit(false);
                Statement stmt = conn.createStatement();
                for (String sql : sqlStatements) {
                    stmt.addBatch(sql);
                }
                stmt.executeBatch();
                conn.commit();
                return; // 成功退出
            } catch (SQLException e) {
                if (isDeadlockError(e)) {
                    conn.rollback();
                    retryCount++;
                    Thread.sleep(RETRY_DELAY_MS * retryCount); // 指数退避
                } else {
                    throw e; // 非死锁异常直接抛出
                }
            } finally {
                conn.setAutoCommit(true);
            }
        }
        throw new SQLException("Max retries exceeded due to deadlock", e);
    }

    private boolean isDeadlockError(SQLException e) {
        // MySQL: error code 1213, SQLState 40001
        // PostgreSQL: error code 40P01
        return e.getErrorCode() == 1213 || "40P01".equals(e.getSQLState());
    }
}
该程序演示了完整的重试流程。输入为一组 SQL 字符串,输出为成功提交或抛出异常。预期结果:若前两次因死锁失败,第三次成功,则无异常;若三次均失败,则抛出“Max retries exceeded”异常。注意:stmt.executeBatch() 可能部分成功,需根据实际需求决定是否回滚已执行部分。本例简化处理,假设全部失败才重试。实际生产中应更精细地处理部分成功场景。
当批量操作中某条语句导致死锁时,如何定位具体失败语句
在批量操作中,若某条语句引发死锁,executeBatch() 通常会抛出异常,但不会明确指出是哪条语句导致。此时,可通过逐条执行并捕获异常来定位,但这会降低性能。另一种方法是使用数据库提供的诊断工具,如 MySQL 的 SHOW ENGINE INNODB STATUS 或 PostgreSQL 的 pg_stat_activity 查看等待链。在代码层面,可在每次 addBatch() 后记录语句索引,并在异常发生时结合日志分析。例如,在 MySQL 中,死锁信息包含参与事务的 ID 和最后执行的语句,可通过解析错误消息获取线索。但最可靠的方式仍是优化 SQL 设计,如统一访问顺序、缩短事务长度、使用乐观锁等,从根本上减少死锁概率。



















