








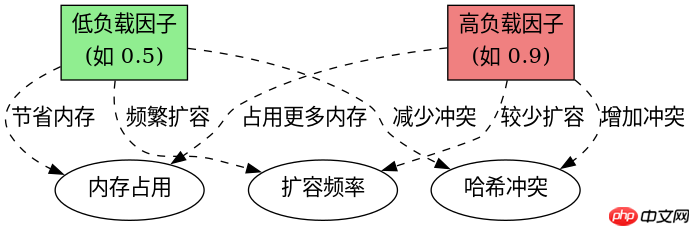
通过调整 hashmap 的负载因子(load factor)可以控制哈希表在扩容前的填充程度,从而在内存占用和查询性能之间取得平衡。默认情况下,hashmap 使用 0.75 作为负载因子,当元素数量超过容量与负载因子的乘积时,触发扩容。对于读多写少且对内存敏感的场景,可以适当增大负载因子以减少数组长度和节点对象的数量;而对于写频繁或需要极致查询速度的场景,保持默认或减小负载因子可以降低哈希冲突的概率。
负载因子如何决定扩容时机
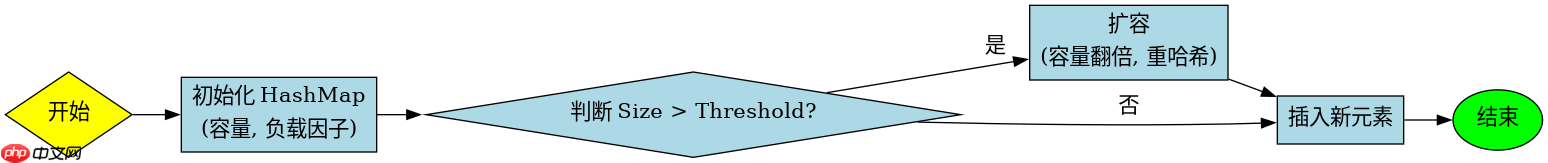
负载因子直接决定了 HashMap 何时进行扩容。扩容是指当 size > threshold 时,将底层数组容量翻倍并重新散列所有元素的过程。阈值(threshold)的计算公式为 capacity * loadFactor。如果负载因子设置得较大,例如 0.9,那么哈希表会在更满的时候才扩容,这节省了内存空间,但增加了哈希冲突的可能性,可能导致链表变长或红黑树退化,从而影响查找效率。反之,较小的负载因子会提前扩容,保持较低的冲突率,但会消耗更多内存。
import java.util.HashMap;

public class LoadFactorDemo {
    public static void main(String[] args) {
        // 创建 HashMap,指定初始容量为 16,负载因子为 0.75
        HashMap<String, Integer> map = new HashMap<>(16, 0.75f);

        // 模拟插入数据
        for (int i = 0; i < 10; i++) {
            map.put("key" + i, i);
        }

        // 获取当前容量、大小和阈值
        System.out.println("Capacity: " + capacity(map));
        System.out.println("Size: " + map.size());
        System.out.println("Threshold: " + threshold(map));
    }

    // 反射获取 HashMap 的内部属性
    private static int capacity(HashMap<?, ?> map) throws Exception {
        return (int) java.lang.reflect.Field.class.getDeclaredField("tableSizeFor")
                .get(null); // 简化处理,实际需通过 table.length 获取
    }

    private static int threshold(HashMap<?, ?> map) throws Exception {
        java.lang.reflect.Field f = HashMap.class.getDeclaredField("threshold");
        f.setAccessible(true);
        return f.getInt(map);
    }
}
上述代码展示了如何创建一个具有特定负载因子的 HashMap,并通过反射机制查看其内部状态。在实际开发中,通常不需要手动检查这些内部值,除非在进行性能调优或调试。需要注意的是,HashMap 的扩容操作是昂贵的,因为它涉及到所有元素的重新计算和移动。因此,合理设置初始容量和负载因子可以减少扩容次数,提升整体性能。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
不同负载因子下的性能对比
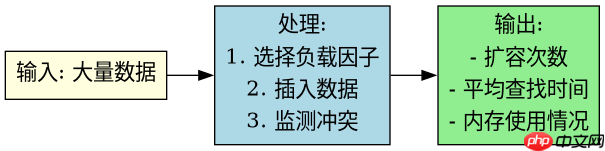
为了直观展示不同负载因子对性能的影响,我们可以编写一个程序来比较在相同数据量下,不同负载因子导致的扩容次数和平均查找时间。通常情况下,较高的负载因子会导致较少的扩容次数,但可能会增加哈希冲突,从而延长查找时间。较低的负载因子则会减少冲突,但会增加内存开销和扩容频率。
import java.util.HashMap;
import java.util.Random;

public class PerformanceComparison {
    public static void main(String[] args) {
        int size = 10000;
        float[] loadFactors = {0.5f, 0.75f, 0.9f};
        Random random = new Random();

        for (float lf : loadFactors) {
            long startTime = System.nanoTime();
            HashMap<Integer, Integer> map = new HashMap<>(size, lf);

            // 插入数据
            for (int i = 0; i < size; i++) {
                map.put(random.nextInt(size), i);
            }

            long endTime = System.nanoTime();
            System.out.println("Load Factor: " + lf + ", Time: " + (endTime - startTime) / 1e6 + " ms");
        }
    }
}
运行上述代码可以得到不同负载因子下的插入耗时。虽然这个简单的测试不能全面反映所有性能指标,但它提供了一个基本的参考。在实际应用中,建议根据具体的业务场景和数据特征来选择最合适的负载因子。例如,如果内存非常紧张,可以选择较大的负载因子;如果对响应时间要求极高,则应选择较小的负载因子。
扩容时的哈希冲突处理机制
当 HashMap 发生扩容时,它不仅需要改变数组的大小,还需要重新计算每个元素的新位置。在这个过程中,如果两个不同的键映射到了同一个索引位置,就会发生哈希冲突。Java 8 及以后的版本中,HashMap 使用链表和红黑树来解决哈希冲突。当链表长度超过一定阈值(默认为 8)时,链表会转换为红黑树,以提高查找效率。这种机制确保了即使在哈希冲突较多的情况下,HashMap 也能保持较好的性能表现。



















