








在 javascript 中,如果只需要通过 id 获取元素,应优先使用 getelementbyid,因为它执行速度更快且语义更明确;如果需要基于 css 选择器(如类名、属性或层级)获取元素,则必须使用 queryselector。两者都能返回单个元素或 null,但适用场景不同。

为什么 getElementById 性能更好
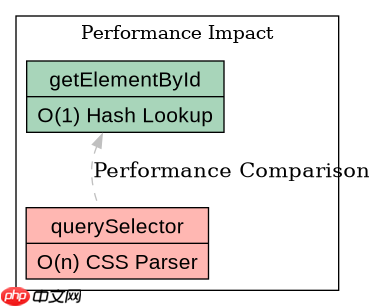
getElementById 是浏览器原生针对 ID 优化的方法,它直接映射到 DOM 树的哈希索引,无需解析复杂的 CSS 规则。相比之下,querySelector 需要调用 CSS 选择器引擎进行匹配,开销更大。在高频操作或大量元素遍历中,这种差异尤为明显。
const btn = document.getElementById('submit-btn');
console.log(btn.tagName); // BUTTON

// 对比 querySelector
const btn2 = document.querySelector('#submit-btn');
console.log(btn === btn2); // true
上述代码展示了两种方法获取同一元素的结果。虽然结果相同,但 getElementById 避免了选择器解析步骤。在实际开发中,若 ID 已知,直接使用前者可减少不必要的计算资源消耗。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
何时必须使用 querySelector
当目标元素没有唯一 ID,或者需要根据复杂样式规则(如伪类、属性值、后代关系)定位时,getElementById 无法胜任。此时 querySelector 提供了强大的 CSS 选择器支持,能够灵活应对各种 DOM 结构。

const items = document.querySelectorAll('.list-item.active');
items.forEach(item => console.log(item.textContent));

// 获取第一个匹配的类名元素
const firstActive = document.querySelector('.active');
这段代码演示了如何使用 querySelector 和 querySelectorAll 处理类名和状态筛选。例如,获取所有带有 .active 类的列表项,或仅获取第一个匹配的元素。这些操作无法通过 getElementById 实现,体现了其在复杂选择场景下的必要性。
querySelector 遇到空输入会返回什么
当 querySelector 的选择不匹配任何元素时,它会返回 null,而不是抛出错误或返回空集合。这与 querySelectorAll 返回空 NodeList 不同,开发者需特别注意判空处理,避免访问 null 的属性导致运行时错误。
const missing = document.querySelector('#non-existent-id');
console.log(missing); // null

if (missing) {
  missing.style.color = 'red';
} else {
  console.warn('Element not found');
}
示例中,查询一个不存在的 ID 返回 null。代码随后进行了判空检查,确保只有在元素存在时才尝试修改样式。这种防御性编程习惯能有效防止因选择失败导致的脚本中断。在实际项目中,建议始终对 querySelector 的结果进行验证,尤其是在动态内容加载的场景下。

















