








java 数据库连接池实现自动扩容的核心在于配置最大连接数(maxpoolsize)并启用动态调整机制,通常由底层连接池库(如 hikaricp、druid 或 c3p0)在检测到活跃连接不足时自动创建新连接。以主流的 hikaricp 为例,只需设置 maximumpoolsize 参数,当线程请求连接且当前池内空闲连接耗尽时,hikaricp 会自动尝试创建新连接直至达到该上限,无需手动编写扩容逻辑。
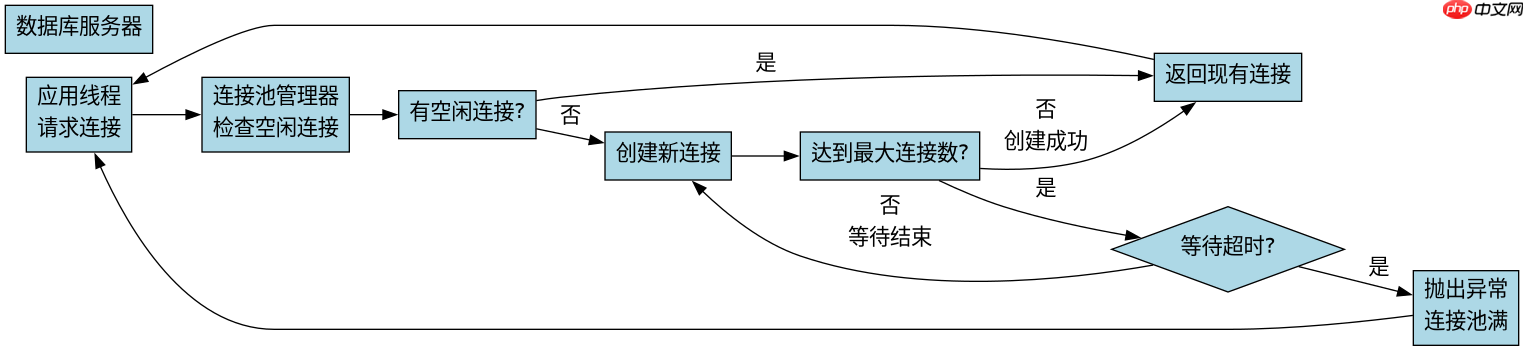
HikariCP 如何根据负载动态增加连接数
HikariCP 的自动扩容依赖于其内部对活跃连接数的监控和异步创建策略。当应用线程调用 getConnection() 时,如果池中还有空闲连接,直接返回;如果没有空闲连接且当前总连接数小于 maximumPoolSize,则触发创建新连接的流程。这个过程是同步阻塞的,直到新连接建立成功或超时。配置的关键点在于合理设置
maximumPoolSize</u003e,它不应等于 CPU 核心数,而应根据数据库并发处理能力和网络延迟综合评估。</p><p><img src="https://img.php.cn/upload/article/001/242/473/179523300527523.png" alt="Java 数据库连接池怎么配置连接池自动扩容"></p>
<pre class="brush:php;toolbar:false;">import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;

public class PoolConfigExample {
    public static void main(String[] args) {
        // 1. 创建配置对象
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl("jdbc:mysql://localhost:3306/testdb");
        config.setUsername("root");
        config.setPassword("password");

        // 2. 关键配置:设置最大连接数为 20
        // 当活跃连接超过最小空闲数且未达到此值时,会自动扩容
        config.setMaximumPoolSize(20);
        config.setMinimumIdle(5); // 最小空闲连接数

        // 3. 其他推荐配置
        config.addDataSourceProperty("cachePrepStmts", "true");
        config.addDataSourceProperty("prepStmtCacheSize", "250");
        config.addDataSourceProperty("prepStmtCacheSqlLimit", "2048");

        // 4. 初始化数据源
        try (HikariDataSource dataSource = new HikariDataSource(config)) {
            System.out.println("连接池已启动,最大连接数: " + dataSource.getMaximumPoolSize());
            // 模拟获取连接
            try (var conn = dataSource.getConnection()) {
                System.out.println("成功获取连接: " + conn.isValid(1));
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了标准的 HikariCP 配置方式。运行后,控制台会输出连接池启动信息及连接验证结果。在实际高并发场景下,当线程数激增导致 minimumIdle 设定的空闲连接被全部占用时,HikariCP 会立即开始创建新连接,直到总数达到 <code>maximumPoolSize 为止。这种机制确保了在高负载下系统能迅速响应,同时避免无限制创建连接导致数据库过载。
立即学习“Java免费学习笔记(深入)”;

Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
Druid 连接池如何实现连接池的动态伸缩
阿里巴巴 Druid 连接池提供了更细粒度的控制,除了基础的 maxActive 参数外,还支持通过 JMX 或 API 动态调整连接池大小。Druid 的自动扩容同样基于活跃连接数与最大连接数的比较,但它还引入了“守护线程”定期检测连接状态,并在必要时进行清理或补充。与 HikariCP 不同,Druid 允许在运行时通过 setMaxActive() 方法实时修改最大连接数,从而实现真正的动态伸缩。

import com.alibaba.druid.pool.DruidDataSource;
import java.sql.Connection;

public class DruidDynamicPoolExample {
    public static void main(String[] args) throws Exception {
        // 1. 创建 Druid 数据源
        DruidDataSource dataSource = new DruidDataSource();
        dataSource.setUrl("jdbc:mysql://localhost:3306/testdb");
        dataSource.setUsername("root");
        dataSource.setPassword("password");

        // 2. 初始配置
        dataSource.setMaxActive(10); // 初始最大连接数
        dataSource.setMinIdle(2);

        // 3. 初始化连接池
        dataSource.init();

        // 4. 模拟动态扩容:将最大连接数调整为 30
        System.out.println("初始最大连接数: " + dataSource.getMaxActive());
        dataSource.setMaxActive(30);
        System.out.println("调整后最大连接数: " + dataSource.getMaxActive());

        // 5. 验证扩容效果
        try (Connection conn = dataSource.getConnection()) {
            System.out.println("获取连接成功,当前活跃连接数可能已增加");
        }

        // 6. 关闭资源
        dataSource.close();
    }
}
该示例演示了 Druid 连接池的动态调整能力。程序首先以 10 个最大连接数启动,随后通过代码将上限提升至 30。这意味着在后续的高并发请求中,Druid 可以创建多达 30 个物理连接。这种动态性特别适合流量波动大的业务场景,例如电商大促期间临时提升连接池容量,活动结束后再降回正常水平,从而平衡性能与资源消耗。
当连接池达到最大连接数时会发生什么
当连接池中的活跃连接数达到配置的 maximumPoolSize(HikariCP)或 maxActive(Druid)时,任何新的 getConnection() 调用都将进入等待状态,而不是立即失败或创建新连接。这个等待过程受超时参数控制,如 HikariCP 的 connectionTimeout(默认 30 秒)。如果在此时间内无法获得可用连接,系统将抛出 SQLException 或 SQLTransientConnectionException,提示客户端连接池已满。因此,合理设置超时时间和最大连接数是防止雪崩效应的关键。



















