








java 的 bytearrayinputstream 通过持有内存中的字节数组,将数据暴露为流式读取接口,从而让标准字节流 api 能直接处理内存数据。使用时只需传入目标 byte[] 构造实例,随后调用 read()、read(byte[], int, int) 或 skip() 等方法即可按顺序获取内容。由于它不依赖外部文件,所有操作均在堆内存中完成,且支持通过 reset() 方法重置内部指针回到初始位置。

ByteArrayInputStream 如何管理内部缓冲区与读取指针
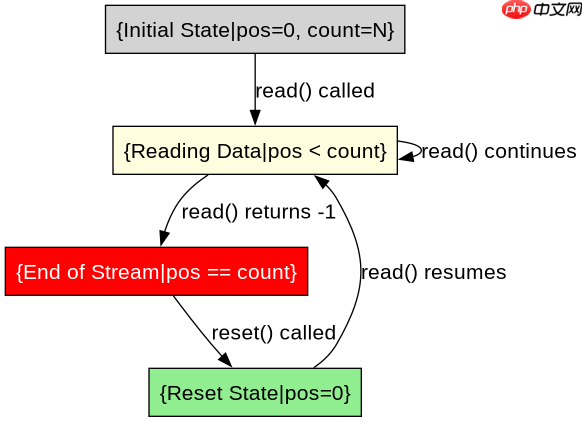
该类在构造时接收一个字节数组作为数据源,并在内部维护两个核心状态:指向当前读取位置的 pos 和数组长度 count。每次调用 read() 都会返回 buf[pos] 的值并将 pos 自增,直到 pos 达到 count 时返回 -1 表示结束。这种机制使得内存中的数据可以被当作输入流一样被消费,而无需进行额外的拷贝或转换。
import java.io.ByteArrayInputStream;
import java.io.IOException;

public class BufferDemo {
    public static void main(String[] args) throws IOException {
        byte[] data = {65, 66, 67}; // 'A', 'B', 'C'
        ByteArrayInputStream stream = new ByteArrayInputStream(data);

        System.out.print("First pass: ");
        int b;
        while ((b = stream.read()) != -1) {
            System.out.print((char) b + " ");
        }

        stream.reset();
        System.out.print("\nSecond pass: ");
        while ((b = stream.read()) != -1) {
            System.out.print((char) b + " ");
        }
    }
}
运行上述代码,预期输出为:
First pass: A B C
Second pass: A B C
该程序展示了 ByteArrayInputStream 的核心特性:它不会修改原始数组 data,而是通过移动内部指针 pos 来模拟读取过程。当第一次循环结束时,pos 等于 count。调用 reset() 后,pos 被重置为 0,允许重新遍历相同的数据。这证明了其内部缓冲区的可重用性。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何批量读取并跳过指定字节数
除了单字节读取,ByteArrayInputStream 还提供了 read(byte[] b, int off, int len) 用于批量填充目标数组,以及 skip(long n) 用于快速跳过指定数量的字节而不消耗资源。这些方法在处理大块内存数据时比逐字节读取更高效,因为它们减少了方法调用的开销。

import java.io.ByteArrayInputStream;
import java.io.IOException;

public class BatchReadDemo {
    public static void main(String[] args) throws IOException {
        byte[] source = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
        ByteArrayInputStream stream = new ByteArrayInputStream(source);

        // 批量读取前3个字节
        byte[] buffer = new byte[3];
        int bytesRead = stream.read(buffer, 0, 3);
        System.out.println("Bytes read: " + bytesRead); // 3
        System.out.print("Buffer content: ");
        for (byte b : buffer) System.out.print(b + " ");

        // 跳过接下来的2个字节
        long skipped = stream.skip(2);
        System.out.println("\nSkipped: " + skipped); // 2

        // 读取剩余部分
        System.out.print("Remaining: ");
        while ((bytesRead = stream.read(buffer)) > 0) {
            for (int i = 0; i < bytesRead; i++) {
                System.out.print(buffer[i] + " ");
            }
        }
    }
}
运行结果预期为:
Bytes read: 3
Buffer content: 1 2 3
Skipped: 2
Remaining: 6 7 8 9 10
此示例验证了批量操作的行为。read(buffer, 0, 3) 从当前位置(索引0)开始,最多读取3个字节放入 buffer,实际读取3个。随后 skip(2) 将指针从索引3移动到索引5,跳过了值4和5。最后的循环读取剩余的所有字节。这表明 skip() 确实改变了内部指针位置,且不影响后续读取的正确性。
当 skip() 请求跳过超过剩余字节数时会发生什么
如果调用 skip(n) 时,n 大于当前剩余的可用字节数(即 count - pos),该方法只会跳过尽可能多的字节,直到到达流的末尾,并返回实际跳过的字节数,而不是抛出异常。这是 InputStream 契约的一部分,旨在提供鲁棒的错误处理行为。
import java.io.ByteArrayInputStream;
import java.io.IOException;

public class SkipOverflowDemo {
    public static void main(String[] args) throws IOException {
        byte[] data = {10, 20};
        ByteArrayInputStream stream = new ByteArrayInputStream(data);

        // 尝试跳过100个字节,但只剩2个
        long actualSkipped = stream.skip(100);
        System.out.println("Actual skipped: " + actualSkipped); // 2
        System.out.println("Is at end: " + (stream.read() == -1)); // true
    }
}
预期输出:
Actual skipped: 2
Is at end: true
这段代码证实了 skip() 的安全边界行为。尽管请求跳过100字节,但由于数组只有2个元素,它只跳过了2个,并返回2。此时流已耗尽,再次调用 read() 返回 -1。开发者在使用 skip() 时应检查返回值,以确认是否成功跳过了预期的字节数,特别是在处理可能截断的数据源时。



















