








在spring data voltdb中处理空结果,核心策略是利用`optional

findById查询不到数据时返回什么
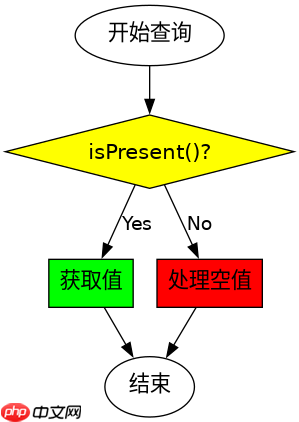
当使用Spring Data VoltDB的`CrudRepository`查询不存在的ID时,若返回类型为`Optional`,框架会自动返回`Optional.empty()`而非`null`。这要求开发者在业务代码中必须使用`isPresent()`判断或提供默认值,严禁直接调用`get()`,否则会在空值时抛出`NoSuchElementException`。
import org.springframework.data.voltdb.repository.VoltDBRepository;
import java.util.Optional;

public interface UserRepository extends VoltDBRepository<User, Long> {
    Optional<User> findByEmail(String email);
}
上述代码定义了基于邮箱的查询方法。由于VoltDB底层驱动支持JPA规范,Spring Data会自动将SQL查询结果为空的情况映射为`Optional.empty()`。在Service层调用时:
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
User user = userRepository.findByEmail("test@example.com")
    .orElse(new User("default"));
如果数据库中找不到该邮箱,`user`将被赋值为新的默认对象,程序不会中断。这种机制确保了空结果的确定性处理。
如何防止get()引发异常
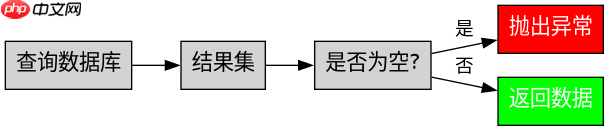
在Service层处理查询结果时,应优先使用`orElseThrow()`来显式处理缺失情况,而不是依赖隐式的`null`检查。通过结合自定义异常,可以将数据缺失转化为明确的业务错误信号,便于上层统一捕获。
public User getUserByEmail(String email) {
    return userRepository.findByEmail(email)
        .orElseThrow(() -> new RuntimeException("User not found"));
}
这段代码展示了典型的防御性编程模式。当`findByEmail`返回空时,立即抛出运行时异常。相比直接调用`get()`,这种方式允许你在抛出异常前附加上下文信息(如具体的邮箱地址),从而提升调试效率。同时,这也符合函数式编程的风格,使控制流更加线性。
批量查询返回空列表还是空Optional
对于批量查询或集合操作,Spring Data VoltDB通常返回`List`而非`Optional`。当没有匹配记录时,返回的是空列表`[]`而非`null`。这意味着开发者无需进行`null`检查,可以直接调用`isEmpty()`或遍历,但需注意区分“无数据”与“查询失败”的逻辑差异。


















