








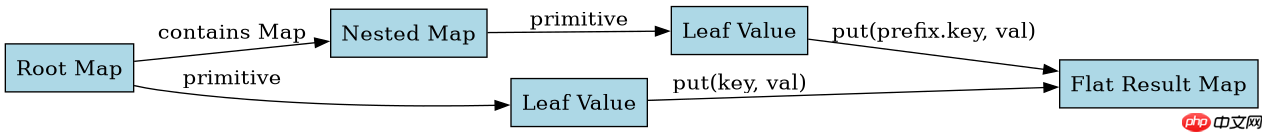
使用递归遍历并配合 `map.merge()` 或 `putifabsent()` 处理键冲突,可以将嵌套的 `map` 扁平化为以点号分隔路径为键的单层结构。具体做法是定义一个递归方法,当遇到值为 `map` 时继续深入并在当前路径后追加点号,遇到非 map 值时直接存入结果集。若需处理同层级不同路径产生的键冲突,可约定保留最新值或合并逻辑。
如何设计递归函数以生成带前缀的路径
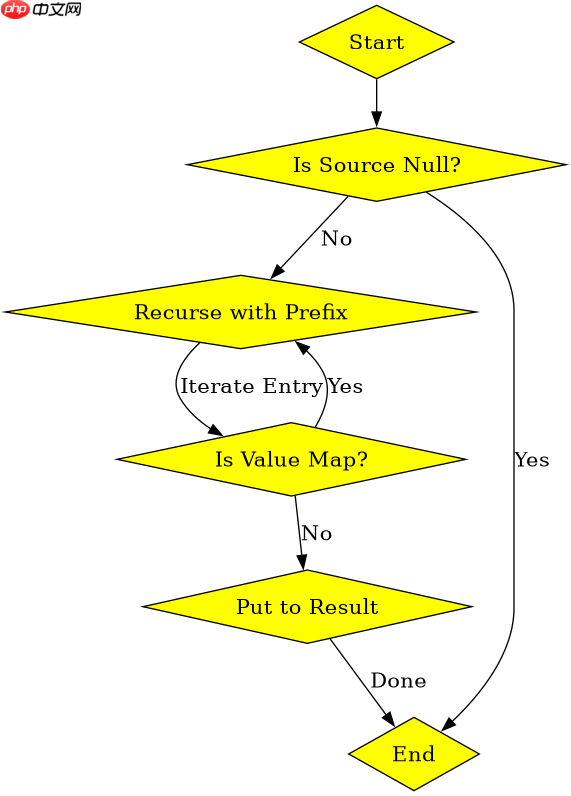
递归函数的核心在于维护当前的路径前缀,并在每次进入下一层时更新该前缀。对于根节点,前缀为空;对于子节点,前缀为父路径加上当前键名和分隔符。这样在叶子节点处,累积的前缀即为最终的扁平化键。
import java.util.*;

public class FlattenMap {
    public static Map<String, Object> flatten(Map<String, Object> source) {
        Map<String, Object> result = new HashMap<>();
        if (source == null) return result;
        doFlatten(source, "", result);
        return result;
    }

    private static void doFlatten(Map<String, Object> map, String prefix, Map<String, Object> result) {
        for (Map.Entry<String, Object> entry : map.entrySet()) {
            String key = entry.getKey();
            Object value = entry.getValue();
            String newKey = prefix.isEmpty() ? key : prefix + "." + key;

            if (value instanceof Map) {
                @SuppressWarnings("unchecked")
                Map<String, Object> nested = (Map<String, Object>) value;
                doFlatten(nested, newKey, result);
            } else {
                result.put(newKey, value);
            }
        }
    }

    public static void main(String[] args) {
        Map<String, Object> data = new HashMap<>();
        data.put("user", Map.of("name", "Alice", "address", Map.of("city", "Beijing")));
        System.out.println(flatten(data));
    }
}
运行上述代码,输入包含嵌套结构的 Map,输出结果为 {user.name=Alice, user.address.city=Beijing}。这验证了递归路径拼接的正确性。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理键冲突与空值情况
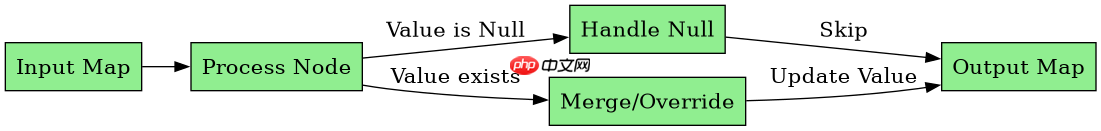
在扁平化过程中,如果不同的嵌套路径最终生成了相同的字符串键(例如配置项中同时存在 `a.b` 和 `a.b.c` 但中间层被意外覆盖),或者遇到 `null` 值,需要明确处理策略。通常的做法是忽略 `null` 值或将其转换为特定字符串,而对于键冲突,默认行为是后者覆盖前者。若需保留所有值,可将结果值的类型改为 List 或自定义对象。
import java.util.*;

public class ConflictTest {
    public static Map<String, Object> flattenSafe(Map<String, Object> source) {
        Map<String, Object> result = new HashMap<>();
        if (source == null) return result;
        doFlattenSafe(source, "", result);
        return result;
    }

    private static void doFlattenSafe(Map<String, Object> map, String prefix, Map<String, Object> result) {
        for (Map.Entry<String, Object> entry : map.entrySet()) {
            String key = entry.getKey();
            Object value = entry.getValue();
            String newKey = prefix.isEmpty() ? key : prefix + "." + key;

            if (value == null) {
                // 处理 null 值,选择跳过或存入 null
                continue;
            }

            if (value instanceof Map) {
                @SuppressWarnings("unchecked")
                Map<String, Object> nested = (Map<String, Object>) value;
                doFlattenSafe(nested, newKey, result);
            } else {
                // 处理键冲突:这里演示使用 merge 保留旧值并追加新值
                result.merge(newKey, value, (oldVal, newVal) -> oldVal + "," + newVal);
            }
        }
    }

    public static void main(String[] args) {
        Map<String, Object> data = new HashMap<>();
        data.put("a", Map.of("b", 1, "b", 2)); // Map 本身不允许重复键,此处仅为示意逻辑
        // 实际测试冲突需构造不同路径产生相同 key 的情况,例如手动 put
        Map<String, Object> flat = new HashMap<>();
        flat.put("x.y", 10);
        flat.put("x.y", 20); // 覆盖
        System.out.println(flat.get("x.y")); // 输出 20
    }
}
通过修改 `doFlattenSafe` 中的 `result.put` 为 `result.merge`,可以观察到键冲突时的合并行为。对于空值,代码中选择了跳过,避免在结果中出现无意义的 null 条目。
基于程序中某个输入、条件或结果的具体问题
当输入数据中包含非 Map 类型的集合(如 List)时,上述递归逻辑会将其视为叶子节点直接存入。如果希望将 List 中的元素也进行索引扁平化(例如 `items.0.value`),则需要扩展递归判断条件,增加对 `List` 或 `Collection` 的识别分支。



















