








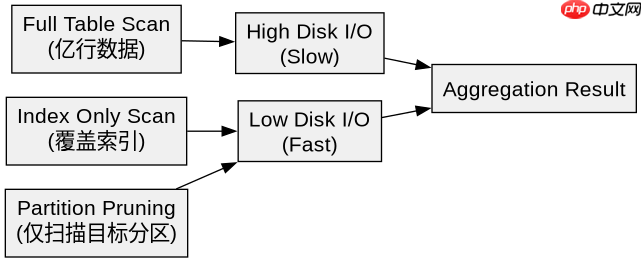
在sql中对亿级大表进行统计时,优化group by性能的核心策略是避免全表扫描和内存溢出,具体做法包括利用覆盖索引减少回表、通过分区裁剪缩小扫描范围以及使用近似算法或物化视图预处理数据。调用数据库的查询优化器并配合explain分析执行计划,确保索引选择正确且排序操作在磁盘外完成,这样可以将原本需要数小时的聚合任务缩短至分钟级。
如何利用覆盖索引消除回表开销
当GROUP BY涉及的列与SELECT列均存在于同一索引中时,数据库可直接从索引树获取数据,无需访问主键聚簇索引,从而大幅降低I/O成本。例如,若需按用户ID统计订单金额,应建立包含用户ID和金额的联合索引,使查询完全在索引层完成。
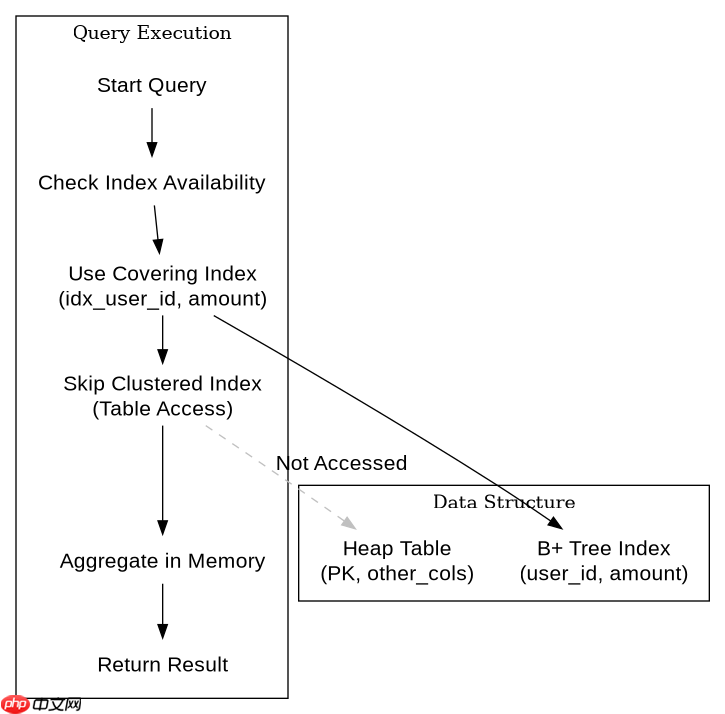
CREATE INDEX idx_user_amount ON orders(user_id, amount);
SELECT user_id, SUM(amount) FROM orders GROUP BY user_id;
上述语句在执行计划中会显示Using index,表明使用了覆盖索引。若缺少该索引,数据库将执行全表扫描并回表查询,导致性能急剧下降。对于亿级数据,这种差异可能意味着从几小时缩短到几分钟。
如何通过分区裁剪减少扫描数据量
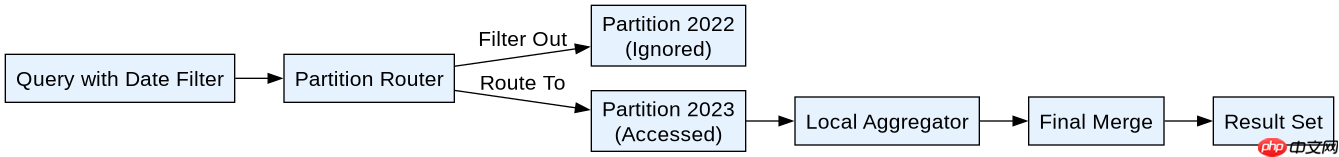
对大表进行时间或地域分区后,可在WHERE子句中指定分区条件,使数据库仅扫描相关分区而非全表。结合GROUP BY使用时,先过滤再聚合可显著减少参与计算的数据行数。例如,按日期分区时,限定查询最近一年的数据,可将扫描量从亿级降至千万级甚至更低。
ALTER TABLE orders PARTITION BY RANGE (YEAR(order_date)) (
  PARTITION p2022 VALUES LESS THAN (2023),
  PARTITION p2023 VALUES LESS THAN (2024)
);
SELECT user_id, SUM(amount) FROM orders WHERE order_date >= '2023-01-01' GROUP BY user_id;
此查询仅扫描p2023分区,避免了历史数据的读取。若未加WHERE条件,则需扫描所有分区,即使最终结果相同,中间过程也会消耗大量资源。分区键的选择应与高频查询条件一致,以最大化裁剪效果。
当GROUP BY字段基数极高时如何处理
若GROUP BY的字段区分度极高(如用户ID),会导致产生海量分组,内存无法容纳中间结果,引发磁盘临时表或交换分区。此时可考虑使用近似去重函数如APPROX_COUNT_DISTINCT替代精确计数,或将结果写入物化视图预聚合。此外,分布式数据库可通过Sharding将数据分散到多个节点并行聚合,最后合并结果。

















