








在sql大表delete期间执行select查询会严重卡顿,核心原因是数据库的mvcc(多版本并发控制)机制导致undo日志空间被大量占用,进而引发buffer pool中热数据页无法及时释放或清理。当delete操作产生海量回滚段时,select查询需要读取旧版本数据以维持事务一致性,这会触发大量的磁盘i/o和cpu计算,导致查询响应时间急剧上升甚至超时。
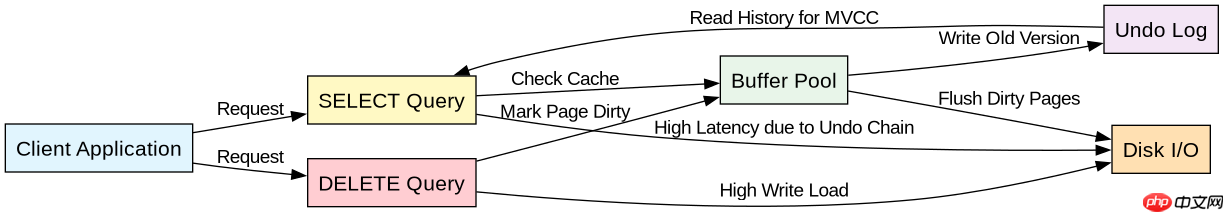
DELETE操作如何影响Buffer Pool中的页面状态?
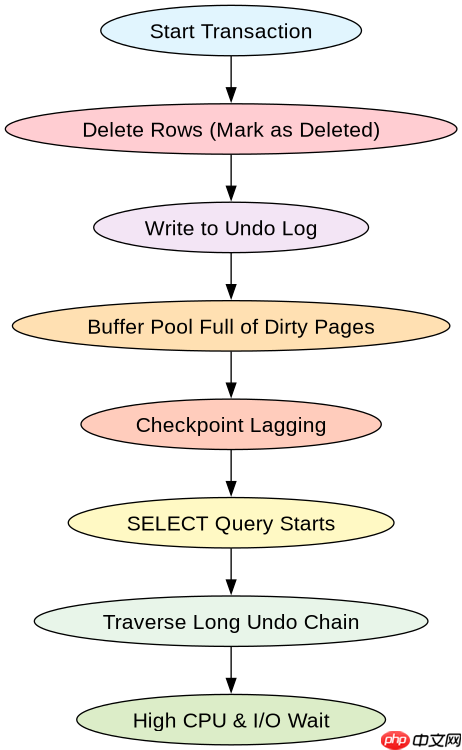
DELETE操作并不立即从物理磁盘上删除数据行,而是标记这些行为“已删除”,并将旧版本的数据写入Undo Log。在InnoDB等支持MVCC的数据库中,Buffer Pool是内存中的数据缓存区。当DELETE操作持续进行时,Buffer Pool中被修改过的数据页(Dirty Pages)数量迅速增加。如果Checkpoint进度跟不上DELETE的速度,这些脏页无法刷盘,导致Buffer Pool空间紧张。此时,新的SELECT查询如果需要访问这些被标记删除但尚未清理的页面,或者需要读取Undo Log来构建历史版本,就会因为内存竞争和I/O等待而变慢。
CREATE TABLE large_table (id INT PRIMARY KEY, data VARCHAR(255));
-- 假设表中已有1000万行数据
INSERT INTO large_table SELECT NULL, CONCAT('data_', seq) FROM sequence_generator;

-- 模拟大事务DELETE
START TRANSACTION;
DELETE FROM large_table WHERE id BETWEEN 1 AND 5000000;
-- 此时Buffer Pool中会有大量被标记为deleted的页面
-- 且Undo Log空间被大量占用

-- 在另一个会话中执行SELECT
SELECT COUNT(*) FROM large_table; -- 可能会因为读取Undo Log和锁竞争而变慢
COMMIT;
Undo Log的增长如何具体拖慢SELECT的性能?
Undo Log是用于事务回滚和MVCC读一致性的关键组件。在大表DELETE过程中,每一行被删除都会生成一条Undo记录。如果DELETE是一个大事务(未提交),所有的Undo记录都必须保留,直到事务结束。当SELECT查询启动时,它必须通过Read View判断当前可见的版本。如果目标行的最新版本是被当前正在进行的DELETE事务删除的,SELECT必须沿着Undo链向前查找,找到该事务开始之前最后一个可见的版本。随着DELETE的行数增多,Undo链变得极长,SELECT需要遍历更多的Undo记录才能找到有效数据,这导致了严重的CPU开销和I/O延迟。此外,如果Undo Log文件本身位于较慢的存储介质上,这种随机读取的性能损失会更加显著。

-- 监控Undo Log增长
SHOW ENGINE INNODB STATUS\G
-- 观察'LOG'部分,查看'log sequence number'和'log activity'

-- 模拟长时间运行的DELETE
START TRANSACTION;
DELETE FROM large_table WHERE id > 1000000;
-- 在另一个会话中执行复杂查询
SELECT * FROM large_table WHERE data LIKE '%test%'; -- 全表扫描+Undo链回溯
ROLLBACK;
如何验证并缓解大事务DELETE对SELECT的影响?
要验证这一现象,可以通过监控Buffer Pool的使用率和Undo Log的大小变化来观察。在实际操作中,避免在大表上进行单一大事务DELETE是最佳实践。可以采用分批DELETE的方式,每次删除少量数据并提交,这样可以让Checkpoint及时刷盘,回收Undo空间,从而减少对SELECT查询的影响。此外,确保数据库有足够的Buffer Pool大小,以便缓存更多热点数据,减少磁盘I/O。对于必须执行的大规模删除,建议在业务低峰期进行,并使用SLEEP函数控制删除节奏,例如每次删除1000行后暂停几毫秒,给其他查询留出处理时间。


















