








在presto sql中利用row_number过滤重复订单,核心做法是调用窗口函数 row_number() 配合 partition by 和 order by 子句。具体而言,将订单id等唯一标识作为分区依据,按时间或优先级排序,生成行号后在外层查询中筛选行号为1的记录,从而保留每个订单的最新或最优先版本并剔除其余重复项。

如何定义去重逻辑与排序规则
确定去重逻辑的关键在于明确“重复”的定义以及“保留哪一条”的标准。通常以 order_id 为分组键,若需保留最新记录则按 created_at 降序排列,若需保留最早记录则升序排列。这种逻辑直接决定了 ROW_NUMBER() 生成的序号分布,进而影响最终过滤结果。
WITH ranked_orders AS (
    SELECT
        order_id,
        user_id,
        amount,
        created_at,
        ROW_NUMBER() OVER (
            PARTITION BY order_id
            ORDER BY created_at DESC
        ) as rn
    FROM orders
)
SELECT
    order_id,
    user_id,
    amount,
    created_at
FROM ranked_orders
WHERE rn = 1;
上述代码首先通过CTE构建中间结果集,其中 rn 列即为去重后的行号。外层查询仅选取 rn = 1 的行,确保每个 order_id 仅返回一条记录。预期结果为:若某 order_id 存在多条记录,仅返回 created_at 最大的一条;若不存在重复,则原样返回。该方案适用于数据量适中且内存充足的场景,Presto会高效执行窗口计算。
如何处理大规模数据下的性能瓶颈
当数据规模达到TB级时,全表扫描并计算 ROW_NUMBER() 可能导致Shuffle开销过大。此时可结合预聚合或分桶策略优化。例如,先按 order_id 进行局部聚合,或在写入阶段使用分桶表减少扫描范围。此外,若业务允许,可引入 DISTINCT ON(若引擎支持)或基于哈希的预过滤机制降低计算复杂度。

-- 假设orders表已按order_id分桶
SELECT /*+ BROADCAST */
    order_id,
    user_id,
    amount,
    created_at
FROM (
    SELECT
        order_id,
        user_id,
        amount,
        created_at,
        ROW_NUMBER() OVER (
            PARTITION BY order_id
            ORDER BY created_at DESC
        ) as rn
    FROM orders
) sub
WHERE rn = 1;
此示例中,BROADCAST 提示用于优化小表关联,但核心仍依赖 ROW_NUMBER() 的去重逻辑。若数据倾斜严重,可考虑在 PARTITION BY 中加入更多维度(如 user_id)以平衡负载。预期行为:在合理分桶下,查询延迟显著降低,且结果一致性不变。需注意,Presto对窗口函数的支持依赖于其分布式执行引擎,实际性能受集群配置和数据分布影响。
当order_id包含NULL值时ROW_NUMBER的行为是什么
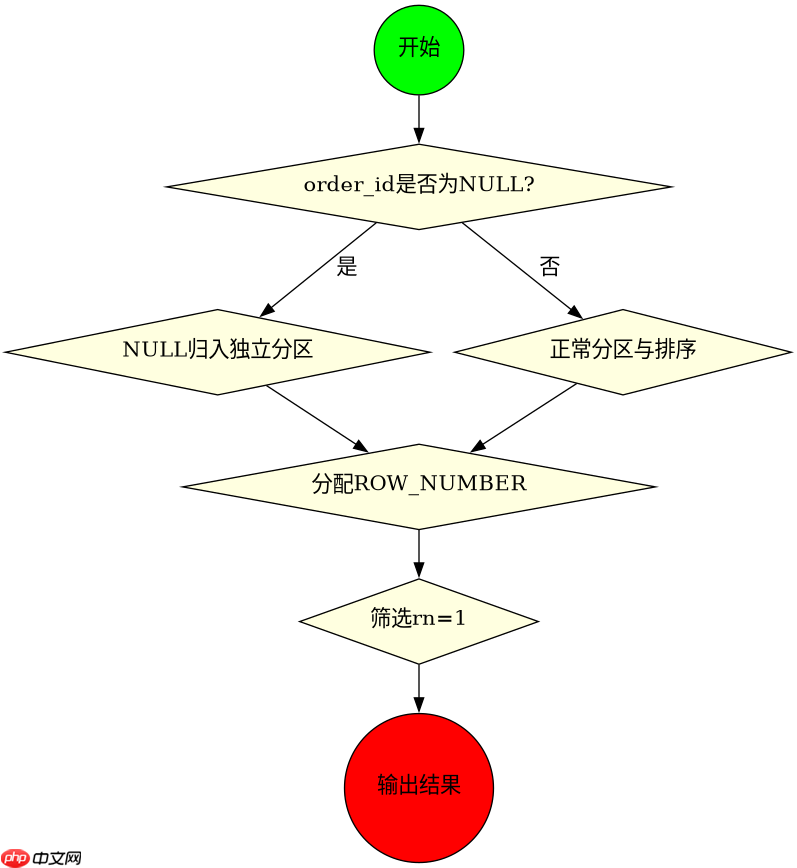
在Presto SQL中,ROW_NUMBER() 会将 NULL 视为一个独立的分区值。这意味着所有 order_id 为 NULL 的记录会被归入同一分区,并按 ORDER BY 规则排序。若未指定 ORDER BY,则顺序不确定;若指定了排序字段,则 NULL 值的排序位置遵循SQL标准(默认置于末尾或开头,取决于数据库实现)。因此,NULL 不会导致错误,但可能产生非预期的去重结果,需在业务层面显式处理。


















