








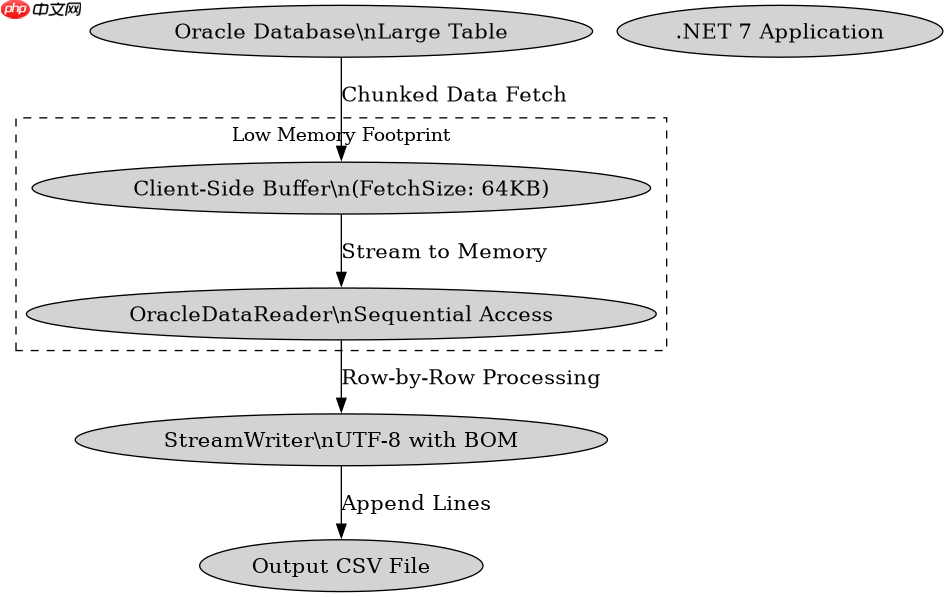
在.net 7中处理oracle大表数据导出为csv的内存瓶颈,核心做法是使用`oracledatareader`配合`commandbehavior.sequentialaccess`进行流式读取,并直接写入文件流,避免一次性加载所有数据到内存。具体实现时,需设置`fetchsize`参数以控制每次从数据库拉取的字节数,同时使用`streamwriter`按行或缓冲区写入csv文件。这样做可以确保无论表多大,内存占用始终保持在可控的低水平,仅取决于单次fetch的大小和当前处理的单行数据。

如何配置OracleDataReader以优化内存占用?
通过设置`FetchSize`属性和使用`SequentialAccess`行为,可以显著降低内存峰值。`FetchSize`指定了客户端缓存数据的最大字节数,默认值可能较大,对于大表应适当调小(如64KB或128KB),以便更频繁地释放已处理的数据块。`CommandBehavior.SequentialAccess`允许逐列读取大型LOB或字符串字段,防止整行数据被缓冲到内存中。结合`StreamReader`风格的读取逻辑,可以实现真正的流式处理。
using System;
using System.Data;
using System.IO;
using Oracle.ManagedDataAccess.Client;

class Program
{
    static void Main()
    {
        string connString = "User Id=myuser;Password=mypwd;Data Source=orclpdb1";
        string query = "SELECT * FROM large_table";
        string csvPath = @"C:\output\large_table.csv";

        using (var connection = new OracleConnection(connString))
        {
            connection.Open();
            using (var command = new OracleCommand(query, connection))
            {
                // 关键:设置FetchSize以减少内存缓冲
                command.FetchSize = 65536; // 64KB

                // 关键:使用SequentialAccess支持大字段流式读取
                using (var reader = command.ExecuteReader(CommandBehavior.SequentialAccess))
                {
                    using (var writer = new StreamWriter(csvPath, false, System.Text.Encoding.UTF8))
                    {
                        // 写入表头
                        for (int i = 0; i < reader.FieldCount; i++)
                        {
                            writer.Write(reader.GetName(i));
                            if (i < reader.FieldCount - 1) writer.Write(",");
                        }
                        writer.WriteLine();

                        // 逐行读取并写入CSV
                        while (reader.Read())
                        {
                            for (int i = 0; i < reader.FieldCount; i++)
                            {
                                object value = reader.GetValue(i);
                                string strValue = value == DBNull.Value ? "" : value.ToString();
                                // 简单CSV转义:包含逗号或换行的值加引号
                                if (strValue.Contains(",") || strValue.Contains("\n"))
                                    strValue = $"\"{strValue.Replace("\"", "\"\"")}\"";
                                writer.Write(strValue);
                                if (i < reader.FieldCount - 1) writer.Write(",");
                            }
                            writer.WriteLine();
                        }
                    }
                }
            }
        }
        Console.WriteLine("Export completed.");
    }
}
上述代码的预期结果是:程序启动后连接Oracle数据库,执行查询,然后逐行将数据追加到指定的CSV文件中。内存中仅保留当前正在处理的单行数据以及`FetchSize`指定的少量缓冲数据,从而避免OOM(Out Of Memory)错误。运行环境为.NET 7,依赖`Oracle.ManagedDataAccess.Core` NuGet包。

如何处理CSV中的特殊字符和编码问题?
在导出过程中,必须正确处理UTF-8编码以及CSV规范中的转义规则。Oracle数据库通常存储Unicode数据,因此输出CSV时应显式指定`Encoding.UTF8`,并在文件开头添加BOM(Byte Order Mark)以确保Excel等工具能正确识别中文等非ASCII字符。对于字段内容,若包含逗号、双引号或换行符,必须按照RFC 4180标准进行转义:用双引号包裹字段,并将内部的双引号替换为两个双引号。此外,对于`DBNull`值,应转换为空字符串而非抛出异常,以保证CSV结构的完整性。

// 针对上一节代码中Writer部分的改进片段
using (var writer = new StreamWriter(csvPath, false, new UTF8Encoding(true))) // true表示添加BOM
{
    // ... 表头写入 ...
    while (reader.Read())
    {
        for (int i = 0; i < reader.FieldCount; i++)
        {
            object value = reader.GetValue(i);
            string strValue = value == DBNull.Value ? "" : value.ToString();

            // 增强型CSV转义逻辑
            bool needsQuoting = strValue.Contains(",") ||
                                strValue.Contains("\"") ||
                                strValue.Contains("\n") ||
                                strValue.Contains("\r");

            if (needsQuoting)
            {
                strValue = $"\"{strValue.Replace("\"", "\"\"")}\"";
            }

            writer.Write(strValue);
            if (i < reader.FieldCount - 1) writer.Write(",");
        }
        writer.WriteLine();
    }
}
该段代码的预期结果是:生成的CSV文件以UTF-8 with BOM编码保存,Excel打开时中文显示正常。所有包含特殊字符的字段都被正确引用,不会破坏CSV的行结构。例如,若某字段值为`He said, "Hello"`,则输出为`"He said, ""Hello"""`,符合CSV标准。
当遇到Oracle LOB字段过大导致读取缓慢时如何解决?
如果表中包含`CLOB`或`NCLOB`等大对象字段,即使使用`SequentialAccess`,一次性读取整个LOB仍可能导致性能瓶颈或内存 spike。解决方案是启用`LOB`字段的流式读取,即不通过`GetValue()`获取完整字符串,而是使用`GetOracleLob()`方法获取`OracleLob`对象,然后调用其`Stream`属性进行分块读取。这样可以只将LOB的一部分加载到内存中进行处理,适合超大文本内容的导出。需要注意的是,这种方式会增加代码复杂度,需手动管理流的读取和拼接。
// 假设第3列是CLOB类型
if (i == 2) // CLOB列索引
{
    var lob = reader.GetOracleLob(i);
    if (lob.Length > 0)
    {
        using (var lobReader = lob.Stream)
        using (var textReader = new StreamReader(lobReader, Encoding.UTF8))
        {
            // 可选:限制读取长度或分块处理
            char[] buffer = new char[4096];
            int bytesRead;
            while ((bytesRead = textReader.Read(buffer, 0, buffer.Length)) > 0)
            {
                writer.Write(buffer, 0, bytesRead);
            }
        }
    }
}
else
{
    // 其他列正常处理
    object value = reader.GetValue(i);
    string strValue = value == DBNull.Value ? "" : value.ToString();
    // ... 转义逻辑 ...
    writer.Write(strValue);
} 


















