








判断中文乱码发生在读取时还是显示时,核心在于检查程序内部内存中的字符串对象是否已经损坏。如果从文件流或网络读取后,直接打印该字符串的字符编码(如 utf-8 字节序列)或长度出现异常,说明乱码发生在读取阶段;如果内部字符串正常,但在控制台、网页或 ui 控件中显示为问号或方块,则说明是显示环境编码不匹配导致的。

如何验证读取阶段的编码是否正确
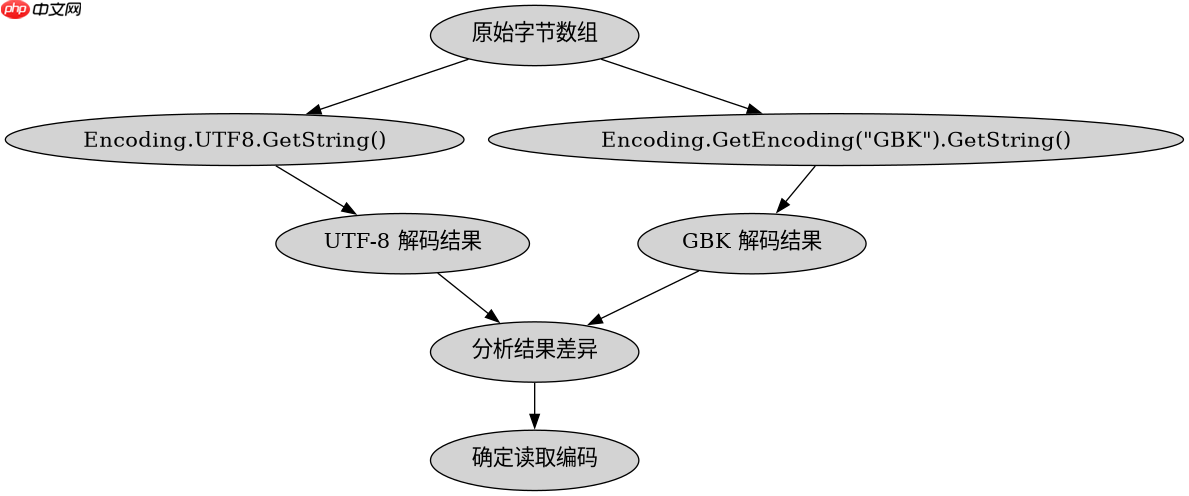
要确认读取环节是否出错,需要绕过默认解码逻辑,直接检查原始字节流并尝试用不同编码重新解析。在 C# 中,可以使用 Encoding.GetEncoding() 或 Encoding.UTF8 等类来显式指定解码方式。通过对比不同编码下的解码结果和字节长度,可以定位问题源头。
using System;
using System.IO;
using System.Text;

// 假设有一个包含中文的文件 test.txt
string filePath = "test.txt";

// 1. 读取原始字节
byte[] rawBytes = File.ReadAllBytes(filePath);
Console.WriteLine($"原始字节数: {rawBytes.Length}");
Console.WriteLine($"原始字节 Hex: {BitConverter.ToString(rawBytes)}");

// 2. 尝试用 UTF-8 解码
try {
    string utf8Str = Encoding.UTF8.GetString(rawBytes);
    Console.WriteLine($"UTF-8 解码结果: {utf8Str}");
    Console.WriteLine($"UTF-8 字符数: {utf8Str.Length}");
} catch (Exception ex) {
    Console.WriteLine($"UTF-8 解码失败: {ex.Message}");
}

// 3. 尝试用 GBK 解码 (常见于旧系统)
try {
    string gbkStr = Encoding.GetEncoding("GBK").GetString(rawBytes);
    Console.WriteLine($"GBK 解码结果: {gbkStr}");
    Console.WriteLine($"GBK 字符数: {gbkStr.Length}");
} catch (Exception ex) {
    Console.WriteLine($"GBK 解码失败: {ex.Message}");
}

// 4. 检查 BOM (Byte Order Mark)
if (rawBytes.Length >= 3) {
    if (rawBytes[0] == 0xEF && rawBytes[1] == 0xBB && rawBytes[2] == 0xBF) {
        Console.WriteLine("检测到 UTF-8 BOM");
    } else if (rawBytes[0] == 0xFF && rawBytes[1] == 0xFE) {
        Console.WriteLine("检测到 UTF-16 LE BOM");
    }
}
运行上述代码后,观察输出。如果 UTF-8 解码结果 显示为乱码(如 “ä¸å›½”),而 GBK 解码结果 显示正常(如 “中国”),则说明文件是以 GBK 编码保存的,但程序默认按 UTF-8 读取,导致读取阶段就发生了乱码。反之,如果两种编码解码后都正常,或者只有一种能正确显示且符合预期,则读取阶段可能无误。

如何排查显示环境的编码问题
当内部字符串对象已正确解码时,乱码通常由显示终端的编码设置引起。C# 控制台应用程序默认使用操作系统的当前代码页(如 Windows 中文版可能是 GBK/CP936,Linux/macOS 通常是 UTF-8)。如果程序内部是 UTF-8 字符串,但控制台期望 GBK,就会显示乱码。解决方法是统一控制台输出编码与程序内部编码一致。

using System;
using System.Text;

// 模拟一个正确的 UTF-8 字符串
string correctString = "测试显示";

// 1. 查看当前控制台输出编码
Console.WriteLine($"当前控制台输出编码: {Console.OutputEncoding.EncodingName}");

// 2. 强制设置控制台输出编码为 UTF-8
Console.OutputEncoding = Encoding.UTF8;
Console.WriteLine($"修改后控制台输出编码: {Console.OutputEncoding.EncodingName}");

// 3. 输出字符串
Console.WriteLine(correctString);

// 4. 验证:将字符串转为 UTF-8 字节再转回,确保无损
byte[] utf8Bytes = Encoding.UTF8.GetBytes(correctString);
string roundTrip = Encoding.UTF8.GetString(utf8Bytes);
Console.WriteLine($"Round-trip 验证: {roundTrip == correctString}");

// 5. 如果是 Web 应用,检查 Response 编码
// HttpContext.Current.Response.ContentEncoding = Encoding.UTF8;
// 或在 HTML 头中添加: <meta charset="UTF-8">
执行此段代码,首先查看 Console.OutputEncoding 的初始值。如果初始值是 "Unicode (UTF-8)" 但依然乱码,可能是终端模拟器本身配置错误。如果初始值是其他编码(如 "简体中文 (GB2312)"),而输出内容显示为乱码,则在代码中显式设置 Console.OutputEncoding = Encoding.UTF8 即可解决。对于 Web 应用,需确保 HTTP 响应头中的 Content-Type 包含 charset=utf-8,且 HTML 文档头部声明了 <meta charset="UTF-8">。
基于程序中某个输入、条件或结果的具体问题
当程序处理混合编码文件或用户输入时,常遇到因未检测 BOM 或忽略空值导致的隐式乱码。例如,读取带有 UTF-8 BOM 的文件时,若未正确处理,第一个字符会多出一个不可见的零宽无间断空格(\uFEFF),影响后续字符串比较或数据库插入。此外,当输入为空字符串或 null 时,直接调用 GetString() 不会报错,但可能导致业务逻辑误判。因此,在处理任何外部文本输入前,应先检查字节数组是否为空,并剥离 BOM 标记,以确保内部字符串纯净。

















