








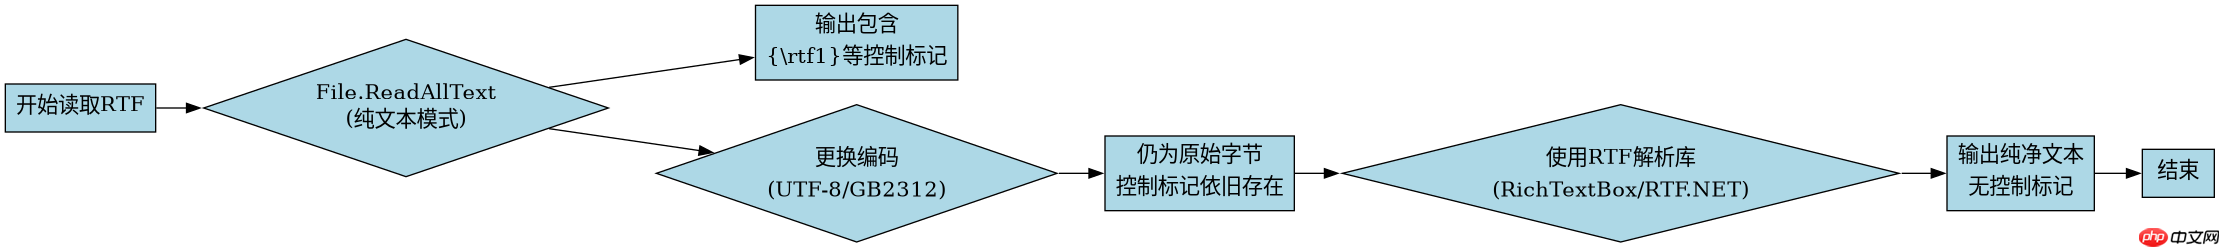
读取rtf文件时出现控制标记是因为使用了纯文本方式(如 file.readalltext)直接读取,这种方式无法解析rtf的语法结构,只会把内容当作普通字符串处理。要解决这个问题,必须使用支持富文本格式的库或组件来解析文件,而不是依赖系统默认的文本编码转换。
为什么换文本编码没有用?
更换文本编码(如从 UTF-8 切换到 GB2312)之所以无效,是因为RTF中的控制标记(如 {\rtf1}、{\fonttbl})是语法结构的一部分,而非单纯的字符编码问题。无论使用何种编码,只要不经过RTF解析器,这些标记就会作为原始字节序列被读取出来,表现为乱码或可见的控制符。
using System;
using System.IO;

namespace RtfReaderDemo
{
    class Program
    {
        static void Main()
        {
            string rtfPath = "sample.rtf";
            // 错误做法:直接以文本形式读取,导致控制标记暴露
            string rawContent = File.ReadAllText(rtfPath, System.Text.Encoding.UTF8);
            Console.WriteLine("Raw Content:");
            Console.WriteLine(rawContent);
        }
    }
}
上述代码展示了直接使用 File.ReadAllText 的后果。即使指定了正确的编码,输出的结果依然包含 {\rtf1\ansi} 等控制标记,因为该方法仅负责字节到字符的转换,不具备解析RTF语法的逻辑。

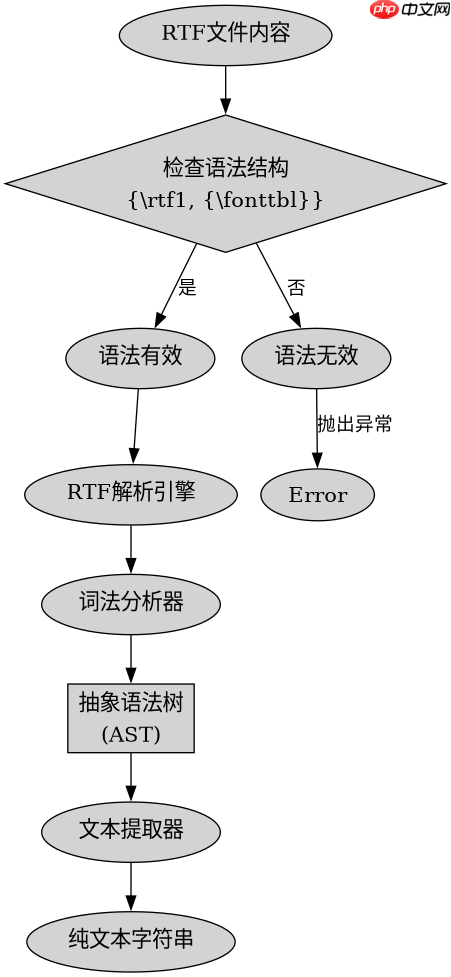
如何正确解析RTF并提取纯文本?
在C#中,最可靠且无需引入第三方重型库的方法是借助Windows自带的 RichTextBox 控件或其背后的 RichTextBox.FindForm() 机制,但更轻量级的方案是使用 Microsoft.WindowsAPICodePack 或直接调用 IRichEditOleCallback 接口,不过对于大多数场景,推荐使用开源库如 RichTextSharp 或 RTF.NET。这里演示一个基于 System.Windows.Forms.RichTextBox 的简单解析方法(需在Windows Forms项目中引用):
using System;
using System.Windows.Forms;
using System.IO;

namespace RtfParserDemo
{
    class Program
    {
        static void Main()
        {
            string rtfPath = "sample.rtf";
            string plainText = ExtractPlainTextFromRtf(rtfPath);
            Console.WriteLine("Extracted Plain Text:");
            Console.WriteLine(plainText);
        }

        static string ExtractPlainTextFromRtf(string rtfFilePath)
        {
            using (var rtb = new RichTextBox())
            {
                rtb.Rtf = File.ReadAllText(rtfFilePath);
                return rtb.Text;
            }
        }
    }
}
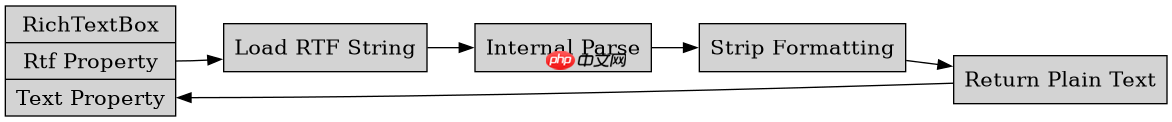
该程序通过 RichTextBox 的 Rtf 属性加载文件,然后利用其 Text 属性获取纯文本内容。这种方法会自动忽略所有格式和控制标记,只保留用户可见的文本。注意,此方法需要在支持GUI的环境中运行,或者在非UI线程中使用特定的COM互操作技巧,但在控制台应用中直接实例化 RichTextBox 可能会因缺少消息循环而失败,因此生产环境建议优先使用纯C#实现的RTF解析库。
解析后文本中是否还残留特殊字符?
使用 RichTextBox 解析后,大部分控制标记会被移除,但某些RTF特有的符号(如非断空格 或特定字体映射的字符)可能会被转换为Unicode等效字符。如果源RTF文件中包含未定义的字体或样式,解析器可能会尝试近似替换,导致文本中出现不可见字符或占位符。此外,如果RTF文件损坏或格式不规范,解析过程可能抛出异常或返回截断的文本。

















